最后才给一分,前面每一步都应该同样被表扬吗?
成功里可能藏着无效动作
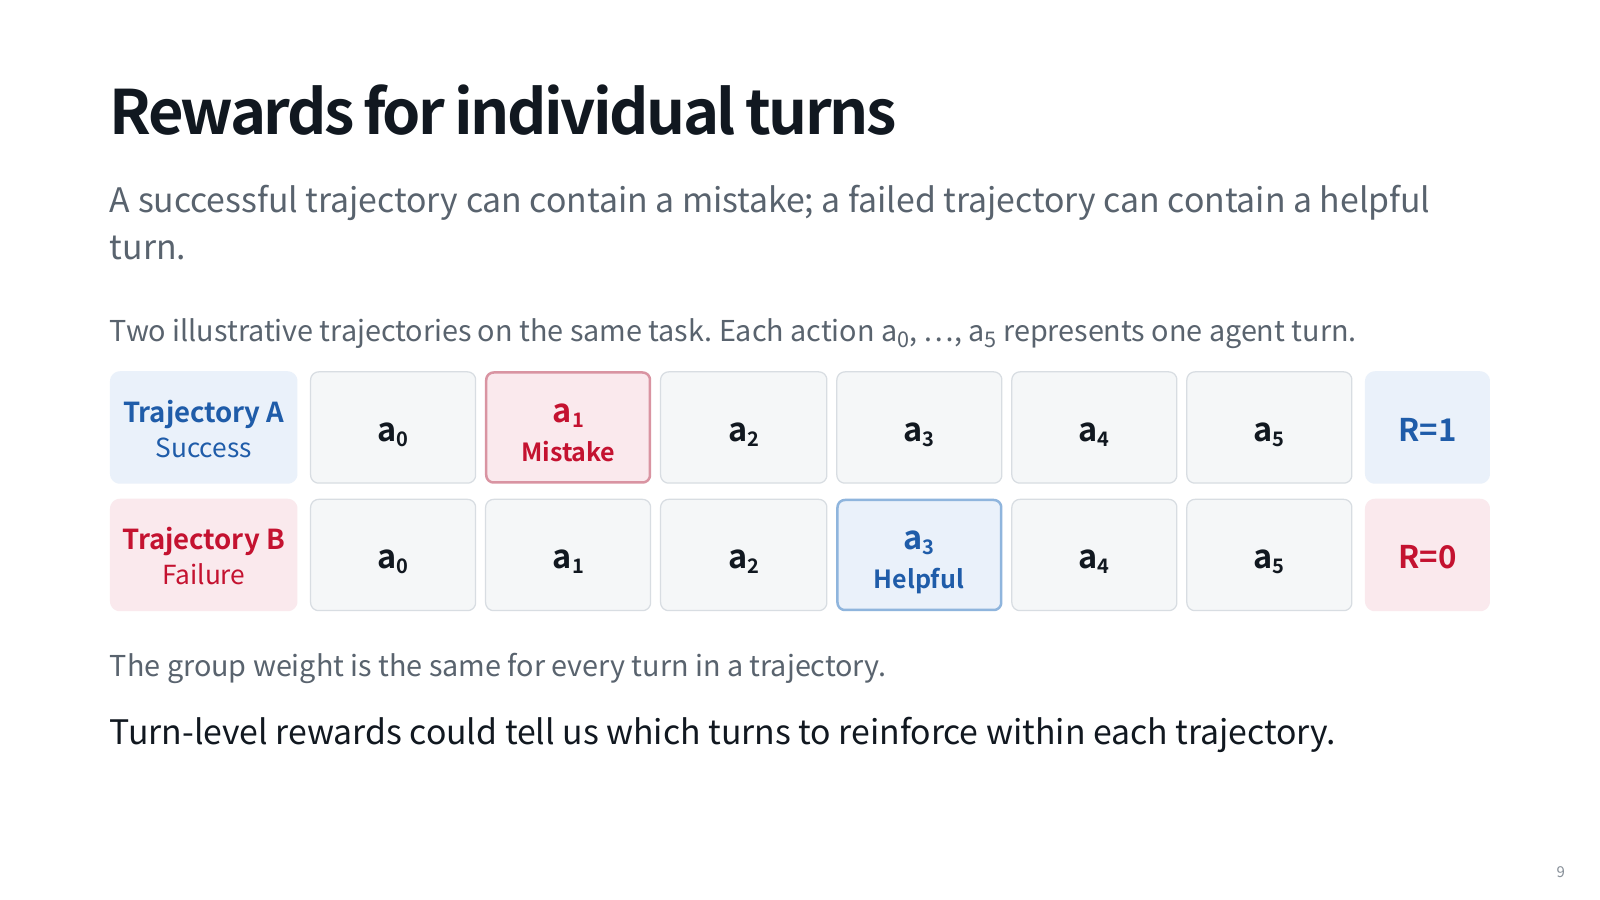
想象采购Agent先查到正确库存,却又查同一个文件两次,最后仍报对了价格。任务奖励为1。如果用终局奖励减去基线得到0.5,再把0.5分给每一个动作,就连两次多余查询也得到同样的正权重。反过来,一条最后失败的轨迹可能前面已经正确定位数据,只在最后算错乘法。
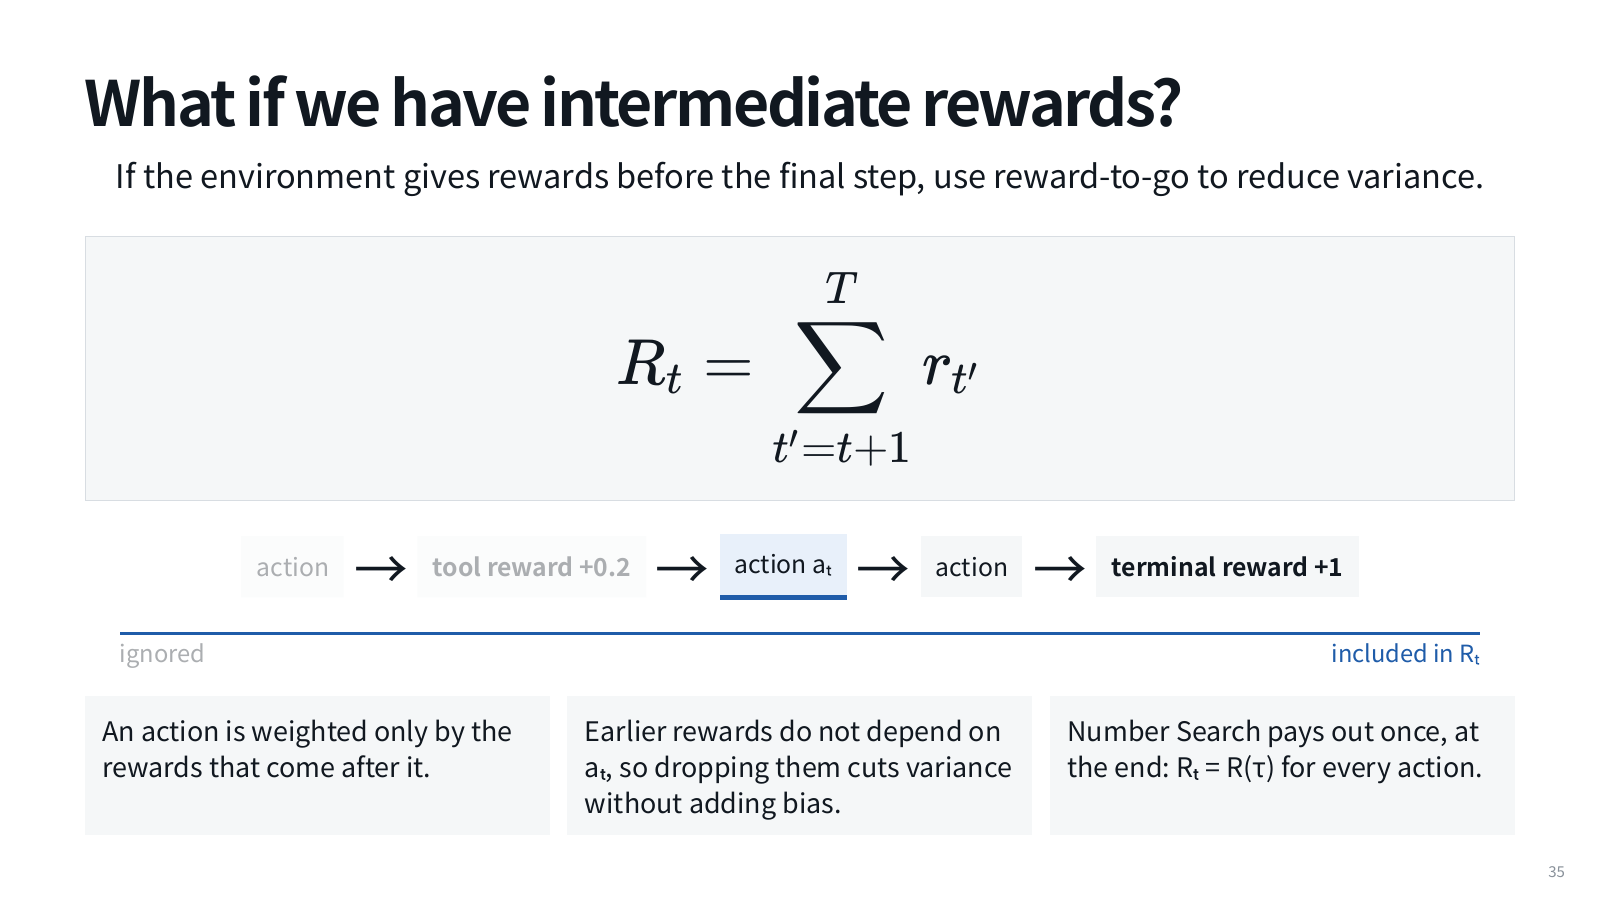
这就是信用分配:怎样把结果与此前的选择关联。先不要期待一个算法自动看穿因果。本课先做一件较小、可以证明为什么合理的事:对某一步,只累计它之后的奖励,称为未来回报或 reward-to-go。它能去掉无关的过去奖励,减少估计噪声,但不会自动判定每个动作的真实因果贡献。
先用三个奖励把时间顺序算清
设三个动作依次获得奖励 0.2、0、1,奖励写在对应动作之后。若不折扣,第一个动作的未来回报是 0.2+0+1=1.2;第二个是 0+1=1;第三个是1。第二个动作不再承担已经发生的0.2,因为它不能改变过去已经发放的奖励。
若使用折扣率γ=0.9,第一个动作回报为 0.2+0.9×0+0.9²×1=1.01;第二个是 0+0.9×1=0.9;第三个仍是1。γ是每往后一个时间步乘一次的权重,不是把整条轨迹统一乘0.9。γ小于1会改变时间偏好;不能把它当作无条件正确的数值技巧。
如果所有奖励都在最后呢?
把上例前两次奖励都改成0。γ=1时三个动作的未来回报都是1。这正是很多Agent任务的情况:最后测试通过或交付达标才得分。仅换成reward-to-go,并不能知道第二次重复读文件是浪费的。
你可以加入每次工具调用的费用,例如每次扣0.05。三次调用成功时累计净回报为 1−3×0.05=0.85;五次调用则为0.75。这会给效率一个训练信号,但同时改变任务目标。如果有些困难任务确实需要更多查询,过重费用可能诱导模型过早回答。奖励设计是在表达取舍,不是在给同一个目标免费增加信息。
另一条路是训练价值函数,估计当前历史下还可能获得多少回报,再用一步之后的变化构造优势;还可以使用过程奖励模型对中间步骤评分。但预测器和过程评分也会犯错,不能把一个模型判断当成真实因果标签。第48课会用价值估计0.3到0.6的变化继续算。
沿时间轴倒推回报
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
奖励0.2、0、1,γ=1
- 1. 末步
G₂=1。
- 2. 倒推一步
G₁=0+1=1,忽略过去的0.2。
- 3. 再倒推
G₀=0.2+1=1.2。
G₂=1。
先预测,再核对结果与原因
三个动作的回报为1.2、1、1。过去奖励与后来的动作无因果时间依赖,不必放进后一步权重。
末尾奖励怎样回到前面的动作
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- G₃ = r₃ = 1
- G₂ = r₂ + γG₃ = 0 + 0.9 × 1 = 0.9
- G₁ = r₁ + γG₂ = 0 + 0.9 × 0.9 = 0.81
这是 reward-to-go 的直接计算;它不是 critic 的预测,也没有扣除基线。
判断公式中的每个位置
写 G_t=r_{t+1}+γG_{t+1} 时,t指当前动作位置,r_{t+1}是它之后得到的奖励,G_{t+1}是从下一步继续的回报。终止后没有未来奖励,终止状态的继续回报设为0。这个边界要在实现里明确,否则会把别的episode的奖励串进当前样本。
若工具暂时失败但episode仍可重试,它不是任务终止;若预算耗尽导致真正截断,则还要区分环境终止与时间限制是否应该bootstrap。教学小例子只计算明确结束的轨迹,实际训练需要把终止原因写入数据,否则同样一串数字会被赋予不同目标。
这节课的验收不是背出“信用分配”四个字,而是能对每个动作圈出其可影响的未来奖励,算出γ的幂次,并解释你加入步骤费用后优化目标怎样变。本课锚点:未来回报去掉无关的过去,精细信用仍需要更多信息或假设。 下一课会在同一个任务的多次尝试之间建立比较基准。
给早期动作打分,并不等于知道因果责任
假设轨迹先正确读取库存,再错误解析列,最后输出错误文件。早期读取后仍然失败,蒙特卡洛回报会把后面的坏结果带给读取动作;这不证明读取本身有害。若在类似历史下换另一种解析就成功,差别才帮助我们定位责任。回报到未来解决了过去奖励混入的问题,却没有完全解决同一轨迹内动作贡献的因果分离。
这也解释了为什么过程反馈需要验证。额外给“读取成功”0.2分能增加密集信号,但如果允许反复读取反复得分,模型可能用循环累积分数。设计时要说明奖励是否一次性、总预算与终止规则,并检查最终任务成功仍是主要目标。更密的分数只是更频繁的信息,不自动更真实。
用自己的话核对一次
奖励0、0、1且γ=0.9,三个动作的回报是多少?
展开解释
从后向前是1、0.9、0.81;按动作顺序写为0.81、0.9、1。远期奖励每跨一步多乘一次γ。
把工具费加入奖励为什么不是纯粹的数学整理?
展开解释
它改变了优化目标:不仅要成功,还要节省调用。费用过高可能鼓励少查证据或过早结束,必须用困难任务验证取舍。
为什么reward-to-go不等于因果贡献评分?
展开解释
它只按时间去掉已经发生的奖励,仍会将之后的好结果分给多个动作;其中某一步可能并非必要,需更细信息和假设才能判断。