奖励都是正数,为什么有的成功轨迹反而要降低概率?
“得了分”还不够,要问通常能得多少
继续上课的动作概率。假设任务奖励不再只有成败:回答正确、引用完整、成本较低会综合得到 0 到 1 的分数。当前策略通常能拿 0.8,这次只拿 0.6。若只看到“0.6大于零”就加强整条轨迹,模型会同时加强优于常态和劣于常态的尝试,很难表达我们真正关心的相对表现。
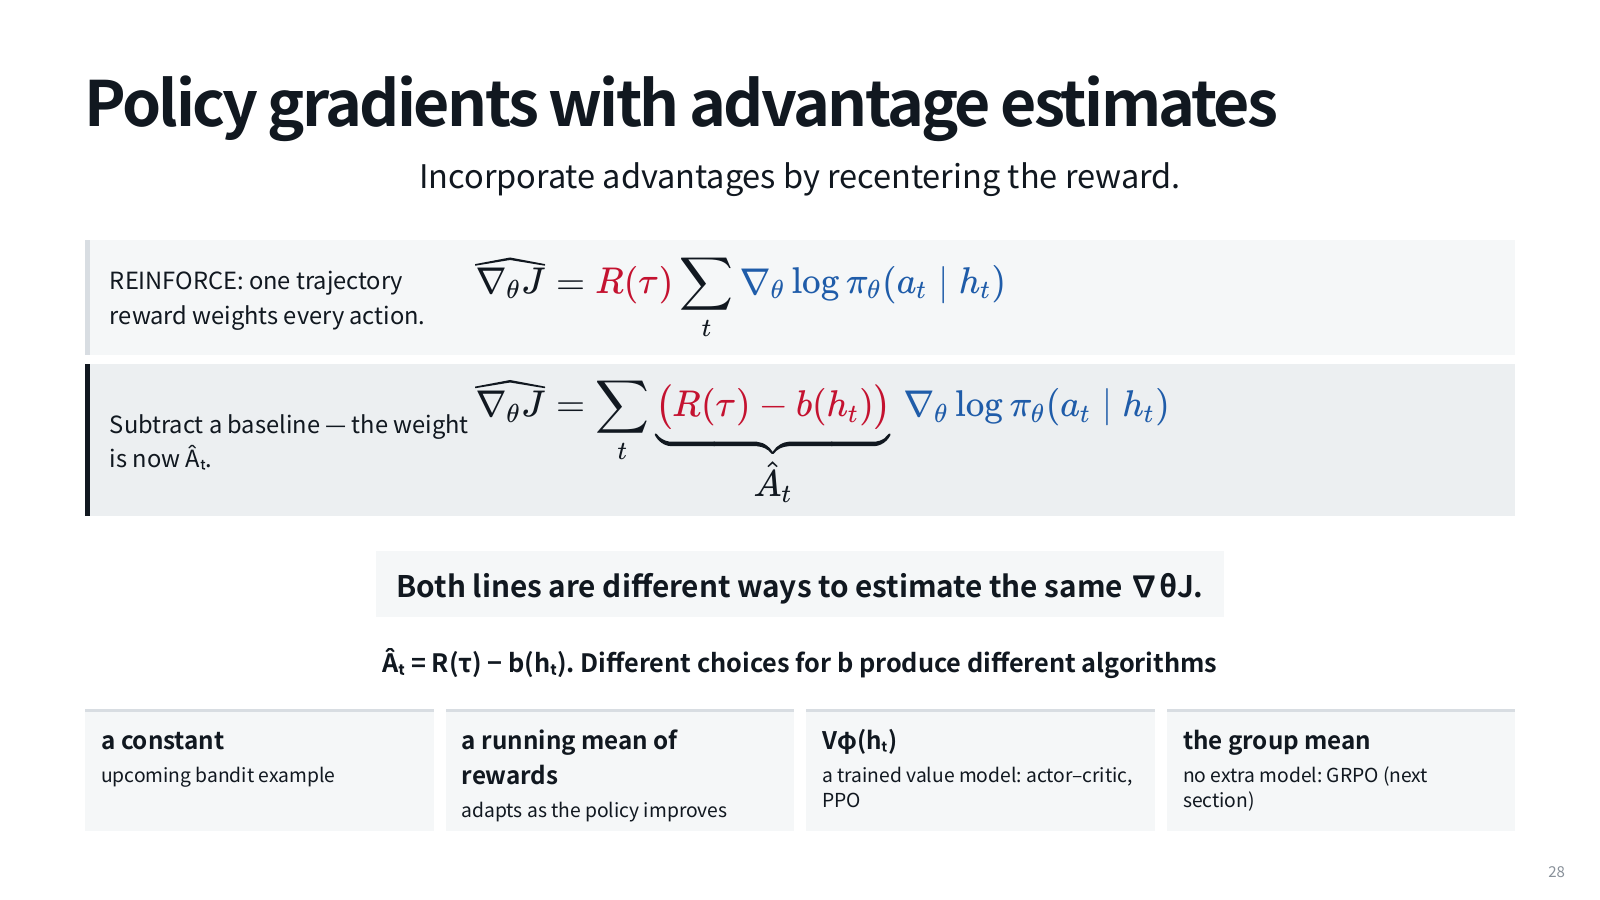
先引入基线 b:它估计在相同条件下通常能获得的回报。优势的最简单写法是 A=R−b。奖励 R 回答“这次得多少”,基线 b 回答“原本预期多少”,差值回答“比预期好多少”。0.6−0.8=−0.2,所以这条有正奖励的轨迹也可以带负权重。负优势不是宣布任务完全失败,而是降低相对较差动作的支持。
用二动作例子算一遍方向
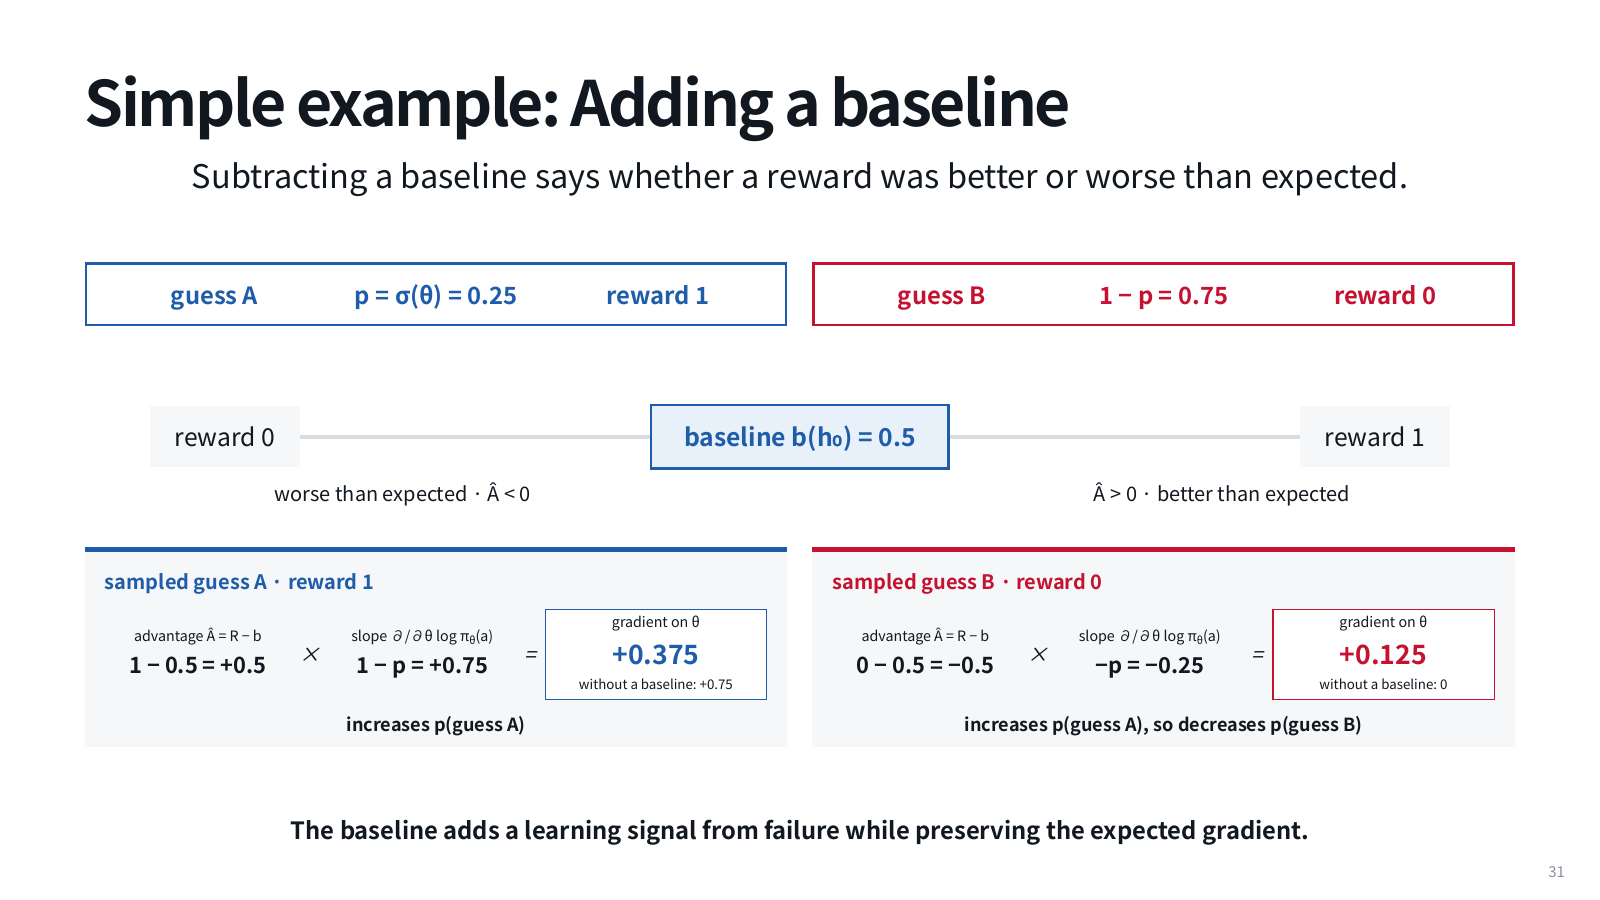
设 p(A)=0.25,A被采样时的对数概率斜率为0.75。若奖励1、基线0.5,优势0.5,更新方向为 0.5×0.75=+0.375。与不减基线的0.75相比,方向相同、幅度变小,因为成功里有一部分本来就应该做到。
若采样到B,奖励0、基线仍0.5,优势为−0.5。B的斜率为−0.25,于是方向 −0.5×−0.25=+0.125。θ上升会提高A、降低B,因此这次失败给出了有用的改进方向。这里两个负号相乘为正,不是系统弄反了惩罚。
为什么减掉一个数不会随意改变目标?
在给定历史h、基线不依赖这一步采样动作的理想设定下,基线项的期望为零:各动作概率乘各自的对数概率梯度求和,等于概率总和1的梯度,即0。因此减基线可以改变单个样本的权重、减少方差,而不改变所估计的期望梯度。
这里有两个容易漏掉的条件。第一,是对动作分布取期望,单条轨迹的数值当然会变。第二,基线的构造要与估计方式相容。用包含自身奖励的有限组均值,会引入有限样本缩放等问题;不同算法采用组均值、留一估计或学习价值函数,各有处理方式。我们不能把一句“减任意基线都无偏”推广到任意依赖动作和样本的数。
把奖励与比较基准分开
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
R=0.6,b=0.8,采样动作A的斜率0.75
- 1. 计算优势
0.6−0.8=−0.2。
- 2. 乘动作梯度
−0.2×0.75=−0.15。
- 3. 解释方向
梯度上升使θ下降,A概率受到压低。
0.6−0.8=−0.2。
先预测,再核对结果与原因
有正奖励,但相对更新为负。当前基线代表比这次更好的通常表现。
同组奖励怎样变成优势
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- 奖励 [0, 0, 1, 1],均值 = (0 + 0 + 1 + 1) / 4 = 0.5
- 减均值 = [-0.5, -0.5, 0.5, 0.5];总体标准差 = 0.5
- 再除标准差(下限 10⁻⁸)→ [-1, -1, 1, 1]
这里演示组内奖励标准化版本。省略标准差的实现数值不同;同组全相同时没有相对优势信号。
基线好不好,不能只看它数值大不大
基线若长期过低,很多普通轨迹仍有正优势;若预测噪声很大,减完未必降低方差。理想上它与当前历史的预期回报接近。任务难度也重要:简单任务0.8可能很差,困难任务0.6可能很好,因此把所有任务混用同一常数并不总是合适。
把本次奖励保持0.6,只把基线从0.8改成0.4,优势就从−0.2变成+0.2。结果翻转不是奖励被篡改,而是比较的预期变了。这个实验帮助你发现:阅读算法报告时,必须同时看奖励定义与基线定义,不能只截一张奖励曲线就解释更新方向。
还有一个边界:把同一个轨迹级优势分配给整条轨迹,并没有辨别每个动作的功劳。一次好于平均的成功,仍可能夹着无效查询。基线主要解决“相对表现”和梯度估计噪声,下一课讨论更细的时间信用,不能把二者当成同一个问题。
在采购Agent项目里,你要先固定奖励口径,例如正确报价而不是主观措辞;再记录每条轨迹的奖励、基线和优势。抽一条正奖励负优势的样本,能解释它为什么低于预期,才算数据可审查。本课锚点:优势衡量比预期好多少,不等于奖励的另一个名字。
用期望把“基线不改变方向”真正验一遍
无基线时,按采样概率平均的梯度是 0.25×0.75+0.75×0=0.1875。加常数0.5后是 0.25×0.375+0.75×0.125=0.09375+0.09375=0.1875。单次抽到A的更新变小,抽到B也有更新,但平均目标方向一致。这正是把信号从稀少成功重新分配到失败样本的直观效果。
这个核对依赖基线不随着当前采到A或B而任意改变。如果人为规定“采到A就用基线0,采到B就用基线1”,上面的抵消不再成立。历史依赖基线可以有意义,但当前动作依赖项需要额外理论处理,不能把所有减去的数都称为无偏基线。
用自己的话核对一次
正奖励为何可能对应负优势?
展开解释
因为奖励可能低于同一条件下的基线,例如0.6−0.8=−0.2。它仍有一些回报,但不如通常表现。
减基线保持什么不变?
展开解释
在合适的动作独立基线与采样条件下,保持期望策略梯度;不是保持每条轨迹的梯度数值。有限组基线的实现还需检查相应偏差或缩放。
基线是否已经知道成功轨迹里的哪一步是多余的?
展开解释
没有。轨迹级基线只提供相对权重。若整条轨迹共享优势,多余步骤仍可能被共同强化,需要更细的信用分配或目标设计。