GRPO 为什么要对同一个问题多试几次?
不是让四个模型开会,而是建立比较组
上一课有了奖励和优势,现在还缺一个便宜的基线。若每个历史都训练一个价值模型,要增加预测与拟合成本。GRPO的一种思路是:对同一任务,让策略采样多条轨迹,用组内结果估计“这个策略通常能做到什么”。这些尝试可以由同一个模型独立采样,并不要求四个不同模型相互讨论。
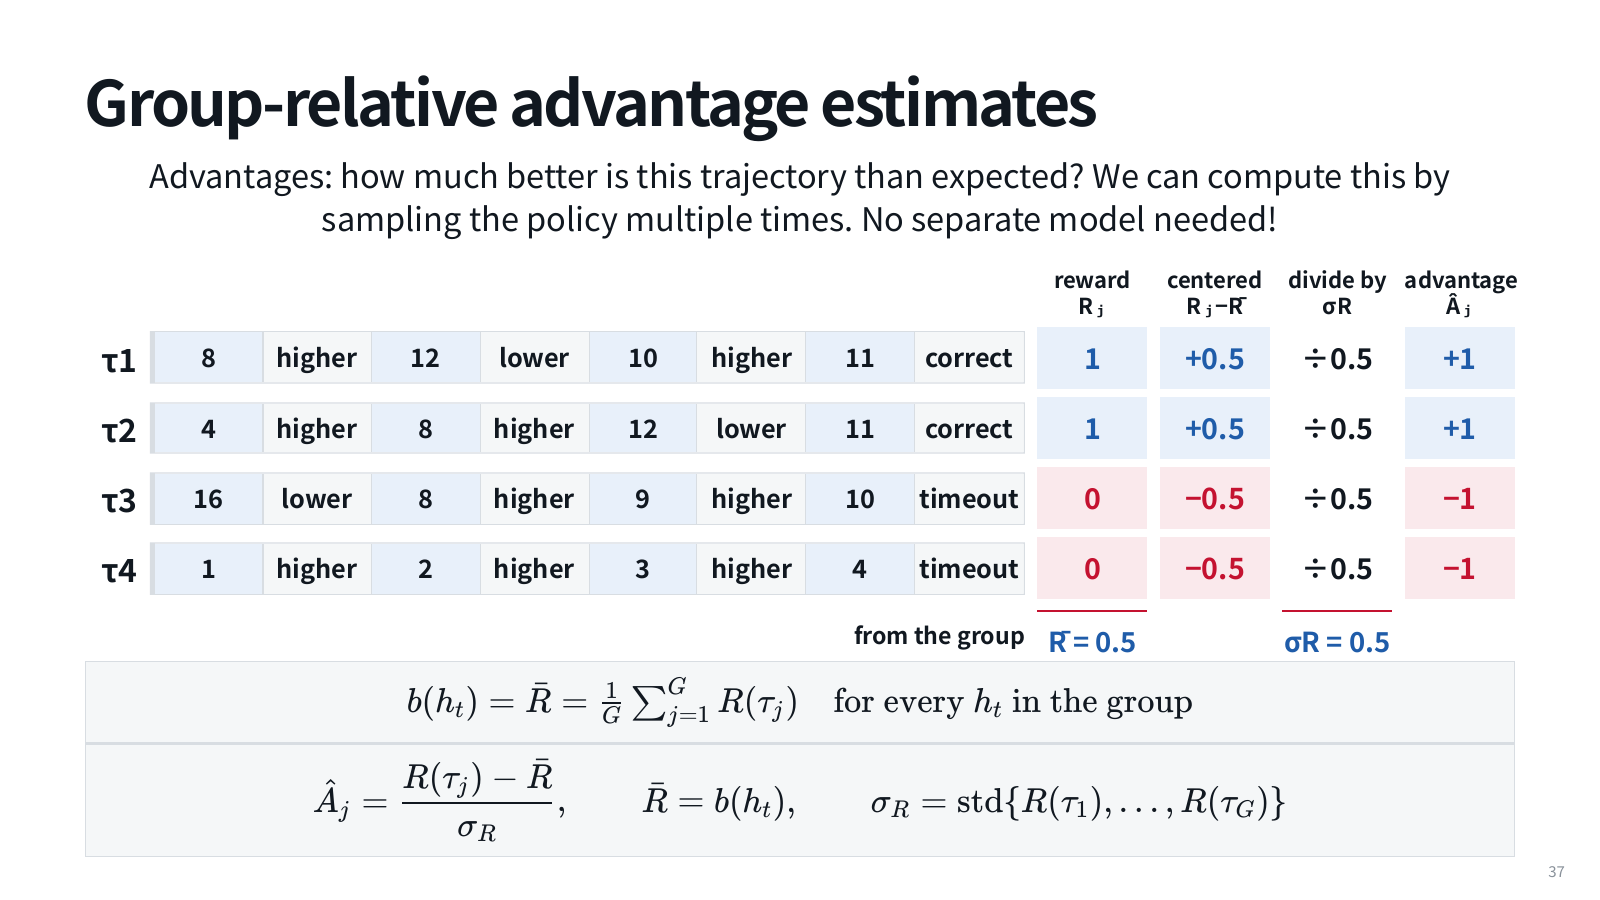
沿用猜数任务,固定隐藏数字与步数预算,采样四次得到奖励 1、1、0、0。组内均值 R̄=(1+1+0+0)/4=0.5。减均值后,成功轨迹权重是0.5,失败轨迹权重是−0.5。分组的关键是任务相同:把一个简单问题的成功与一个极难问题的失败直接当作同组比较,会混入任务难度差异。
每一项为什么出现在公式里
原课展示的标准化形式是 A_j=(R_j−R̄)/σ_R。R_j是第j次尝试的奖励;减去组均值表示相对表现;除以组标准差调节这组奖励的尺度。对这四个奖励,采用总体标准差口径,四个偏差平方都是0.25,平均后为0.25,开方得到σ=0.5,因此优势为 1、1、−1、−1。
如果使用样本标准差,分母采用G−1,数值会不同。因此手算和实现必须先声明标准差定义。这里按原页的0.5复现,不能把任意库函数默认值当作算法规范。实现中还通常要处理分母为零或极小值,但加一个ε只解决数值除零,不会凭空创造奖励差异。
DrGRPO 改的是权重,不是把任务奖励改写了
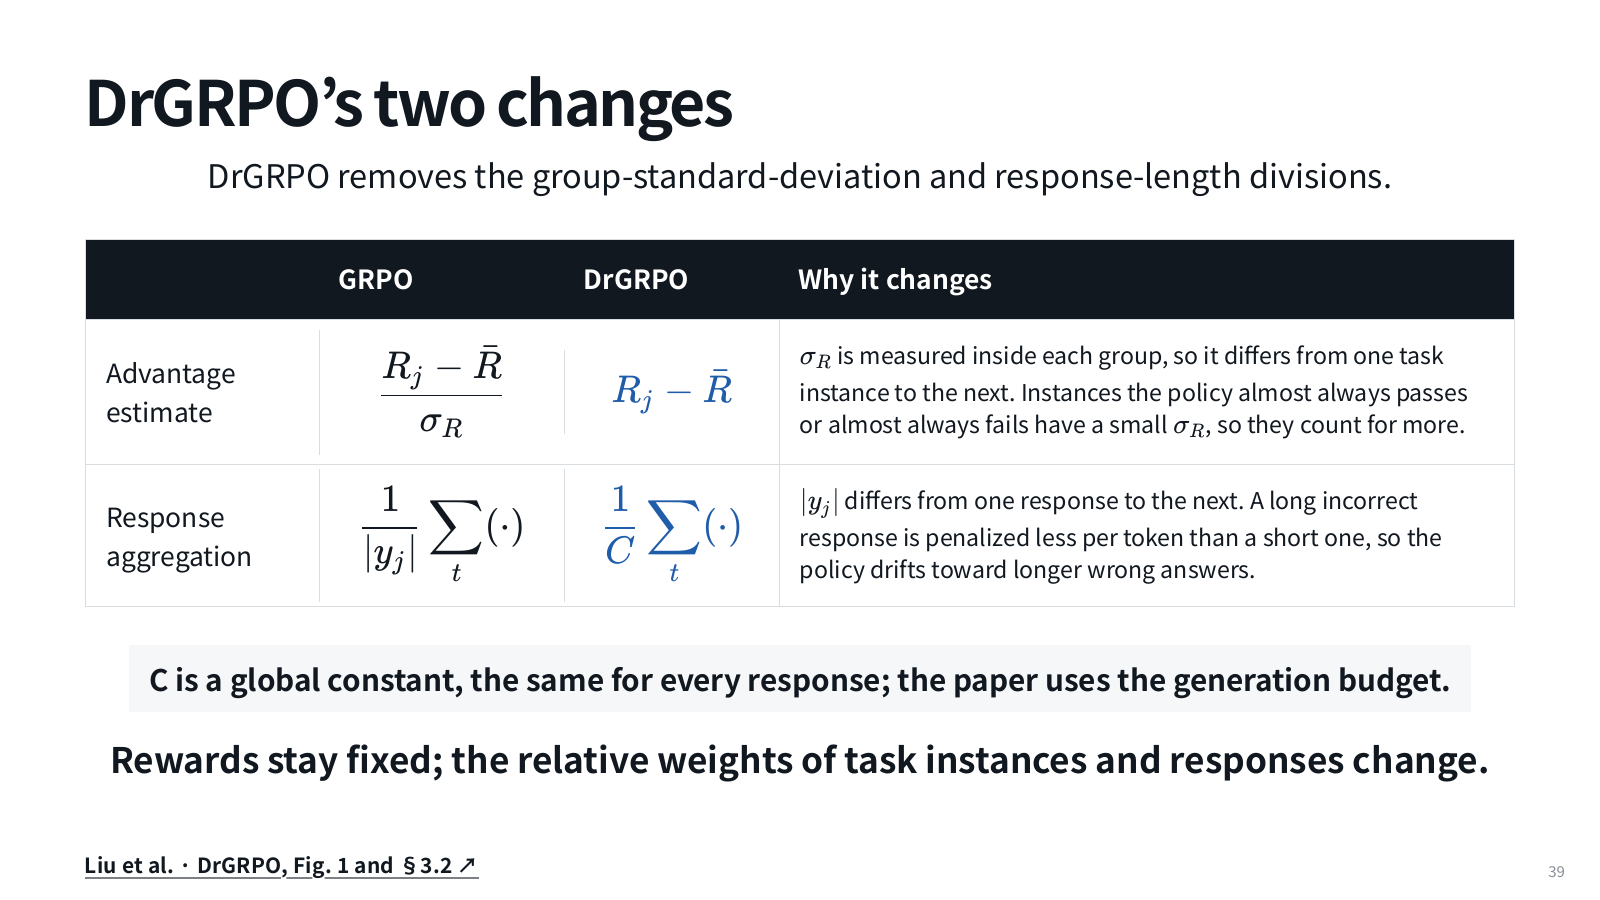
原课接着比较DrGRPO:去掉组标准差归一化,并把按每条响应长度平均的方式改为共享常数归一化。于是前例优势仍为 0.5、0.5、−0.5、−0.5,不再变成±1。它们方向一致,但尺度不同;不同任务的组内标准差不同,去掉分母会改变各任务相对权重,而不只是给所有样本乘一个共同常数。
响应长度是第二个不同维度。若一个错误响应长100 token,另一个长10 token,逐响应除以各自长度会改变每个token的惩罚幅度。改用同一常数C,会改变长短响应的相对贡献。不要把“去标准差”和“去长度归一化”混成同一操作,更不能看到名字GRPO就假设所有实现完全一致。
一组尝试如何产生优势
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
奖励1、1、0、0,按总体标准差
- 1. 组均值
4个奖励总和2,均值0.5。
- 2. 中心化
得到0.5、0.5、−0.5、−0.5。
- 3. 标准化
标准差0.5,得到1、1、−1、−1。
4个奖励总和2,均值0.5。
先预测,再核对结果与原因
存在可比较的正负信号。同一任务的不同尝试提供相对好坏。
同组奖励怎样变成优势
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- 奖励 [0, 0, 1, 1],均值 = (0 + 0 + 1 + 1) / 4 = 0.5
- 减均值 = [-0.5, -0.5, 0.5, 0.5];总体标准差 = 0.5
- 再除标准差(下限 10⁻⁸)→ [-1, -1, 1, 1]
这里演示组内奖励标准化版本。省略标准差的实现数值不同;同组全相同时没有相对优势信号。
两个会让直觉失效的组
第一组全是0。均值0,所有中心化优势为0;标准差也为0。没有相对差异,就没有这项组内学习信号。第二组全是1,也会全部为0。前者可能太难、评价器错了或探索不足;后者可能已学会,也可能有泄漏或奖励漏洞。数学上都是退化组,诊断却不同。
再把奖励改成 1、0、0、0。均值0.25,总体标准差约0.433,成功优势约1.732,三个失败约−0.577。罕见成功的标准化权重更大。这不意味着任务自动更重要,而是归一化造成的效果;不除标准差时权重则是0.75和−0.25。计算器与回放帮助你把两个口径分开核对。
实际决策要记录组大小、退化组比例、优势定义、响应归一化、采样预算与留出效果。多采样不一定更划算:如果四条轨迹几乎相同,多付出的成本没有带来新的比较信息。本课锚点:同任务多次尝试给出相对基准;归一化选择决定这个基准怎样进入更新。
响应长度的影响也能用小数看见
考虑两条错误响应,优势都为−0.5,一条10个动作token,一条100个动作token。先假设每个token的局部梯度项大小相同,便于只看聚合权重。逐响应除以自身长度时,每个token权重分别为−0.05与−0.005,长响应单token惩罚小十倍;若共同除以C=100,每个token都是−0.005,但长响应有十倍数量的项。
这不是说长响应一定应该惩罚十倍,因为真正梯度项并不同,任务也可能需要长解。它说明两个归一化实现即使使用同一奖励和同一优势,也不是同一优化目标。复现实验必须报告token聚合口径;仅在配置里写GRPO不足以确定行为。
用自己的话核对一次
为什么要把同一个问题的多次尝试放在一组?
展开解释
主要为了在相近任务条件下估计相对表现,减少难度差异混入基线。组仍受有限样本和采样相关性影响。
四个奖励1、1、0、0,不除标准差时优势是什么?
展开解释
减均值0.5后是0.5、0.5、−0.5、−0.5。除以总体标准差0.5才得到±1,这两个配置不能混写。
全失败组加一个很小ε后能恢复有效优势吗?
展开解释
不能。分子都为0,结果仍为0。需要检查评价器、任务难度和探索,而不是只修改数值稳定项。