把整段对话拼起来训练,为什么 loss 会算到工具输出上?
文本都在上下文里,作者却不相同
一段Agent对话包括用户任务、模型工具请求、工具结果和模型答复。它们都影响下一次预测,但不是全部都由策略生成。训练策略时,我们希望学习模型选择的动作,而不是要求模型“生成”数据库实际返回的库存数。把整段token都当监督目标,会混淆外部观测与策略决策。
这并不意味着工具结果不重要。它们作为输入改变后续动作的条件,前向计算仍然需要读取。loss mask控制哪些预测目标贡献策略损失,不是把mask为0的输入从模型视野中删除。长工具输出仍占上下文与计算,即使它们不直接计入策略目标。
六个 token,右移之后只有五个预测位置
用六个抽象token演示,不对应真实分词:U、A₁、A₂、T₁、T₂、B。U表示用户任务,A₁A₂是模型请求,T₁T₂是工具结果,B是最终模型答复。因果模型输入位置0到4对应 U A₁ A₂ T₁ T₂,目标位置对应 A₁ A₂ T₁ T₂ B。序列长度6,只有5个下一token目标。
目标掩码依次是 1、1、0、0、1。第一个模型token A₁的概率来自U所在位置的输出;不是从A₁的位置才开始计算A₁的loss。若把输入作者标签直接复制成目标mask,就会整体错一位,可能漏掉请求开头、反而把第一个工具token算进策略损失。
旧log概率与优势也要按同一个目标位置对齐。设三个模型目标的负对数概率为0.2、0.4、0.3,优势都是1,求和损失是0.9;若按有效模型目标平均,是0.9÷3=0.3。把两个工具目标错误加入,假设各为1.2与1.5,总和变3.6,平均分母也可能错误变5。数字更大不代表模型动作真的更差,而是目标已经变了。
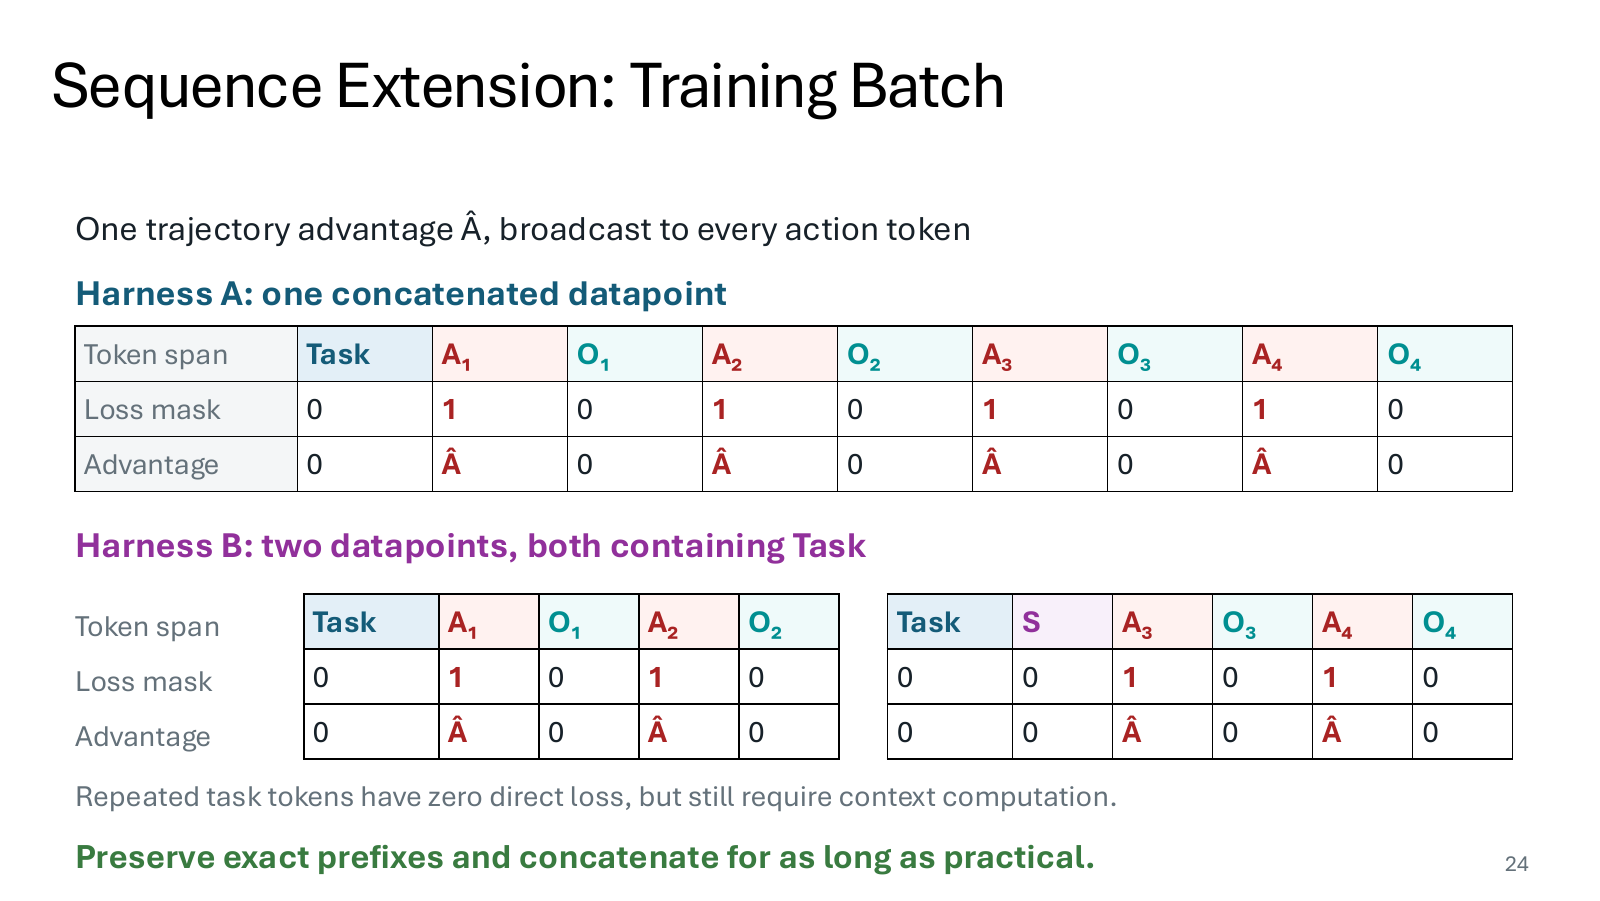
为什么拼接多轮有时成立,有时必须拆开
如果第二次调用的输入token精确等于第一次输入、模型输出、工具结果的连续追加,那么历史具有序列扩展性质,可以在一个更长序列中表示多次动作。关键词是精确token前缀,不只是屏幕上“看起来是同一段中文”。
条件一:运行器压缩旧观察,把两段工具输出替换成摘要S。第二次调用看到的历史已不是前一次序列的扩展,不能把最终文本当成从头一次连续生成的真实轨迹。应拆成两段训练样本,各自保留实际输入,并仅给该调用真正生成的动作计loss。
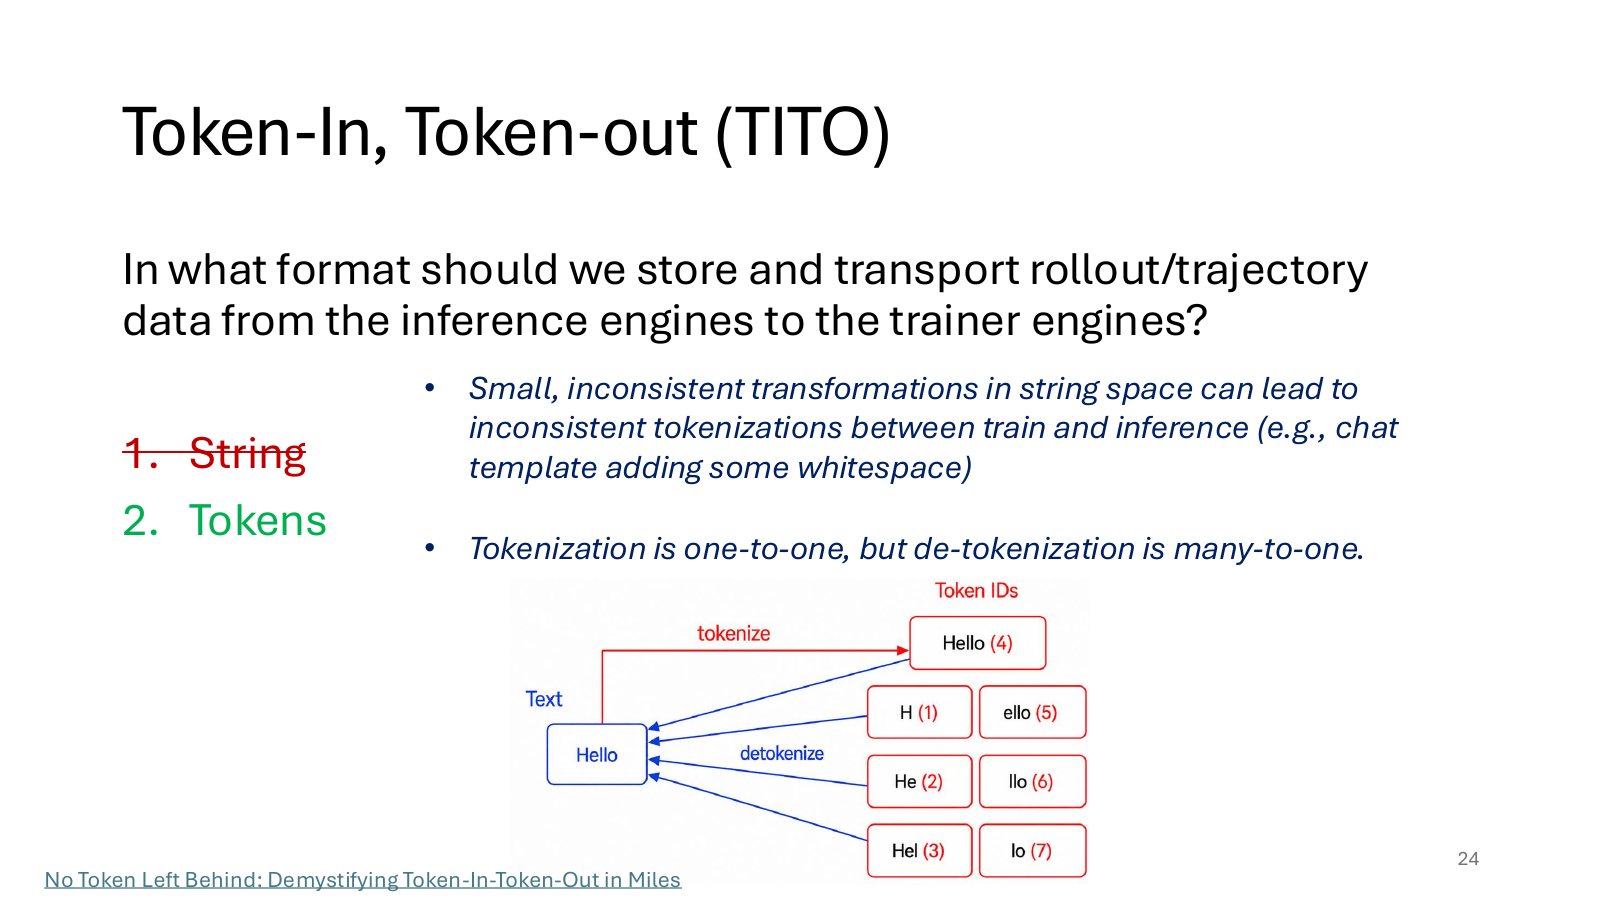
条件二:聊天模板删除过去的推理段,或把空格、特殊标记重新渲染。即使语义没变,token边界也可能改变,采样时保存的log概率就不能按字符近似位置粘贴。应记录原始token和调用边界,或明确重新构造的训练策略,避免悄悄冒充精确来源。
把目标右移一格再标颜色
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
U A₁ A₂ T₁ T₂ B,保存精确token
- 1. 右移目标
输入前5个token预测后5个token。
- 2. 标注作者
目标A₁ A₂属于策略,T₁ T₂属于环境,B属于策略。
- 3. 对齐损失
mask为1 1 0 0 1,只累加三个策略目标。
输入前5个token预测后5个token。
先预测,再核对结果与原因
可以核对每项概率与作者。掩码对应被预测目标,而非当前输入位置。
拆分不等于把之前动作重复训练两遍
第二段样本可以把旧对话作为上下文,但之前已经属于第一段的模型动作通常不应再次当成“本次新生成目标”计权,除非算法有明确的重复使用设计。否则长历史在多段样本中被重复奖励,实际权重不再是你以为的每条轨迹一次。
官方作业3把轨迹处理为token序列,再交给后端更新,强调长度n对应n−1目标以及mask、旧概率、优势的共同对齐。这一层适合用很短的人工序列核对:每个目标谁生成、由哪个输入位置预测、属于哪次调用、应乘哪个优势。盲目上大模型只会把一个偏移错误变成昂贵训练。
这节的锚点是:上下文可见、目标计损失、采样概率来源是三个不同概念。下一课在确保数据正确后,才讨论怎样提速;错误mask的训练跑得越快,只会更快学错。
对齐错误可以在不用模型的纸面检查里暴露
先写一个五列小表:输入位置、被预测token、作者、旧log概率、优势。U那一列预测A₁,应该取A₁采样时保存的概率;T₂那一列预测B,应该取第二次调用中B的概率。若一个工具目标占用了模型的旧概率,或者B用了A₂的优势位置,数组长度即使完全相同也仍是错的。长度断言只是第一关,逐位置语义对应才是这个边界最有价值的测试。
用自己的话核对一次
mask为0的工具文本还要前向计算吗?
展开解释
通常要,因为后续动作以它为条件。mask只移除相应目标的直接策略损失,不删除上下文计算。
六个token为什么只有五个下一token目标?
展开解释
每个输入位置预测紧接的一个token,最后位置之后没有给定目标,因此n个token形成n−1个可对齐目标。
字符串一样就能复用旧log概率吗?
展开解释
仍须验证模板、特殊token和分词边界精确一致。概率属于特定token及其历史,不属于粗略相似的一段文字。