想让训练快两倍,应该先加 GPU 还是改流水线?
先把一次更新的账单拆开
构造一个顺序流水线:采样生成20秒,工具等待40秒,学习计算20秒,权重同步20秒,总计100秒。假设只能把学习计算加速两倍,它从20秒降到10秒,总时长仍为90秒,整体只加速100÷90≈1.11倍,而不是2倍。最贵的设备不一定是占总时间最多的阶段。
如果工具等待是独立且可重叠的,改调度可能省得更多;如果工具服务限流,增加并发反而重试更多。判断从计时证据开始:每阶段何时开始、何时结束、在等什么、共享哪种资源。只有总耗时和GPU利用率两个数,不能定位因果瓶颈。
推理优化与训练优化解决不同问题
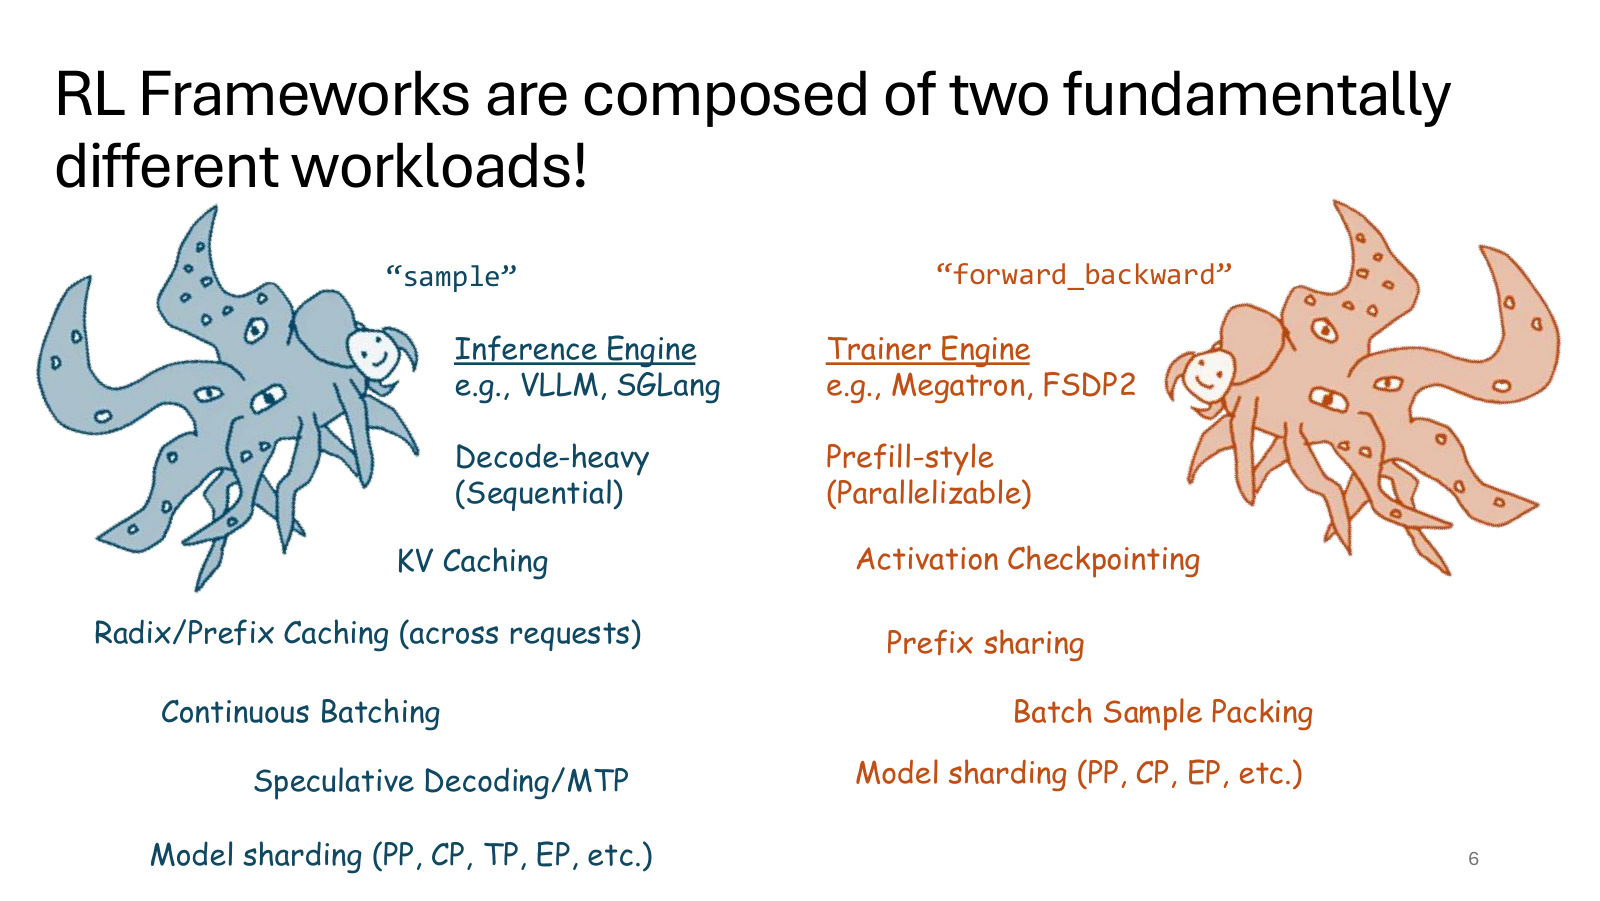
推理逐token生成,需要保存历史键值缓存KV cache。相同系统提示和工具描述被多条轨迹共享时,前缀缓存可以复用已算部分;连续批处理可让新请求接替已完成请求,减少批次空洞。但缓存命中要求真正匹配,任务相关历史不同就不能随意复用。更长缓存占更多显存,也会限制同时运行的请求数。
训练需要反向传播,中间激活往往占用大量显存。激活重计算选择少存一些激活,在反向时重新算一部分,用额外计算换内存。它可能让更大批次放得下,却不是无条件减少运算时间。序列打包减少填充浪费,模型切分让参数和计算跨设备分布,同时又带来通信。
用数字看瓶颈如何迁移
仍用100秒账单。先把工具等待从40降到20,总时长80秒;再把同步从20降到5,总时长65秒;最后把学习从20降到10,总时长55秒。相同“学习快两倍”在最后一步仍只省10秒,而前面两项合计省35秒。各阶段可能重叠时,应按关键路径重新计算,不能把并行阶段简单相加。
同步也不只是复制一个文件。推理与训练可能采用不同的参数切分布局,要转换分片、发布一致版本并确保请求读到完整权重。同步频率降低可以省带宽,但产生更多陈旧样本;更频繁则占用资源。差量传输是否有效取决于模型更新方式和系统支持,不能把某个实验的比例当所有设置都成立。
优化一段,重算整条时间线
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
生成20秒,工具40秒,学习20秒,同步20秒
- 1. 原耗时
顺序总计100秒。
- 2. 学习减半
学习变10秒,其他不变。
- 3. 算整体
总计90秒,加速100/90≈1.11倍。
顺序总计100秒。
先预测,再核对结果与原因
局部两倍不等于整体两倍。学习只占原时间20%,剩余80%未优化。
速度快了以后,样本是否仍然有用
设方案A每分钟生成100条,10条因过旧丢弃,剩90条;方案B每分钟生成160条,却有90条过旧,只剩70条。只看原始吞吐,B快60%;看可用轨迹,B反而少约22%。即使可用数更多,若全是重复简单任务,对最终能力的价值也可能低。
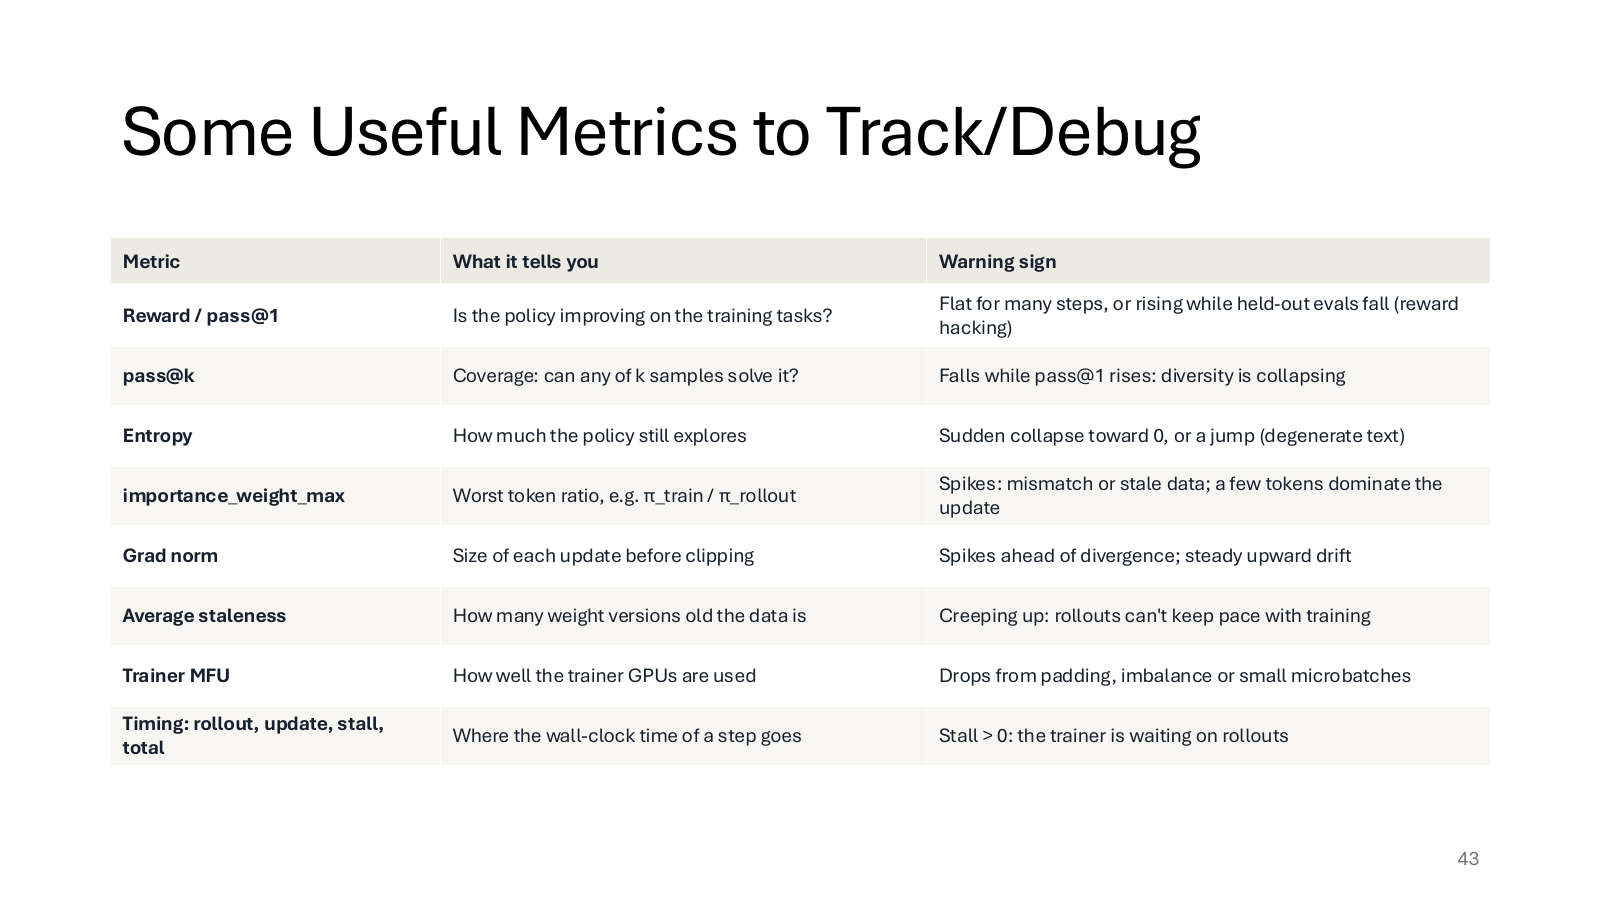
因此至少联看任务奖励、独立成功、梯度范数、熵、重要性权重极值、样本版本差、各阶段耗时和资源占用。某项异常不自动给出诊断:梯度大可能是批量尺度改变,熵低可能是学会确定任务,也可能是探索坍缩,需要回到同一配置和轨迹证据解释。
两个容易误判的条件变化
第一,把工具输出从短摘要改成完整日志。模型生成token数量没变,输入处理、KV占用和训练序列却变长,前缀复用也可能降低。不能仅按输出tokens每秒判断新版本效率。第二,把评估策略版本落后一轮,训练指标和评估指标看似不一致,可能只是比较了不同模型;每条曲线必须绑定参数与评价配置版本。
加GPU适合计算确实受限、数据供给充足、通信可控的时候。改缓存适合大量重复前缀;改队列适合等待和供需错配;改验证器不会直接让GPU更忙,却可能减少无效训练。措施必须有针对性,不能把“工程优化”当成只追设备利用率。
本章完成了从奖励到数据流水线的闭环。下一章把边界往外推:即使策略训练、掩码、吞吐都正确,Agent仍会读取不可信网页、触及真实资源。系统还要决定哪些文本能成为指令、哪些动作能真的执行。
用自己的话核对一次
每分钟生成160条,丢90条,比生成100丢10更好吗?
展开解释
可用数是70对90,前者更少。还须看质量与成本,原始吞吐不能独立证明提升。
激活重计算为什么可能让训练更慢?
展开解释
它少存激活但增加反向阶段的重新前向计算,用计算换显存。是否换来更大有效批次和整体收益需测量。
为什么性能图要记录策略版本?
展开解释
评估若测旧模型,曲线差异可能只是版本错位;系统加速与学习效果必须对齐相同参数和评价口径。