训练机很贵,为什么一半时间却在等工具返回?
一条轨迹不是一次连续的 GPU 计算
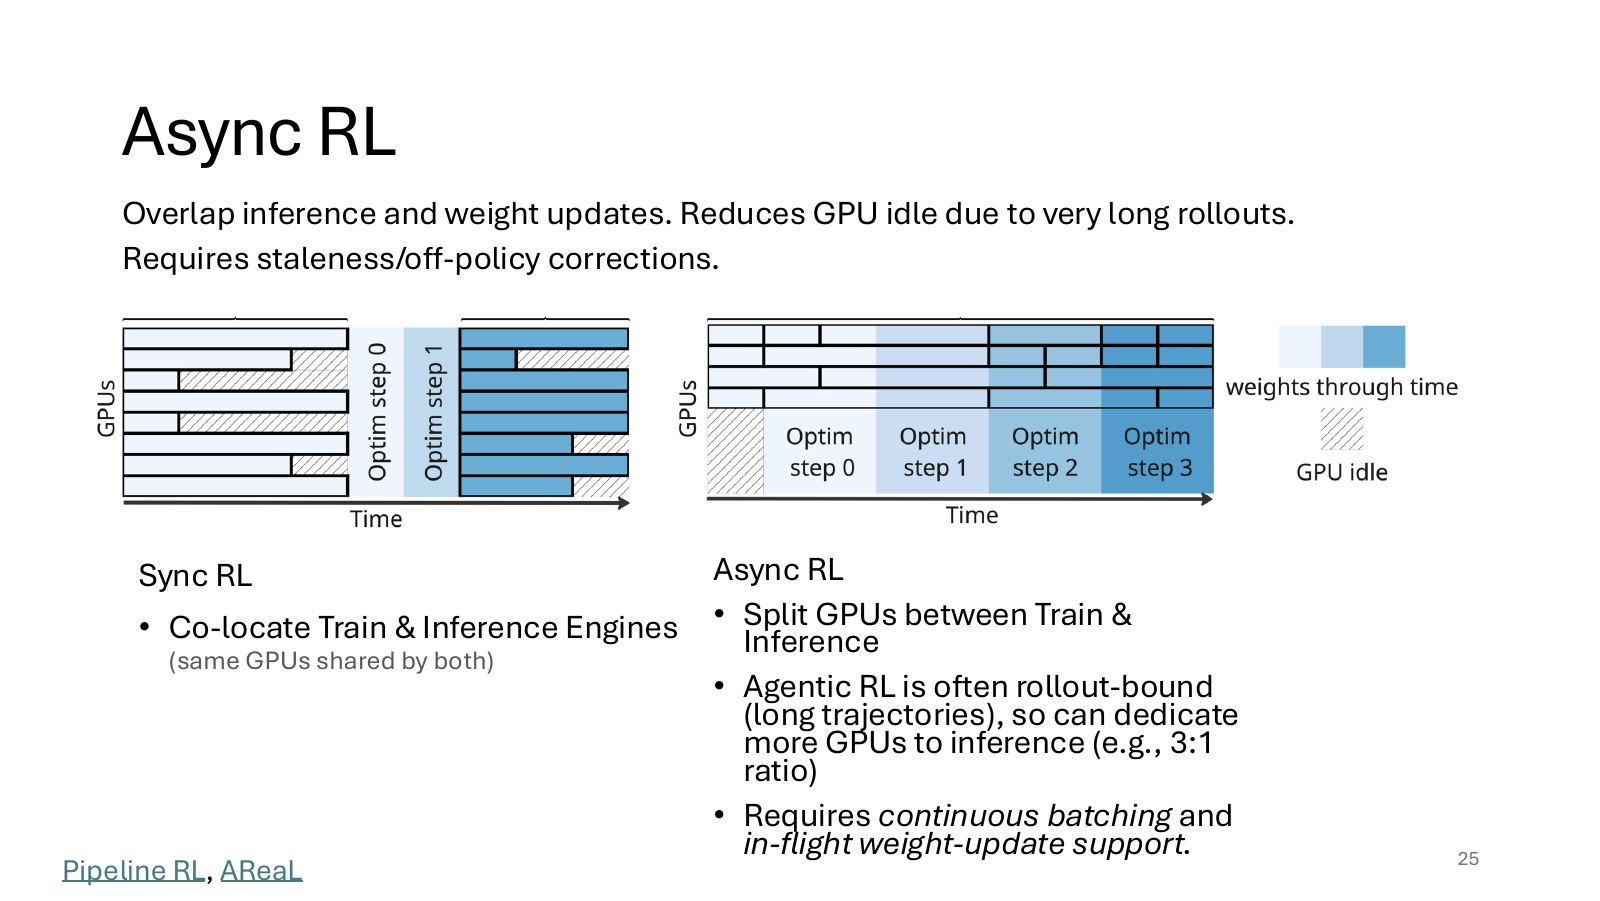
库存助手生成工具请求只花一小段时间,读取远程数据库却等待数秒;再生成分析,又等待文件写入。模型推理、网络、CPU工具和外部服务交替工作。等待工具期间,GPU不一定有本轨迹的下一个token可算,因为下一次输入取决于尚未返回的观测。
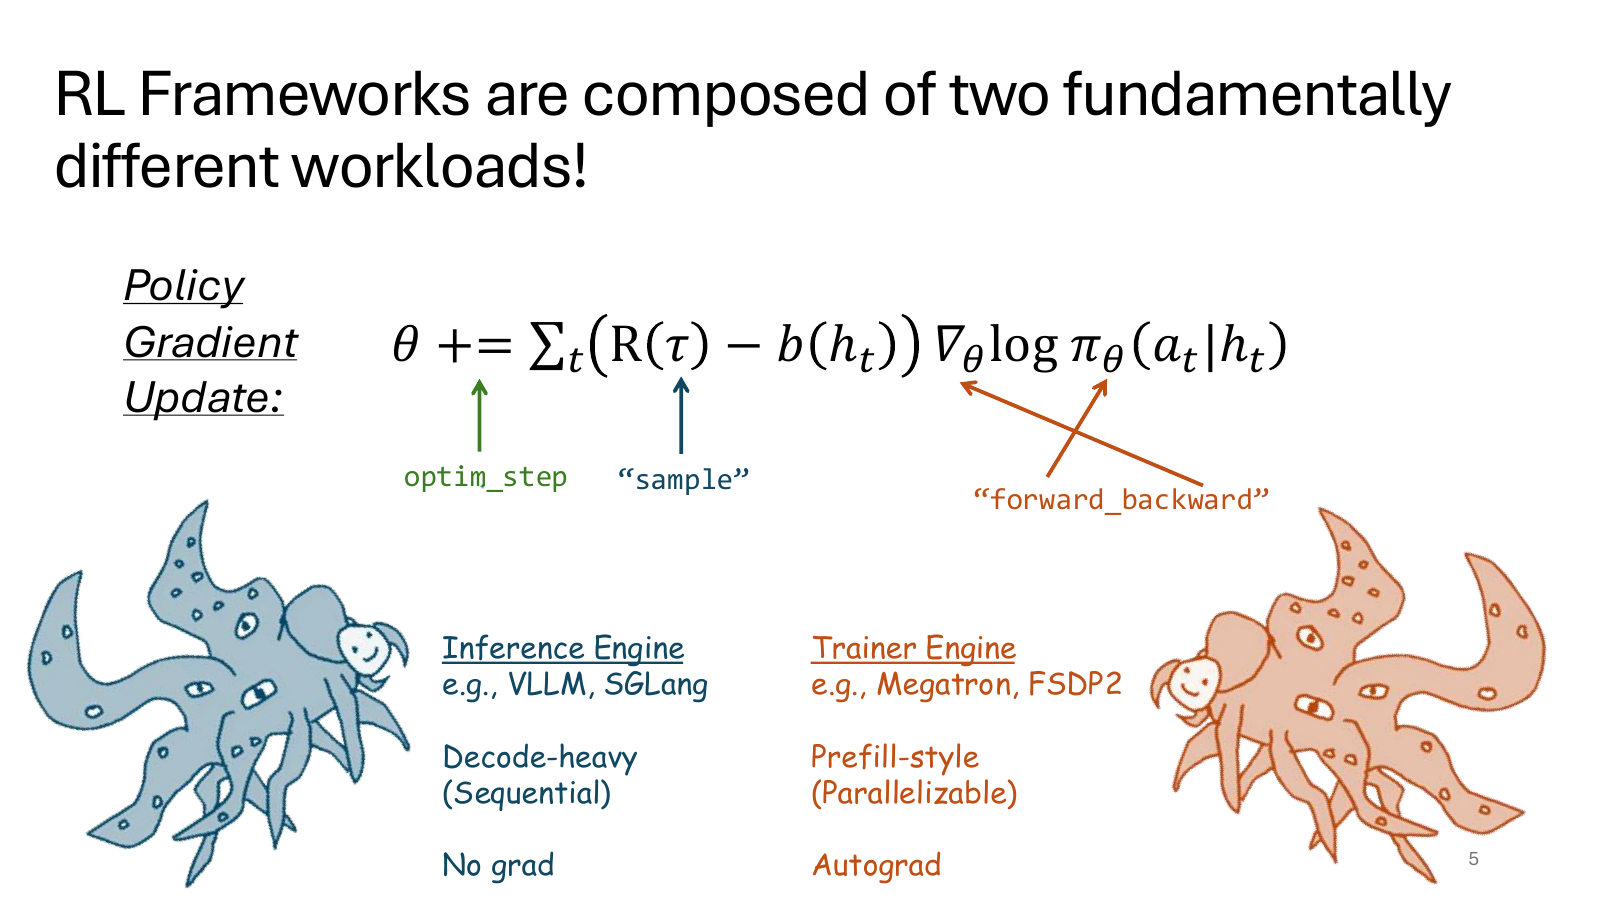
学习器的工作不同:拿到已完成的序列后,可以对许多位置并行计算前向概率、损失和反向梯度。它通常希望有足够大的有效批次连续喂入。若采用“所有轨迹跑完→统一训练→同步权重→再开始”的顺序,任何慢工具都可能把整个批次卡在屏障前。
用一个小时间表看同步屏障
假设三个独立worker生成一条轨迹的完整耗时分别3、5、12秒,学习一次耗时2秒,权重同步1秒。固定三条一批的同步方案,在第12秒才能开训,第14秒训练结束,第15秒同步完成,然后开始下一轮。快worker在第3秒完成后等待9秒,中等worker等待7秒;这不是它们计算能力不足,而是批次条件不满足。
教学时间表故意忽略GPU资源争抢:假设三个采样worker与学习器有各自资源。若实际上共享一张卡,不能把这些阶段简单重叠后宣称免费加速。并行时间只在独立资源、任务依赖和带宽条件成立时才可相加或取最大值。
有界异步让谁先走,谁暂时等
若允许两条轨迹组成训练批,第3秒与第5秒的结果可在第5秒送入学习器,第7秒完成更新。12秒的慢轨迹稍后返回,但它来自较旧策略。这样减少等待的同时引入第49课的策略陈旧问题。提高吞吐不是删除了代价,而是把屏障等待转成队列、版本和校正的管理问题。
同一批轨迹的两条时间线
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
耗时3、5、12秒;训练2秒;同步1秒
- 1. 等批次
第3秒和5秒的轨迹等待慢任务。
- 2. 开始学习
第12秒三条齐,训练到14秒。
- 3. 发布参数
同步到15秒,才开始下一轮。
第3秒和5秒的轨迹等待慢任务。
先预测,再核对结果与原因
快worker等待9秒和7秒。固定批次屏障把尾部延迟传播到整个系统。
队列无限长不是“先存着总会用”
假设推理端每秒产生4条,学习器每秒只消费2条,队列每秒增加2条。10秒多20条,时间越久样本越旧,内存也一直涨。一个有界队列设容量8,达到上限后暂停或减慢生产者,这叫背压;它把问题暴露出来,而不是用无限缓存掩盖供需失衡。
反过来,工具变慢使采样每秒仅1条,学习器每秒可吃2条,学习器空闲是数据不足。此时加学习GPU不解决瓶颈;可以增加有边界的工具并发、缩短不必要调用或改善缓存。若外部服务有限流,并发翻倍可能增加超时,真正成功轨迹吞吐反而下降。
超时、取消与恢复要落到任务状态
一条轨迹超时后,应记录任务ID、策略版本、最后确认事件与终止原因。取消采样不能留下还在后台继续写文件的工具;需要执行端支持取消、资源回收或状态核查。否则训练器以为任务失败已丢弃,环境副作用却继续发生,会污染后续尝试。
新权重发布时,也要定义何时切换:完成当前模型调用后、整条轨迹后,还是允许多轮中途切换。不同规则影响旧log概率和轨迹版本记录,不能只给整条记录一个模糊“当前版本”。如果多版本混用,必须保留足够细的来源信息。
用有效结果衡量加速
正确仪表盘应显示生成等待、工具等待、排队、训练、同步时间,以及成功轨迹数、陈旧丢弃率和取消清理结果。原始tokens每秒变高,可能只是产生更多最后被丢弃的旧数据。需要比较单位成本、单位时间内可用于学习的样本与最终任务表现。
下一课会检查这些样本进学习器时的另一个隐患:对话里混有模型动作和工具文本,如果把它们整段拼起来直接算loss,训练目标到底落在了谁写的token上?
用自己的话核对一次
为什么快worker完成后还会闲9秒?
展开解释
同步批次要求所有任务结束,最快第3秒完成仍要等到第12秒。瓶颈是屏障条件,不是这个worker的计算速度。
生产4条/秒、消费2条/秒会怎样?
展开解释
队列每秒净增2条,样本越来越旧。需要有界容量、背压和供需调整,不能无限积压。
异步方案第7秒更新,12秒返回的轨迹能当新策略数据吗?
展开解释
不能。其生成来自旧版本,应保留旧概率与版本,按陈旧规则和明确近似处理。