一组尝试全失败,没有优势差异时还能怎样继续学?
四个零只说明这一次没分出高低
同一库存任务采样四条轨迹,奖励都是0。组均值0,每条奖励减均值仍是0;采用组标准化时,标准差也为0。实现必须避免除零,但加一个很小ε后,零除ε仍是零,学习信号不会凭空出现。此时继续加大学习率没有修复信息缺失,反而可能放大其他损失和数值噪声。
最容易犯的错误是直接说“模型太弱”。我们先打开四条记录:第一组实际文件都正确,只是评价器要求固定字段顺序;第二组每条都在同一个工具格式错误处停止;第三组动作格式正确,但四条都走了同一条错误搜索路径。这三个全零组分别暗示裁判问题、基础能力缺口和探索不足,处理方法不同。
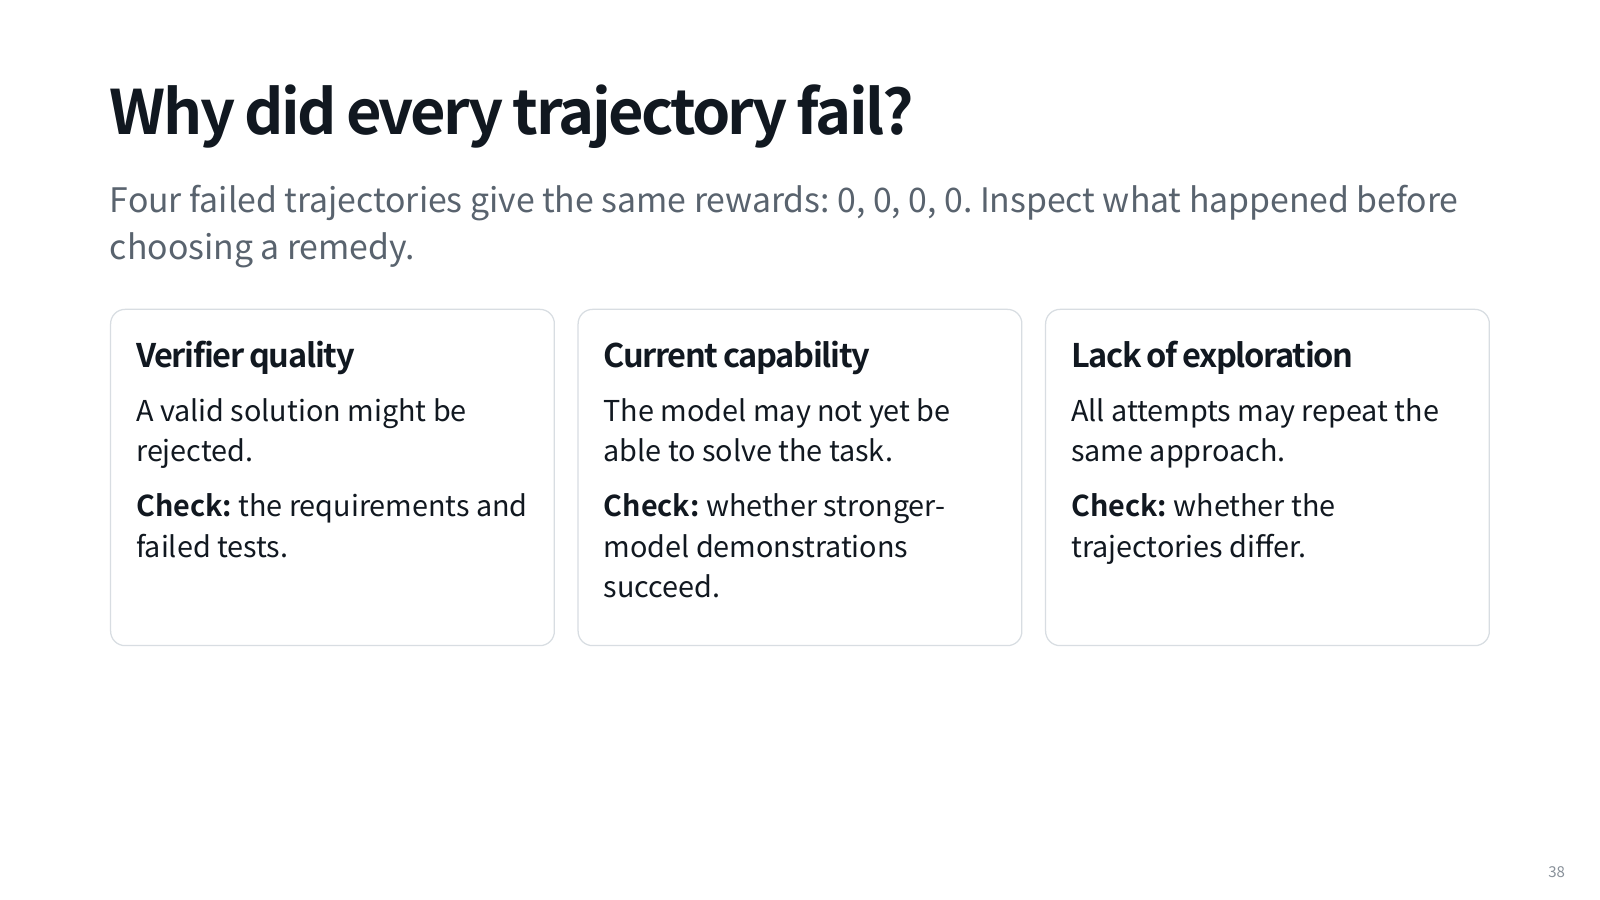
第一条路线:修评价器,而不是教模型迎合错误
若四个文件都正确,评分为零只是字段顺序不同,应修规则允许语义等价输出,并用正确、错误、边界样例验证。修完后这组也许变成1、1、1、1,优势仍全部为零;这不是修复失败,而是发现模型已经会做该任务。评价器纠错和产生组内差异是两件事。
评价器版本变化后,旧分数不宜直接拼成一条连续训练曲线。可以对保存的产物重评分,或明确标记规则切换点。否则“成功率突然上升”可能全来自评分口径修正,不能归功于参数更新。验证器测试本身也需包含空输入、重复记录和非法字段,避免一个修补制造下一个漏洞。
第二条路线:让模型先能走到有反馈的位置
如果所有轨迹都不会正确调用工具,提供少量可信示范或教师热启动可能更有效。例子应展示完整可复现链:参数格式、工具观测、基于观测的后续动作,而非只给最终答案。先学会打开环境反馈通道,再用结果奖励比较不同策略。
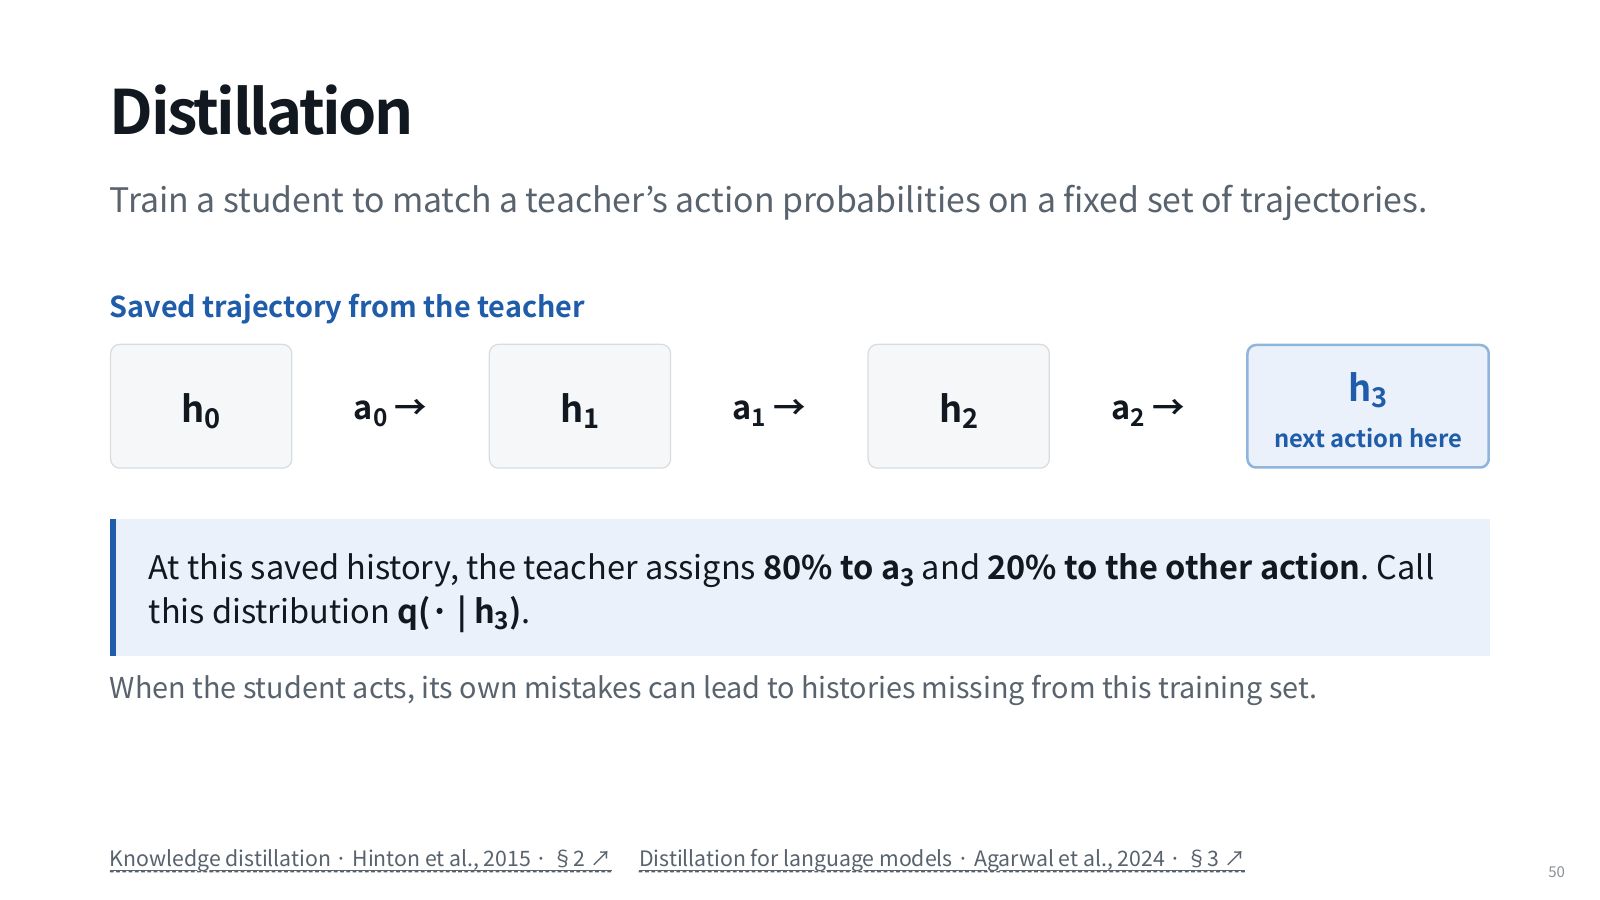
教师蒸馏通常让学生匹配教师输出分布。例如教师在同一历史对“读取文件”“猜测”给0.8、0.2,学生给0.5、0.5;最小化交叉熵会鼓励学生接近教师偏好。但训练历史若全由教师生成,学生自己走偏后遇到的新历史可能仍没覆盖。教师会做,不等于学生在自己造成的状态里会恢复。
第三条路线:探索更多,但记下付出了什么
若格式正确、评价器可信、轨迹高度重复,可以增加独立采样、调整探索或尝试不同起始策略。假设单次真实成功率0.1且各次独立,四次至少成功一次概率是 1−0.9⁴≈0.344;十次是 1−0.9¹⁰≈0.651。更多尝试提高找到对照的机会,却把成本从4次增加到10次。实际轨迹相关时,收益可能低于这个独立假设。
动态采样反复抽样,直到收集到有奖励差异的组,可以让训练批次更有信号;但若把一直失败的难题完全丢弃,保留下来的任务就偏简单。应记录总采样数、被弃任务、每题重试次数及其难度,而不是只展示最后批次的成功率。
三个零分原因,三种不同下一步
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
四条输出语义都正确,键顺序不同
- 1. 抽查产物
独立核算四条全部正确。
- 2. 定位分歧
评价器错误要求键顺序固定。
- 3. 修复再评分
变为1、1、1、1,并标记评价器版本。
独立核算四条全部正确。
先预测,再核对结果与原因
模型能力证据变了,参数并未更新。全零原因为误判;修复后的全一仍是零相对优势。
辅助奖励必须兑现到真正目标
可以给“成功打开文件”“通过格式校验”等中间进展奖励,帮助跨越稀疏反馈,但这些只是子目标。如果打开文件就能拿很多分,助手可能反复打开而不完成补货单。辅助奖励的权重、重复计数、终止条件都需检查,并始终保留最终独立成功指标。
两个边界尤其重要:全成功组也没有相对信号,却不需要用增加随机性强行制造失败;全失败组也可能只是小样本偶然,不应依据四次结果断言绝对不会。下一课把视角从学习信号转向生产数据的流水线:同样四次尝试,为什么工具一慢,昂贵的训练设备就跟着闲下来?
用自己的话核对一次
加ε为什么不能解决全零优势?
展开解释
分子都为零,稳定分母只防除零,不产生相对差异。需检查信息从哪里缺失。
修评价器后全一仍无优势,是不是白修了?
展开解释
不是。它纠正了对能力的判断,并避免错误惩罚;这个任务可能已经掌握,不必人为制造失败。
动态采样后的成功率能直接代表原任务分布吗?
展开解释
不能。反复失败的任务可能被过滤,留下的组带选择偏差。应保留原分母、采样成本和难度分布。