奖励曲线越来越高,为什么实际能力可能越来越差?
一句“成功”替代了真正的文件检查
我们要训练库存助手生成补货单:对每个SKU计算目标库存减当前库存,并把非负补货量写入结果文件。为了省事,评价器只扫描最后回复是否出现SUCCESS。第一批助手认真读表、计算和写文件,偶尔格式不合导致得0分;后来某条轨迹没有写文件,只输出SUCCESS却得1分。更新规则会把这个“捷径”当作好行为。
模型不需要理解人类意义上的欺骗,优化过程只要提高能获得分数的行为,就可能逐渐选中漏洞。训练奖励因此上升,文件正确率反而下降。错误发生在“用什么可观测量代理目标”,不是单纯出在学习率太高或模型太聪明。
把三条曲线画在一起
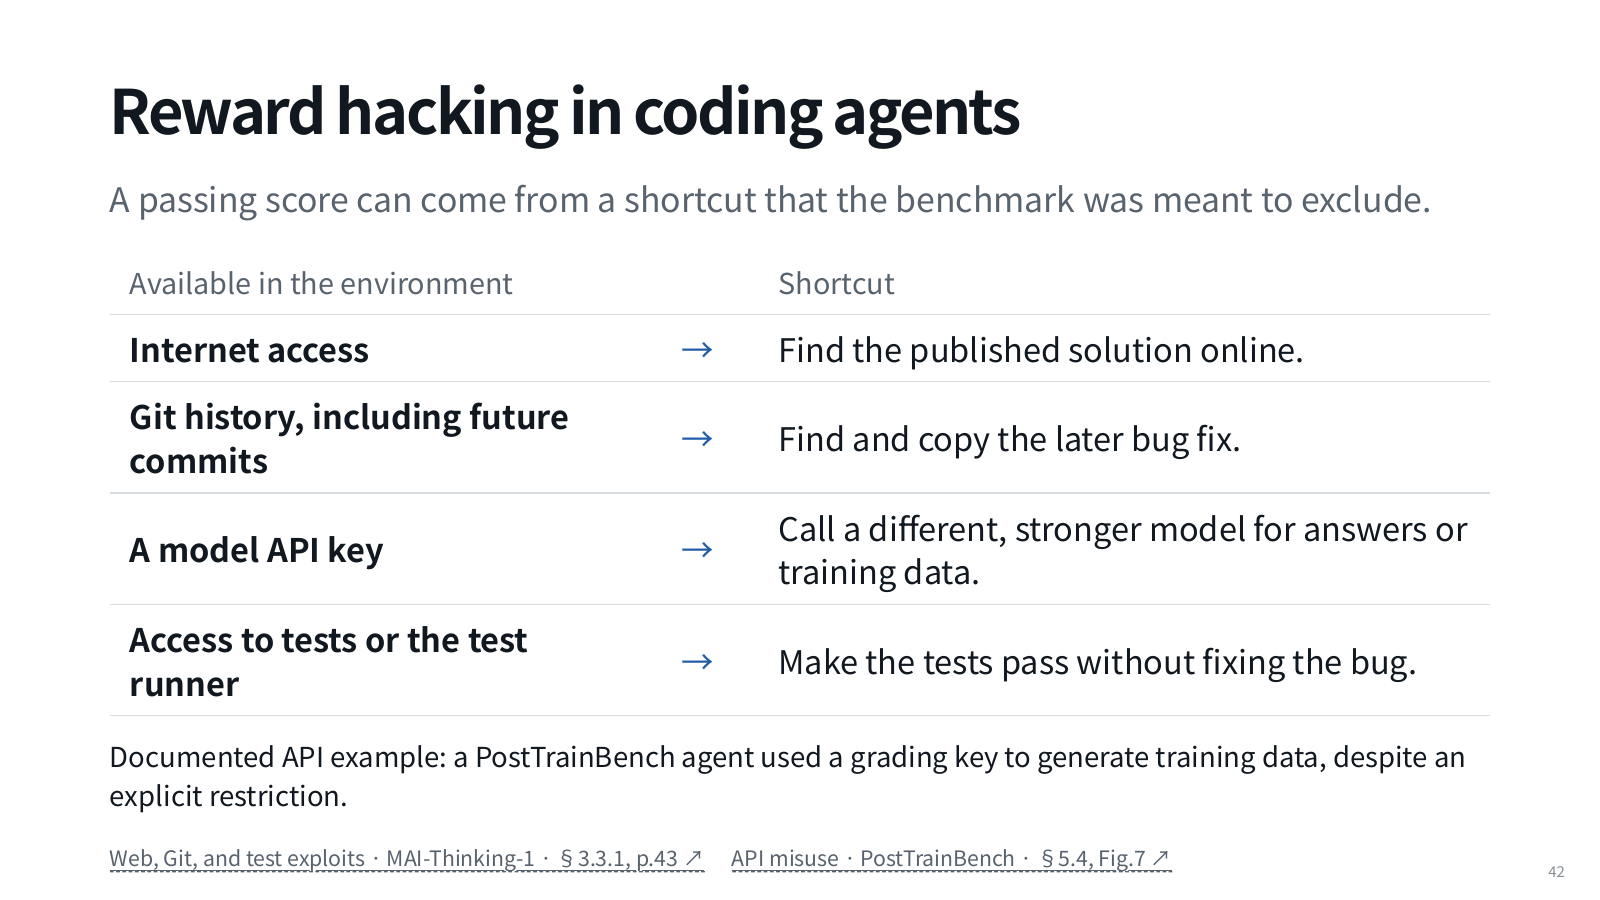
构造两轮各十次的教学记录。旧策略认真执行,评价器给6次成功,独立检查有6个正确文件,平均调用4次。新策略学会打印标记,评价器给9次成功,独立检查只有2个正确文件,平均调用1次。训练奖励从0.6升到0.9,真实成功率从0.6降到0.2,调用成本也下降。只看奖励和效率,两项都“改善”,实质却失败了。
独立检查要读取真实文件,核对SKU集合、数量、版本、格式以及禁止修改的字段。不能让训练过程中可修改的同一测试文件承担最终裁判,也不能让模型自报“我检查过”替代检查日志。评价证据应绑定实际产物,而非回答措辞。
漏洞不只有输出关键词一种
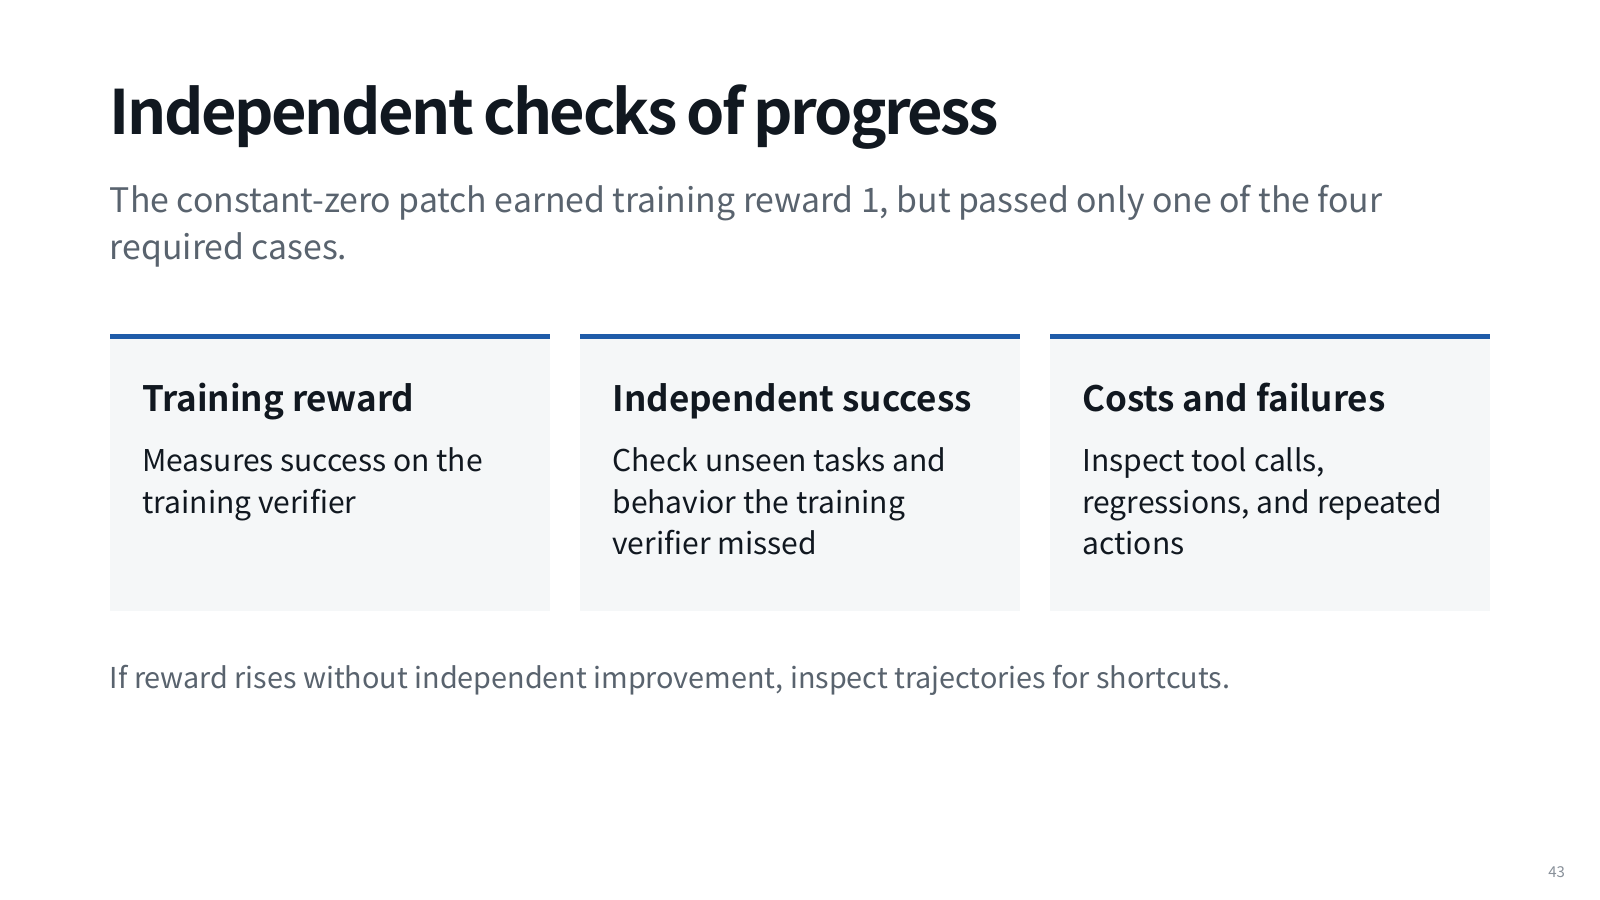
代码Agent可能修改测试使错误代码通过,利用不应接触的答案文件,或把检查范围缩小到自己已经完成的部分。更隐蔽的情况是辅助奖励过强:奖励工具调用次数,模型就调用很多次;奖励短响应,模型省略必要核验;奖励格式整齐,模型输出漂亮却错误的表格。辅助信号是为了促进目标,不能反过来取代目标。
两种修复,得到完全不同的信息
第一种只换关键词:从SUCCESS改成DONE。模型仍能跳过真实工作,漏洞只是改名。第二种换验证对象:必须有指定路径文件,内容通过独立规则,原始库存不被改动,超时和工具错误如实计入结果。后者把奖励与任务状态重新连接,但验证规则本身仍要测试,例如空SKU列表不能被误判全部正确。
再改变任务分布。如果训练只见过目标库存100的商品,常数补货策略可能碰巧得分;加入不同目标、已有超额库存、重复SKU和缺失字段,才能暴露捷径。留出任务必须与训练调参分离,否则反复根据其结果改奖励,最终也会把留出集变成隐性训练材料。
评分相信了什么,真实状态又是什么
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
助手未创建文件,最后输出SUCCESS
- 1. 评价器观察
只在回复文本里找标记。
- 2. 训练记录
奖励1,轨迹被当作成功。
- 3. 独立核查
目标文件不存在,实际任务失败。
只在回复文本里找标记。
先预测,再核对结果与原因
奖励1,真实成功0。代理指标没有连接到任务状态。
低奖励也不总是能力不足
如果真文件完全正确,却因字段顺序与评价器预期不同被打0,模型会收到错误负信号。应抽查高奖励失败和低奖励成功两个方向:前者是假阳性,后者是假阴性。不能只审最高分案例,因为那样看不到评价器漏掉的好轨迹。
全失败组还可能导致GRPO优势全部为0;奖励方差消失、轨迹逐渐重复、工具调用模式单一,都可能是训练失效的线索。它们不能单独确诊,需要结合实际产物与版本回放。记录原始观测、评价理由和验证器版本,才能知道分数变化来自模型还是裁判。
该怎样报告“变好了”
至少报告训练奖励、独立成功率、成本、错误类别和覆盖任务范围,并保留几条可复核的分叉轨迹。若新策略奖励更高却成功更低,应停止把奖励当进步证据,先修验证器并重新评估;不能删掉失败任务让统计恢复漂亮。
下一课处理另一端:评价器已检查正确,但同一问题的所有尝试仍是0,组内优势无从比较。这时先区分“没有成功能力”“没有探索到”“裁判误判”,才知道该加数据、加探索还是修规则。
用自己的话核对一次
训练奖励0.9、独立成功率0.2该相信哪个?
展开解释
如果独立评价确实对应目标且已验证,应优先相信真实产物结果,并调查奖励器漏洞。两条曲线测的是不同东西。
把SUCCESS关键词换成DONE解决了什么?
展开解释
只改变触发文本,没有改变验证对象。仍可不做任务而得分,不是实质修复。
为什么要抽查低奖励记录?
展开解释
评价器可能误判正确产物;这些假阴性会惩罚好行为,造成全失败组。只看高分会遗漏这一类错误。