只留下成功尝试再训练,与策略梯度有什么区别?
同一箱轨迹,可以做出两种不同训练材料
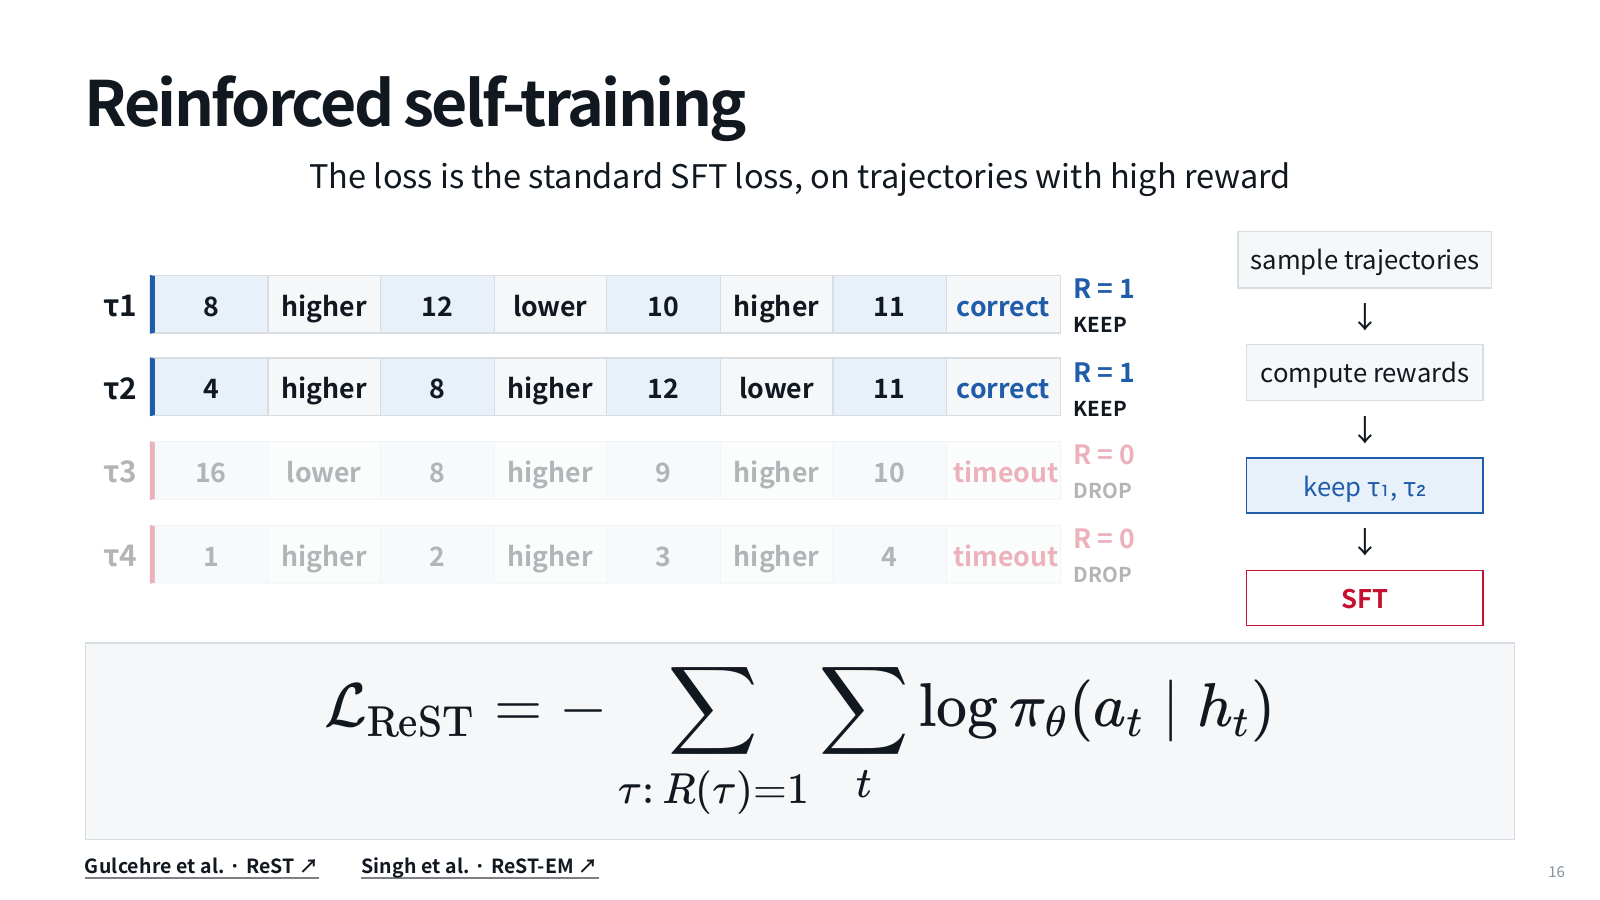
假设库存助手有四条完整记录:甲正确读取文件、算出缺货量并输出补货单,奖励1;乙绕了两次路但最终正确,奖励1;丙把库存字段看错,奖励0;丁工具报错后仍宣称完成,奖励0。我们已经付出四次采样费用,接下来是把哪些记录交给优化器、让哪些动作概率增加。
最朴素的想法是“只学好的”。留下甲乙,丢弃丙丁,对甲乙里的模型输出做监督微调。这是筛选再模仿的路线。另一种想法是“好的相对增加,差的相对减少”。四条都留下,给甲乙正优势、丙丁负优势,再形成策略梯度更新。两者都先生成数据再训练,但数据经过筛选后扮演的角色不同。
ReST 的三件事:生成、筛选、再模仿
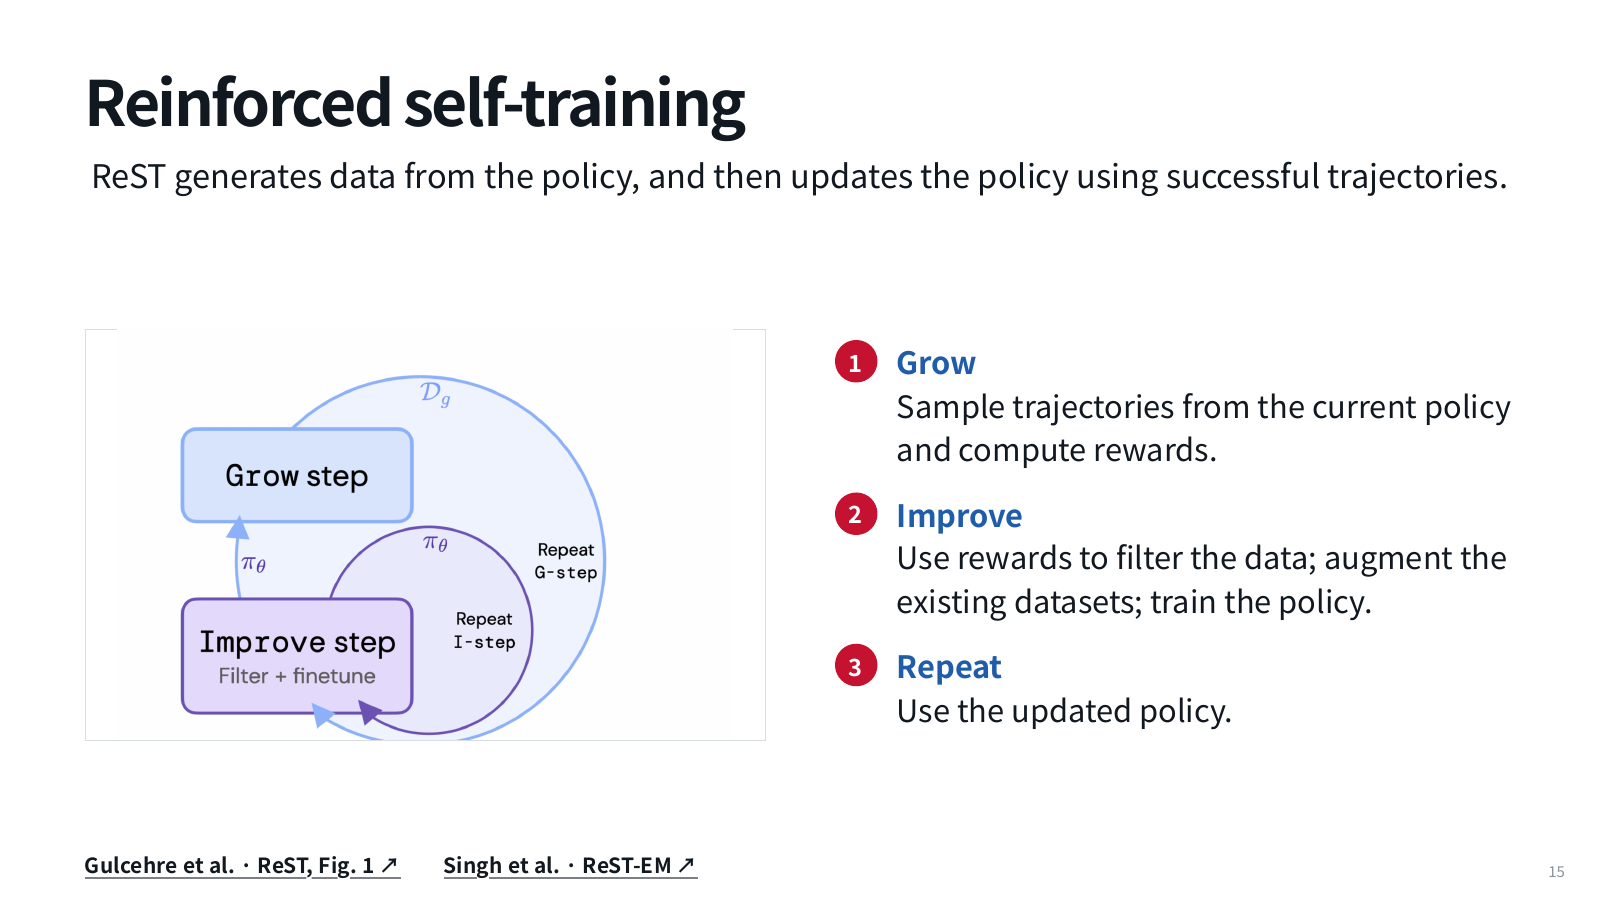
原课把这类循环称为Grow与Improve:从当前模型生成候选,用评价器给结果评分,将满足条件的候选作为监督目标,再用更新后的模型生成下一批。若筛选阈值是奖励等于1,四条数据留下两条,保留率为50%。这时学习目标可以写成 L=−(logπ(甲)+logπ(乙))/2,这里的轨迹概率仅指需要学习的模型动作序列。
假设只看第一步的两种选项:读取文件概率0.4,直接猜库存概率0.6。两条保留轨迹第一步都读取,监督损失会鼓励“读取”在这类历史下出现得更多。但失败轨迹被删掉了,优化器不会直接看到“报错后宣布完成”这一段该被惩罚。共享参数可能间接改变它的概率,不能把这种间接变化说成明确使用了失败反馈。
带优势的更新保留了什么差别
同一批奖励的均值为0.5。采用只减均值的优势,四条权重为 +0.5、+0.5、−0.5、−0.5。损失可写为 −[0.5logπ(甲)+0.5logπ(乙)−0.5logπ(丙)−0.5logπ(丁)]/4。梯度下降时,正权重鼓励对应采样动作;负权重降低对应采样动作的对数概率。这里的1/4是批量平均,不是奖励大小。
请逐项看丁的项:外面的负号乘里面的−0.5,得到 +0.5logπ(丁)/4;最小化这一项倾向让logπ(丁)减小。删去基线并直接使用二元奖励时,丙丁权重又变成0。于是“策略梯度一定利用失败”也不准确,要看实际权重;奖励加权模仿和无基线二元策略梯度在某些目标形式上会接近。
同一批数据的两种去向
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
奖励1、1、0、0;阈值1
- 1. 筛选
甲乙通过,丙丁丢弃,保留率50%。
- 2. 造目标
甲乙的模型动作成为监督标签。
- 3. 更新
鼓励两条成功轨迹;没有对失败轨迹的直接负权重。
甲乙通过,丙丁丢弃,保留率50%。
先预测,再核对结果与原因
得到两条自生成示范。优化器学的是筛选后目标,不是四条轨迹的相对排名。
改两个条件,原来的选择还合适吗
先改奖励精度。四条奖励变成1、0.8、0.2、0,阈值0.7仍只留下前两条,并可能等权学习;带优势的版本均值0.5,权重是0.5、0.3、−0.3、−0.5,保留了评分的相对差别。如果评价器的0.8与1只是噪声,这种细分也可能把噪声放大。更细的信号不自动更可信。
再改数据质量。乙虽然成功,却读取了不必要的敏感文件。只看最终正确的筛选会把乙也当好示范;只看同一个奖励的策略梯度也会奖励乙。算法不能自动修补目标遗漏。必须先定义允许的动作、独立核验产物,必要时拒绝不合规轨迹,而不是期待负样本自己教会权限边界。
选择训练方法之前先检查证据
成功样本非常少、基础输出格式还不稳定时,少量可靠示范常常是有价值的启动材料;能够稳定采样、评价器可信且需要比较不同探索路径时,带优势的更新才有可靠反馈可用。这里不是两个算法的普遍优劣排序,还需要同一任务集、同一采样预算与留出评价。
训练日志至少记录采样数、成功数、保留率、重复示范比例以及独立成功率。保留数据准确率100%只是筛选规则造成的,不代表模型已经100%成功。下一课要追问:即使保留整条轨迹并算优势,十步中的哪一步真正改善了局面?这需要对“当前历史的后续回报”建立预测。
用自己的话核对一次
筛选后两条都正确,能说模型成功率100%吗?
展开解释
不能。原始四次只成功两次,成功率50%;筛选集正确率是条件统计,必须同时报告保留率。
ReST会直接降低被删除失败动作的概率吗?
展开解释
监督目标中没有那些动作的失败项,不能声称直接惩罚。共享参数可能产生间接变化,需要实测而不是由筛选规则推断。
成功轨迹违反权限,两种训练方式谁能自动解决?
展开解释
都不能。共用的奖励若遗漏权限,两者都可能学习不当行为。需要独立检查动作及边界,而不只是更换更新算法。