一次任务做了十步,critic 在每一步究竟预测什么?
它预测未来,不是替工具宣布答案
库存助手刚读完一张表,尚未核验SKU。此时我们问:“从这个历史继续按照当前策略做下去,最后通常能拿到多少回报?”价值模型,也叫critic,回答的是这个条件期望。若终局奖励只有成功1、失败0,且没有折扣与额外成本,它的值可以解释为预测成功概率。若加入负成本或奖励大于1,价值就不能再简单叫概率。
同一个工具动作对不同历史可能有不同意义。缺少库存文件时,读取它有用;已经读取且确认版本不变时,再读一次可能只是增加成本。只给整条轨迹一个成功标签很难分清这两种情况,critic试图用历史解释后续前景。不过它仍是学习出来的预测器,会错,也会随着策略变化而过时。
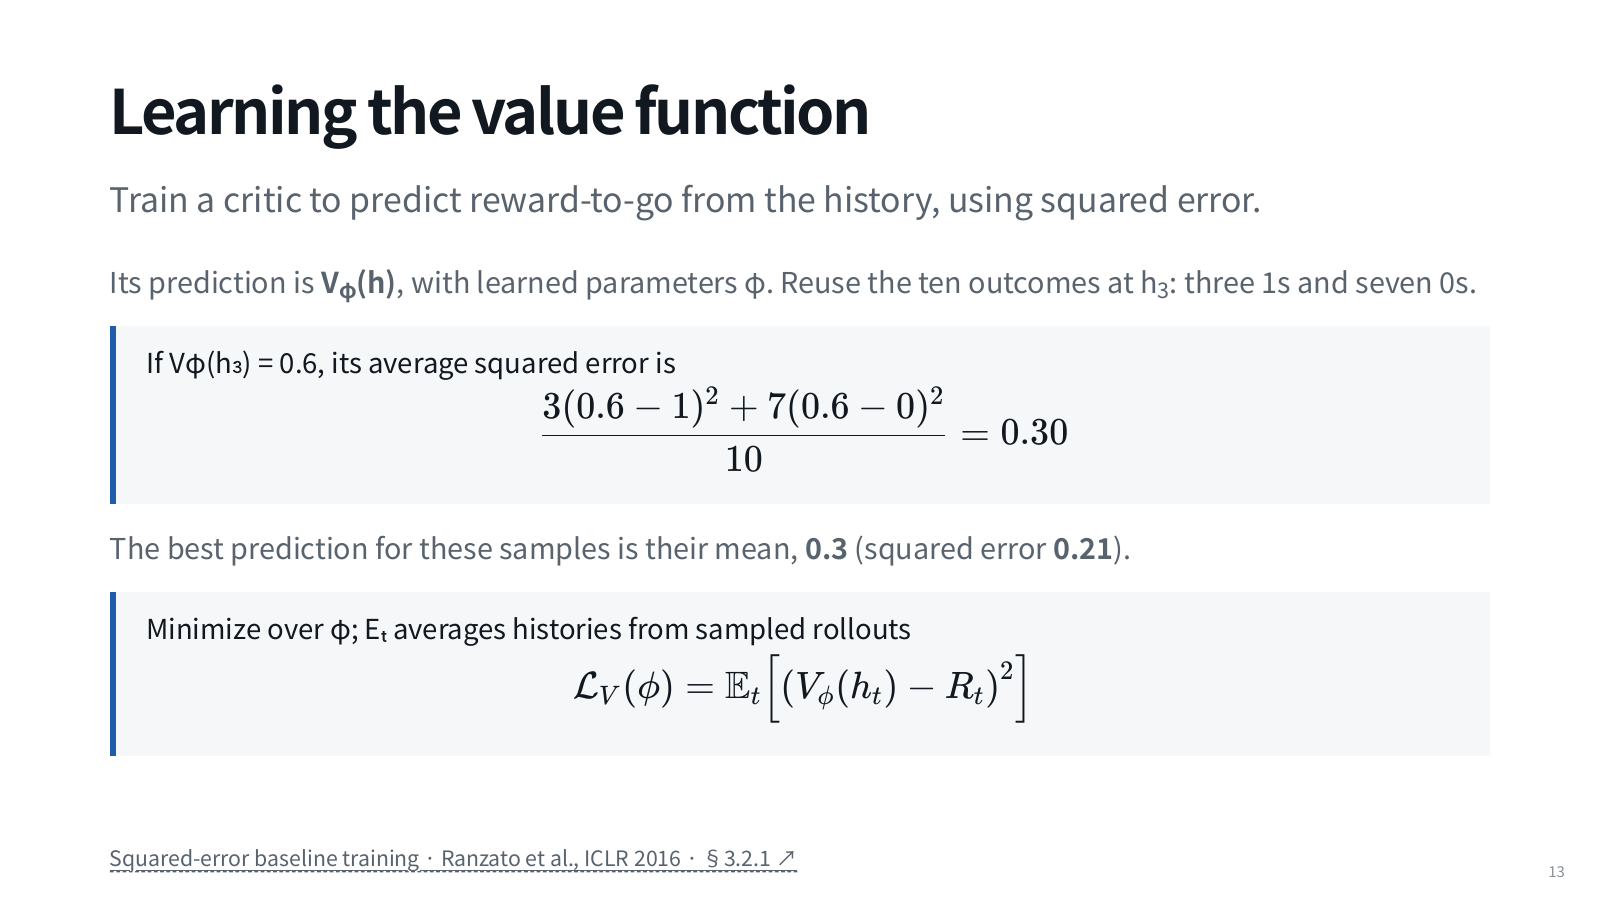
一个预测值怎样被训练出来
考虑十次相似起点的尝试,其中三次成功、七次失败。若critic一直预测0.6,平均平方误差为 [3×(1−0.6)²+7×(0−0.6)²]/10=(0.48+2.52)/10=0.30。改成预测0.3,误差是 [3×0.7²+7×0.3²]/10=(1.47+0.63)/10=0.21。这说明在这批二元结果上,0.3比0.6更符合观测频率,并不证明下一次必定失败。
TD 误差:这一步比预期带来了什么
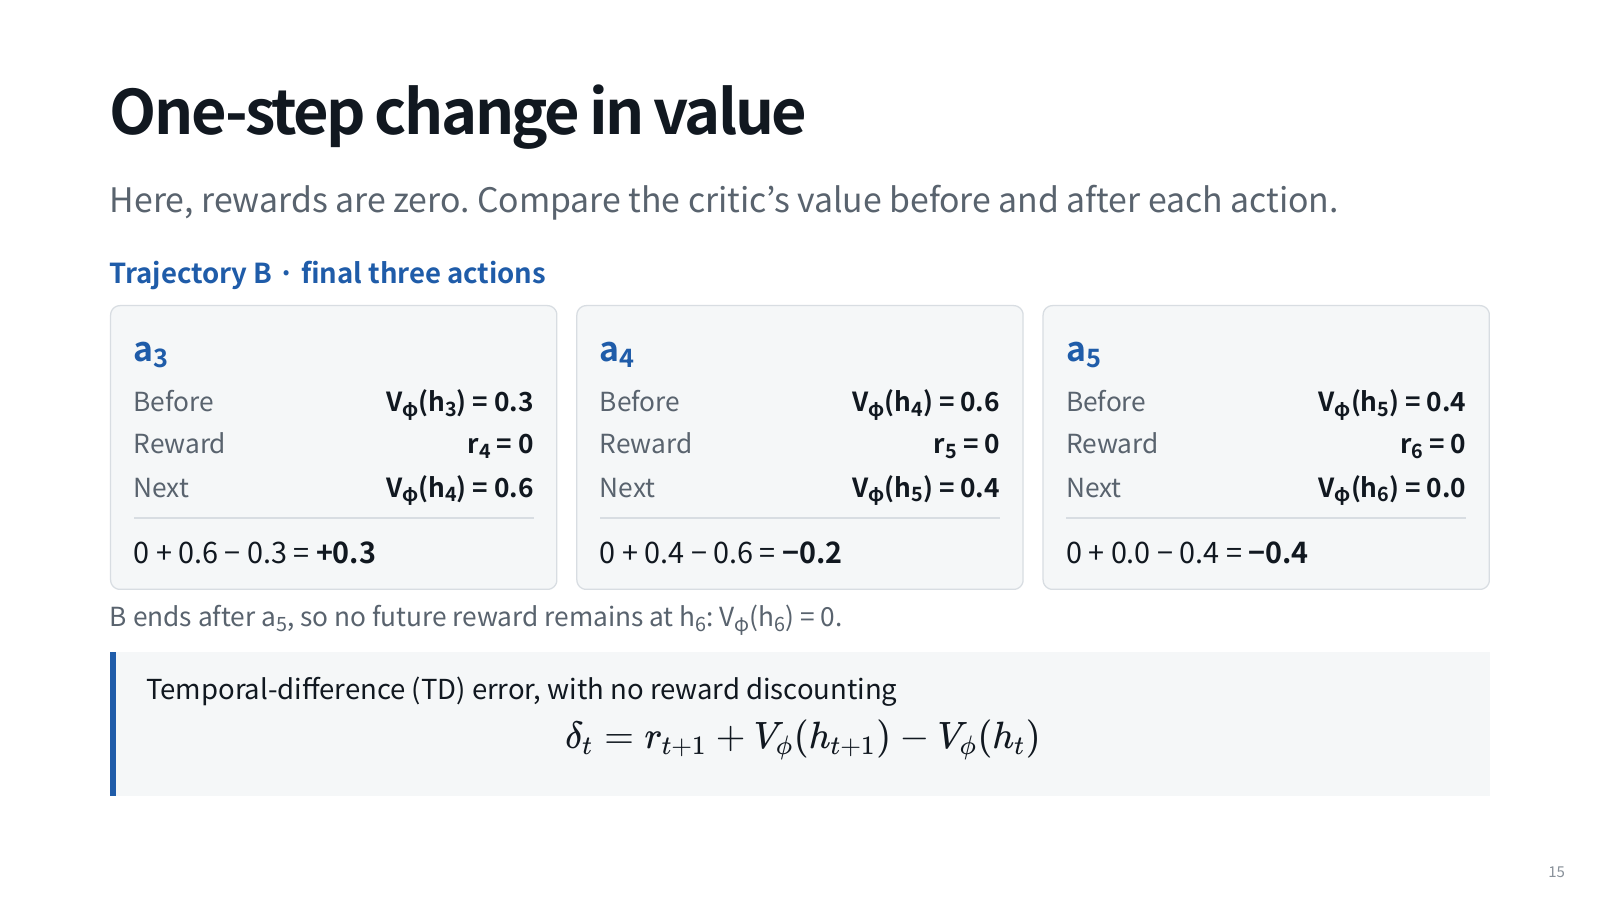
令历史价值依次为 V₀=0.3、V₁=0.6、V₂=0.4、V₃=0,三个即时奖励都为0,最后确实终止失败。取折扣γ=1,一步TD误差为 δ_t=r_(t+1)+γV_(t+1)−V_t。第一步是0+0.6−0.3=+0.3;第二步0+0.4−0.6=−0.2;第三步0+0−0.4=−0.4。它们表示新获得的前景与旧预期之差。
第一步的正误差不表示任务已经成功,甚至不证明这步因果上正确;它只表示critic认为新历史比原先预测更好。整条轨迹终局失败,第一步仍可能是有用的读取动作。若把γ改成0.9,第一步变为0.54−0.3=0.24,第二步0.36−0.6=−0.24,第三步仍−0.4。折扣改变对更远回报的估价。
GAE 为什么把后面的误差也带回来
只用一步预测容易受critic误差影响,直接等到结局又可能方差很大。广义优势估计GAE把一串TD误差按 (γλ)^k 加权。沿用γ=1,取λ=0.5,第一步优势是 0.3+0.5×(−0.2)+0.25×(−0.4)=0.1;第二步是 −0.2+0.5×(−0.4)=−0.4;第三步−0.4。λ控制向后带回多少误差信息,不是成功概率。
λ=0只保留当前TD误差,第一步为0.3;λ=1时,三个误差相加是−0.3,等于实际回报0减起点预测0.3。后面的坏消息会向前传。若最后奖励改为1,最后TD误差从−0.4变为+0.6,λ=0.5时第一步优势增加0.25,成为0.35。这就是“只改终局,前面估计也改变”的具体传播过程。
最后一步的消息如何传回
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
V=0.3、0.6、0.4、0;γ1,λ0.5
- 1. TD
得到0.3、−0.2、−0.4。
- 2. 向前加权
第一步0.3−0.1−0.1=0.1。
- 3. 解释
第一步仍有小幅正优势,但结局失败且后续动作负优势。
得到0.3、−0.2、−0.4。
先预测,再核对结果与原因
不能把终局失败平均等同于每步同样坏。估计利用了历史预测,也会受预测误差影响。
critic、过程评分、执行结果不要混在一起
过程奖励模型可以判断某个推理步骤看起来是否合理;critic估计从当前历史继续的回报;独立测试或工具状态报告实际发生了什么。三者输入和学习目标不同。一个表达漂亮的步骤可能没有提高真实成功率,一个critic高分也不能替代库存文件的检查。
实现时还要注意梯度路径:价值头可以附在策略模型上,也可以独立建模,是否让价值损失更新共享主干是明确的工程选择。预测误差持续偏大时,复杂优势估计未必比简单组内基线可靠。下一课再放松一个假设:这些轨迹由过去的策略生成,现在的策略已经变了,原来的样本频率还代表现在吗?
同一个历史,换策略后价值也可能改变
如果旧策略常把正确库存读错,某个历史价值预测只有0.3;新策略学会可靠解析后,同一历史继续的成功率可能升高。critic估计的是特定后续策略的回报,不是给这段文本永久贴一个客观分数。策略更新太快而critic跟不上时,TD误差里混入预测滞后,优势就可能产生误导。
还要避免把训练critic时的目标值当可任意穿透求导的真值。在常见自举目标里,下一状态价值作为停止梯度的目标来拟合;否则优化器可能通过同时移动目标与预测,偏离原本的回归含义。这里只用数值说明反馈链,具体损失、共享主干和停止梯度位置应以所实现的算法为准,并用短序列核对。
用自己的话核对一次
预测V=0.6,是否表示当前任务完成了60%?
展开解释
不是。它是给定历史与策略下的期望后续回报;二元终局设置才可解释为预测成功率,更不是完成进度。
λ=0时第一步优势是多少?
展开解释
就是当前TD误差0.3。后面的误差不进入这个估计,但下一状态价值本身仍是预测量。
时间耗尽是否总能把末端价值设成0?
展开解释
不能一概而论。真正终止没有未来回报;因采样限制而截断、环境理论上还可继续时,需明确是否bootstrap,避免把采样边界当任务失败。