一条轨迹的奖励,怎样改变下一次选动作的概率?
先把语言模型缩成只有两个动作
上一课说“成功之后提高相关行为的概率”,现在必须解释提高的是谁、方向从哪里来。我们暂时把一次选择简化为 A 与 B:A 表示先检查一个边界条件,B 表示直接沿用默认值。用一个参数 θ 控制 p(A)=σ(θ),于是 p(B)=1−p(A)。这是可手算的两动作教学模型,不是完整语言模型的全部参数。
设当前 p(A)=0.25,所以 p(B)=0.75。模型这次采样到了 A,任务最终奖励为 1。我们想让这种有回报的选择更常发生,却不能把“下次必选 A”直接写死:只观察一次,可能有运气;模型也要保留别的动作。
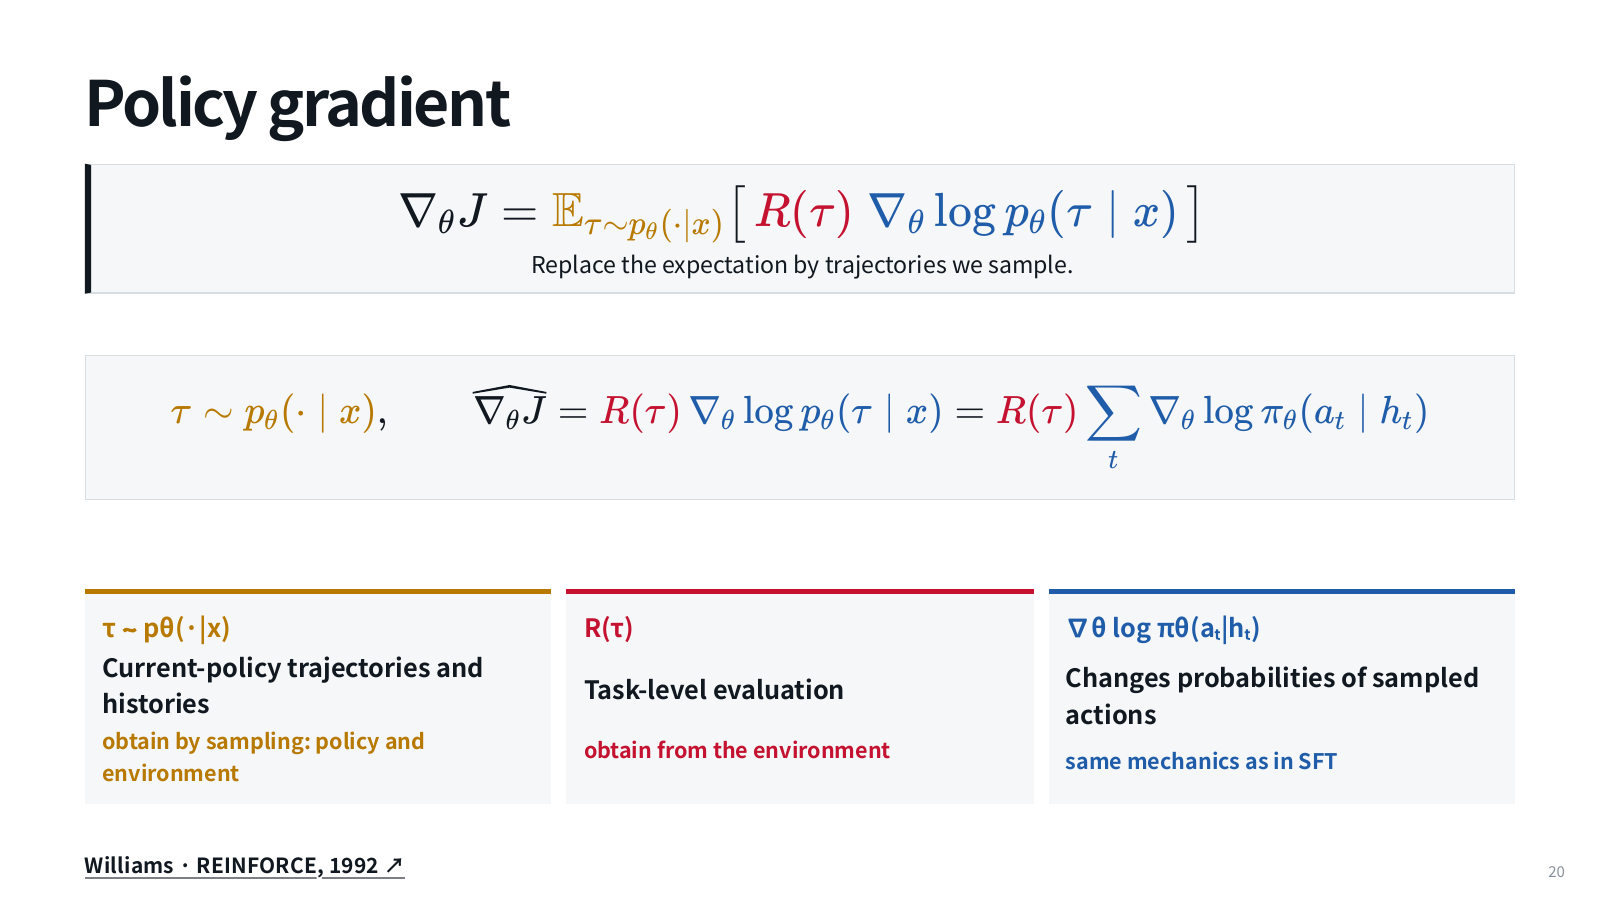
策略梯度给出的一个采样更新方向是:奖励乘以这次动作的对数概率对参数的梯度。写成 R × ∂logπ(a)/∂θ。奖励 R 来自环境评价,对数概率来自模型在采样时的选择分布,梯度说明参数往哪边移动会使这个已选动作更可能。
把正负号真正算出来
对于二动作 sigmoid,选到 A 时有 ∂log p(A)/∂θ=1−p(A)=0.75。奖励为 1,采样方向就是 1×0.75=0.75。采用梯度上升、学习率 0.1,则参数增量 Δθ=0.075。原参数 θ=ln(0.25/0.75)≈−1.0986;更新后约 −1.0236,新概率约为 0.2643。它提高了,却远没有跳成 100%。
如果这次选到的是 B,而 B 的奖励同样为 1,则 ∂log p(B)/∂θ=−p(A)=−0.25,更新会减小 θ,降低 A 的概率、提高 B 的概率。正奖励并不是总让同一个参数增大;它让被奖励动作沿着自己的概率梯度获得支持。
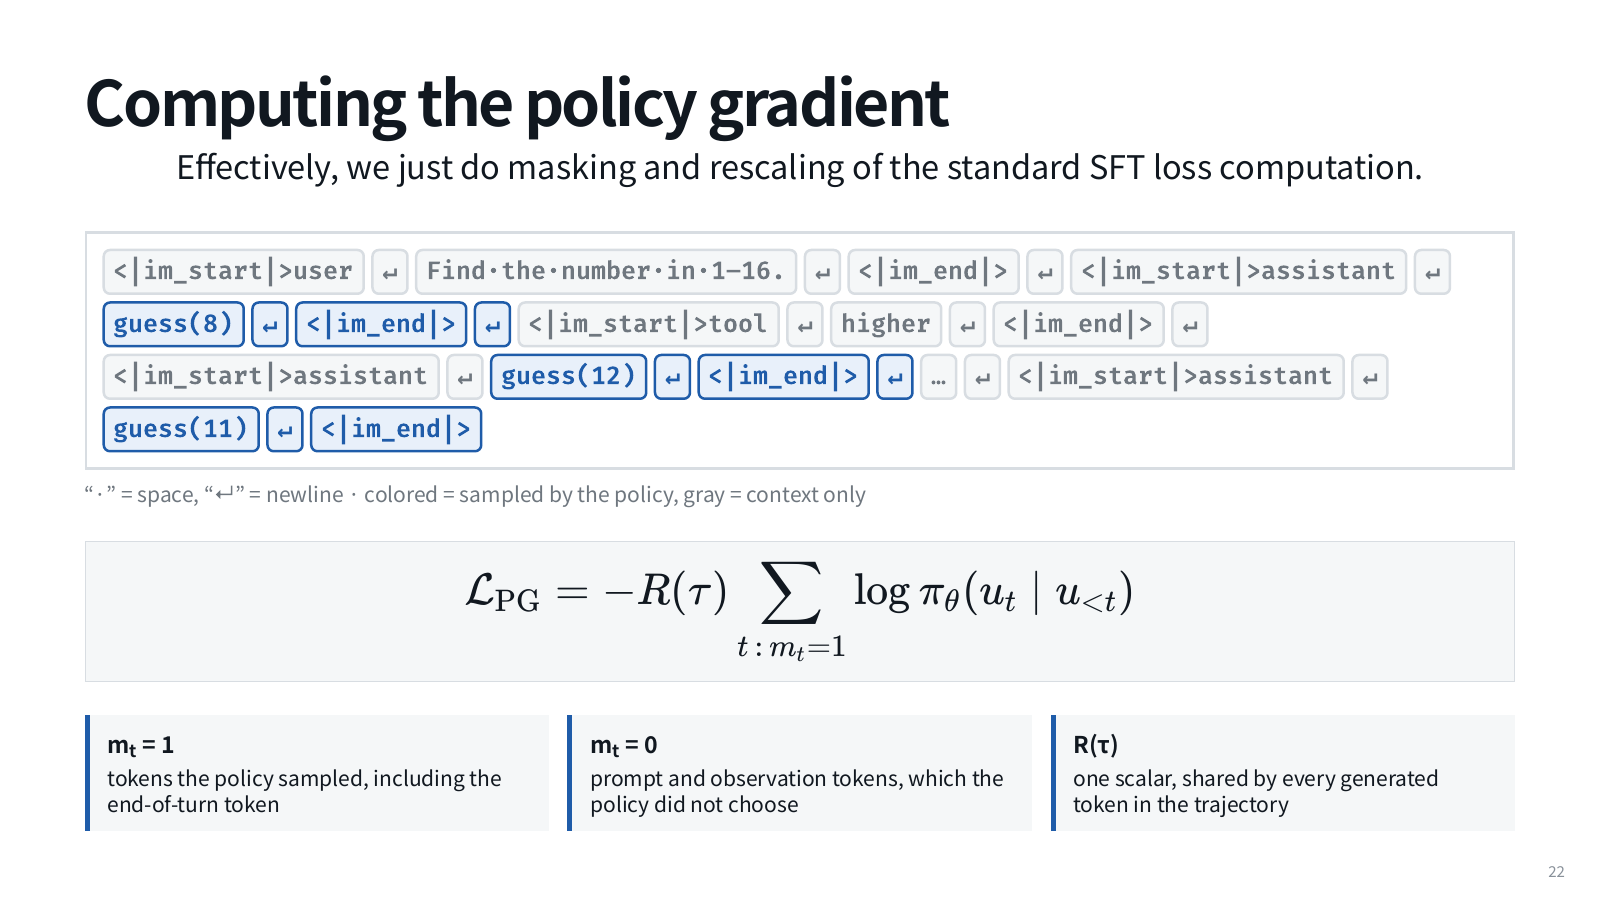
实现中经常使用梯度下降,因此把目标写成损失 L=−R logπ(a)。前面的负号用于把“最大化目标”转成“最小化损失”。如果一会儿用梯度上升、一会儿又加损失负号而不说明,就很容易把训练方向写反。学习时先确定优化的是 J 还是 L,再判断符号。
回到多步工具轨迹
一条轨迹有多个模型选择;在环境转移不依赖模型参数的通常设定下,轨迹概率里需要对模型求导的部分来自策略。乘积取对数变成求和,所以会出现各步 logπ(a_t|h_t) 的和。历史 h 包含之前的观察,它会影响动作概率,但观察本身不是策略采样出的动作。
奖励究竟推动哪个方向
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
p(A)=0.25,采样A,R=1,学习率0.1
- 1. 计算斜率
d log p(A)/dθ=1−0.25=0.75。
- 2. 乘奖励
1×0.75=0.75;梯度上升增量0.075。
- 3. 回到概率
θ从−1.0986到−1.0236;sigmoid约0.2643。
d log p(A)/dθ=1−0.25=0.75。
先预测,再核对结果与原因
A的概率从0.25提高到约0.2643。正奖励沿A自己的概率梯度更新,不是直接把概率增加0.1。
只给成功加权,会漏掉什么信号?
若奖励只有 0 或 1,最基本的 REINFORCE 对失败轨迹给权重 0。乘积是零,不产生这条轨迹的更新信号;“没有加强失败”与“主动压低失败动作”不同。下一课减去基线后,失败可能得到负权重,才会出现明确的相对惩罚。
再看一个边界:一条成功轨迹先重复查询了三次,最后仍答对。把同一个终局奖励乘给全部动作,可能连这些多余查询也一起提高概率。策略梯度是优化期望回报的估计方法,不是自动识别每一个动作是否必要的裁判。若希望更短轨迹,可以设计费用项或更细回报,但这会改变优化目标,需要解释何时接受效率与正确率的取舍。
大模型里参数共享,更新一个样本也会影响其他上下文;优化器、批量平均与约束还会改变实际步幅。因此这里的 0.2643 是二动作模型的一步精确计算,不是预测真实 Agent 一次训练就会提升多少成功率。真正的验收是:同一实现能在小例子中给出正确梯度方向,在独立环境任务中给出可重复的改进。
本课锚点:奖励决定这条样本的权重,概率梯度决定参数该往哪里走。 下一课会问:奖励都大于零,是否还应该全部加强?
把概率与参数的变化分开算
这里的0.075是参数θ的改变量,不是动作概率直接增加0.075。概率经过sigmoid后只从0.25变为约0.2643。如果把学习率从0.1改为0.01,采到A且奖励1时θ只增加0.0075,概率变化更小;方向相同,步长不同。多动作softmax还会同时重新分配其他选项概率,不能把这个两动作数值直接套到所有工具上。
奖励乘2会在这次普通梯度步骤里把该样本权重乘2;但若优化器还有归一化、裁剪或动量,最终参数位移不一定严格翻倍。学习率、奖励尺度、优势归一化都影响实际步幅,排查时应分别记录,避免把相同公式下不同配置的曲线直接比较。
用自己的话核对一次
奖励1、学习率0.1,是否表示动作概率增加0.1?
展开解释
不是。学习率乘的是参数梯度,概率还需经过参数化映射。在本课A样本中参数加0.075,概率约从0.25变为0.2643。
为什么工具返回的库存数字不应直接进入策略动作损失?
展开解释
库存由环境生成,策略没有选择这些token。它们影响后续动作的条件输入,但应通过掩码排除直接生成损失。
没有奖励的失败轨迹在基本REINFORCE里被主动惩罚了吗?
展开解释
权重R=0时没有这条样本的梯度,不等于给负梯度。相对基线会让低于预期的样本得到负优势。