模仿正确答案已经够好了,为什么还需要强化学习?
从“会跟着示范走”到“自己走错了怎么办”
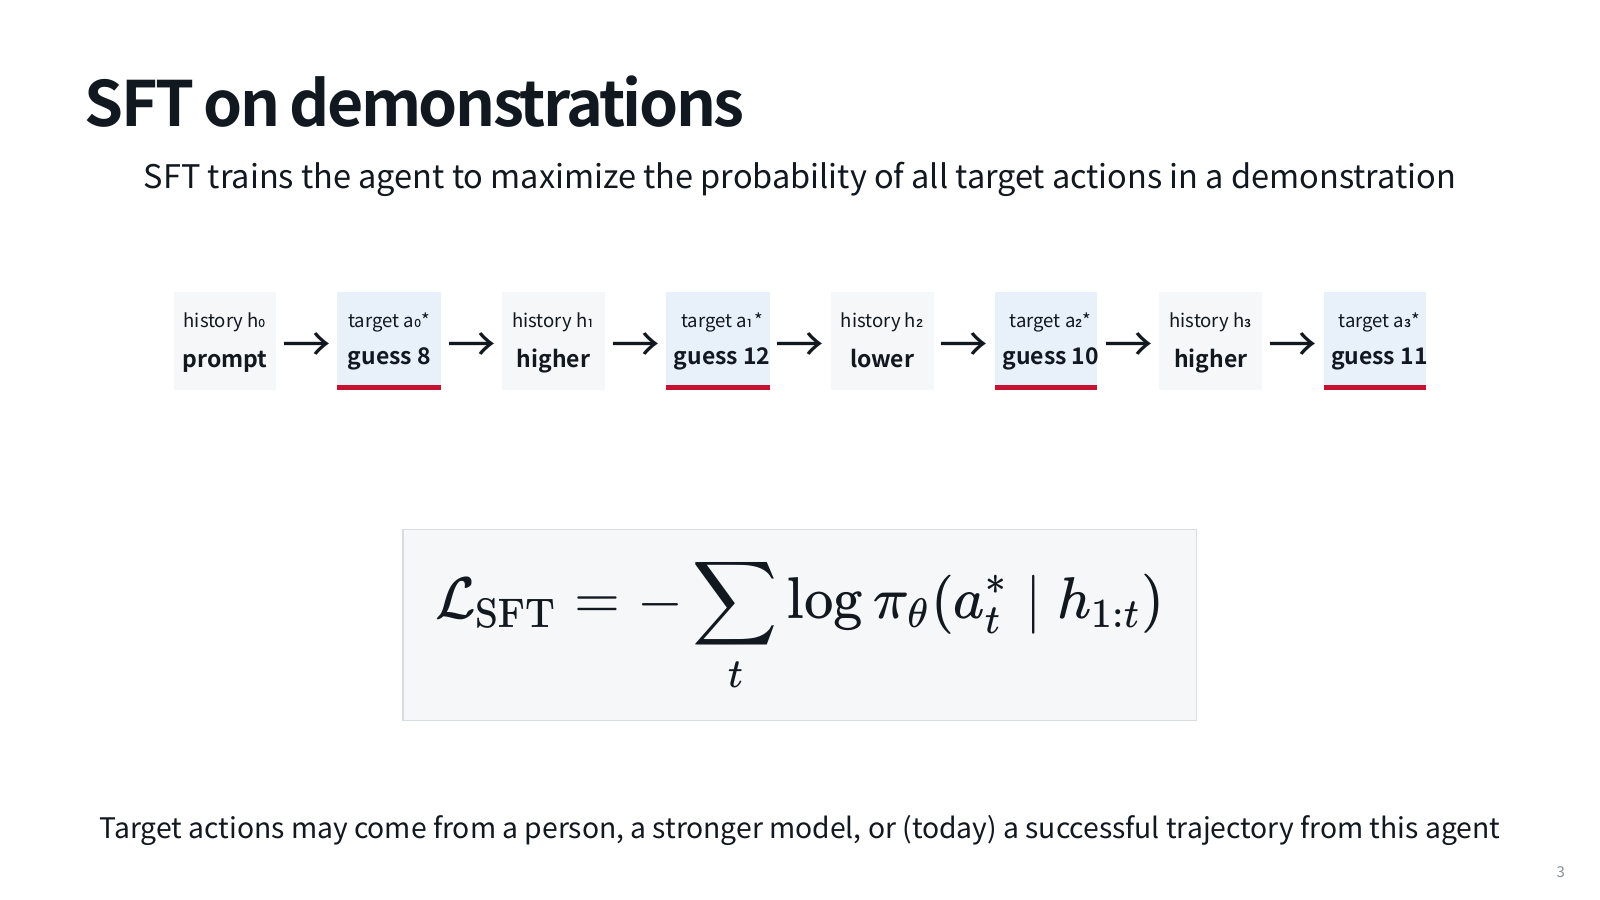
前面已经把一条工具轨迹拆成了消息和训练目标。SFT(监督微调)让模型在给定历史下提高示范动作的概率。现在换用原课的猜数环境,是因为它能给出明确的环境反馈,不用先争论一段文字好不好。隐藏数字固定为 11,可猜范围为 1 到 16;工具只回答偏小、偏大或正确。本课讨论学习信号从哪里来,暂不展开分布式训练。
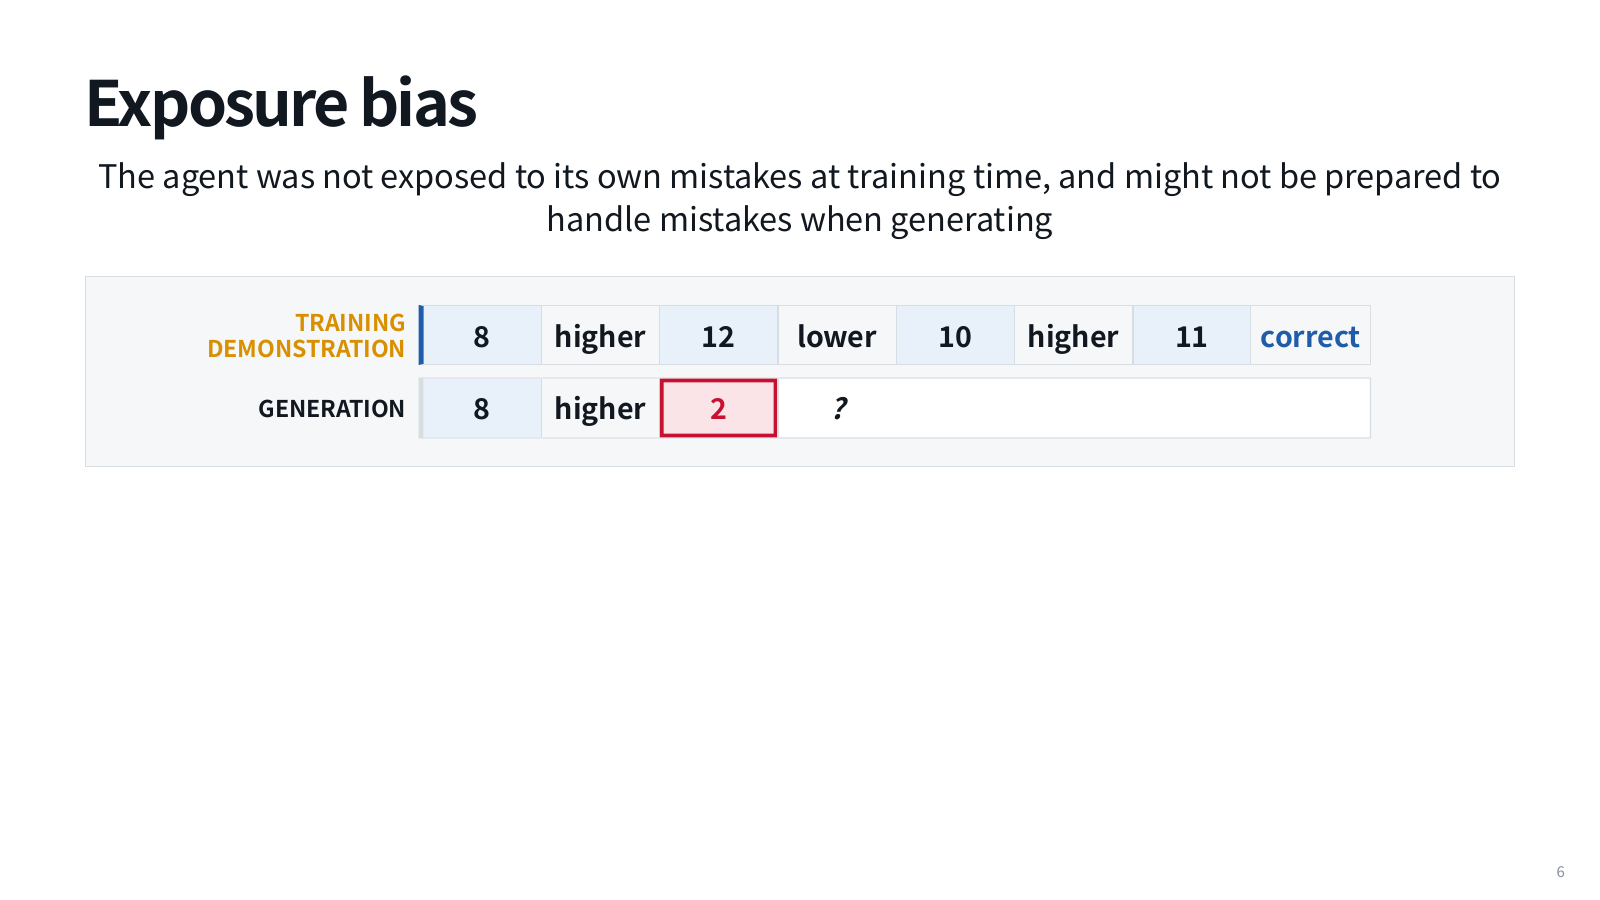
一条成功示范是:猜 8,得到偏小;猜 12,得到偏大;猜 10,得到偏小;猜 11,正确。学习这条轨迹很有用:模型看到区间缩小时,应该怎样选择下一个查询。但训练中的历史都是这条示范走出来的。如果实际生成时第二步猜了 2,它就到了示范里没出现的历史:已经知道大于 8,却又做了一次无效查询。
最朴素的补救是再重复原来的正确轨迹。这会继续强化“在正确历史下选正确动作”,却没有直接教它从这个新错误状态恢复。问题不是监督学习天然不能处理错误,而是当前数据没有覆盖自己会遇到的状态。你当然可以补充纠错示范;但人工或教师需要先找到这些状态并为它们给出动作,覆盖成本会增加。
让当前策略自己试,再看任务结果
强化学习把采样也纳入训练循环。先用当前模型在环境里实际行动,保存每一次动作、观察和终止状态;再由评价规则给结果打分;最后调整策略,让高期望回报的行为更容易出现。这里的“策略”就是在当前历史下选择动作的概率分布,不是另一个神秘的规划器。
我们构造四条尝试,规定在步数预算内猜中得 1,否则得 0。两条猜中、两条超时,平均回报为 (1+1+0+0)/4=0.5。这个 0.5 只描述这四次尝试,不证明模型对所有数字有 50% 成功率。训练使用它构造更新信号;验证则要在另一些任务上重新运行。把训练批次的奖励和独立能力混成一条曲线,会掩盖记忆训练题或钻评分漏洞的情况。
同一条正确轨迹,两个目标关心的事情不同
监督目标会问“给定这段历史,示范动作的概率够不够高”;强化学习目标会问“按这个策略继续行动,任务回报的期望会不会提高”。隐藏数是 11 时,先猜 8 和先猜 12 都可能成功。若只模仿一条示范,另一路径并不自动获得同样的训练目标;环境奖励可以承认多种成功路径。
但只有末尾的一分,也更模糊。成功轨迹里可能浪费了一步,失败轨迹里可能已经做对了前三步。奖励告诉我们整次表现,并不自动标注每个动作的因果功劳。接下来几课会把这一缺口拆成策略梯度、基线和信用分配;现在先不要把“得到奖励”理解成“每一步都已得到精准指导”。
同一任务,比较两条历史
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
隐藏数11,示范前两步8→12
- 1. 第一次查询
8偏小,区间变为9到16。
- 2. 第二次查询
12偏大,区间变为9到11。
- 3. 继续查询
10偏小,再猜11,第四步成功。
8偏小,区间变为9到16。
先预测,再核对结果与原因
4步内成功,奖励1。输入历史和示范一致;这条轨迹能作为监督目标。
改一个条件,检查结论是否还成立
把步数预算从 4 改成 2,即使采用合理的二分策略,也不保证每个隐藏数都能在两步内命中。成功率下降可能来自任务定义更苛刻,不应直接归因于模型退步。因此比较训练前后时,要固定任务、预算、工具行为和评价规则。
再把反馈从“偏大/偏小”改成只有“没猜中”。可用信息少了,同样的选择方法会失去优势。训练不能从不存在的观察里恢复区间信息。这也是为什么 Agent 学习效果同时依赖模型、环境接口和奖励,而不是只由优化器名字决定。
真正要拍板的是:当前瓶颈是格式不会、示范覆盖不足,还是执行时需要探索与反馈?不会基本工具格式时,先做 SFT 通常更容易获得可用起点;已有可执行策略和可靠奖励后,再评估 RL 是否带来留出任务上的改善。不要把训练过程更复杂当作更先进的证据。
本课锚点:SFT 学示范中的动作;RL 让当前策略亲自行动,并根据结果改变以后怎么选。 下一课要把“根据结果改变”落实为一个能手算的概率更新。
用自己的话核对一次
多重复正确示范一定能修复实际生成中的每种错误吗?
展开解释
不能保证。只有当前数据覆盖了那些错误历史及纠正动作,监督目标才直接指导恢复;泛化可能发生,但需要执行验证。
四次尝试两次成功意味着什么?
展开解释
只意味着这个批次经验平均回报是0.5。要评价能力,需要固定条件下的留出任务和足够样本,不能把四次结果当成总体结论。
为什么学习工具格式与提高完成率可能适合不同阶段?
展开解释
格式有明确示范可模仿,SFT能建立起点;完成率涉及自己的动作导致的新状态与终局反馈,RL可以继续优化,但依赖可靠奖励和可采样环境。