训练时会调工具,部署后为什么突然不会了?
上一节已经整理了高质量、覆盖合理的轨迹,训练 loss 也下降。部署后模型却输出工具无法解析的字段,或一直生成不肯交接。这不一定是任务知识没学会:训练与运行可能给了两套不同的接口。本课检查序列、工具协议与状态分布的接缝,先不归因到模型规模或训练轮数不足。
一个字段就能切断整条循环
假设训练示范的文件工具叫 read_file,参数名是 path。模型学到的有效调用是下面这个教学协议;这不是某厂商 API 的通用格式。
{"name":"read_file","arguments":{"path":"config.py"}}部署工具却要求 filename,严格校验时,path 会被拒绝。模型可能正确识别该读 config.py,仍没能让执行器打开文件。语义上“知道做什么”,不等于序列化形式符合运行契约。
这里先固定模型输出不变,只更换宿主接受的字段,就能复现成功与失败的差异。这个最小对照比重新训练整个模型更快揭示边界问题。若使用适配器,可以把规范化动作映射成宿主字段,但必须确保含义一致,不能靠简单改名掩盖不同工具的行为差别。
同一个动作为什么突然不能执行
保持模型输出固定,只切换执行器要求的参数字段。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
模型固定输出 read_file,arguments 中为 path=config.py
- 1. 接收调用
执行器要求 path,发现必需字段存在。
- 2. 执行动作
读取 config.py,并把真实结果作为工具观察返回。
- 3. 继续循环
模型在包含该观察的下一轮输入中继续判断。
执行器要求 path,发现必需字段存在。
先预测,再核对结果与原因
这条固定请求能通过接口。训练动作与运行契约一致。
两条回放的任务、模型输出和文件完全相同,只改变执行器接受 path 还是 filename。这是协议固定样本的回放,不是声称模型遇到新 schema 后必然永远无法适应。
聊天模板改变的是模型真正收到的序列
保存为 JSON 的消息还要经过聊天模板:把 system、user、assistant、tool 角色、分隔符和结束标记渲染成模型输入。两段内容看起来都写着“测试通过”,一段来自 tool,一段来自 user,在模板里可能是不同序列;模型对它们的理解也可能不同。
不能只比较业务文本而忽略边界。检查时取同一条轨迹,分别用训练路径和部署路径序列化,按段对齐:系统指令是否一致、工具 schema 是否包含同名字段、观察角色是否保留、助手生成起始位置是否正确。不同模型的模板标记不同,不应把课件上的特殊 token 随意复制到另一个模型。
三种“结束”不要混成一个事件
助手结束当前消息、把控制权交给工具、声明整个任务完成,可能是三种不同的边界。如果运行时把“调用消息结束”误认为“任务结束”,第一次工具调用后就会停;如果没有正确识别工具交接,模型可能继续在文本里编写观察。
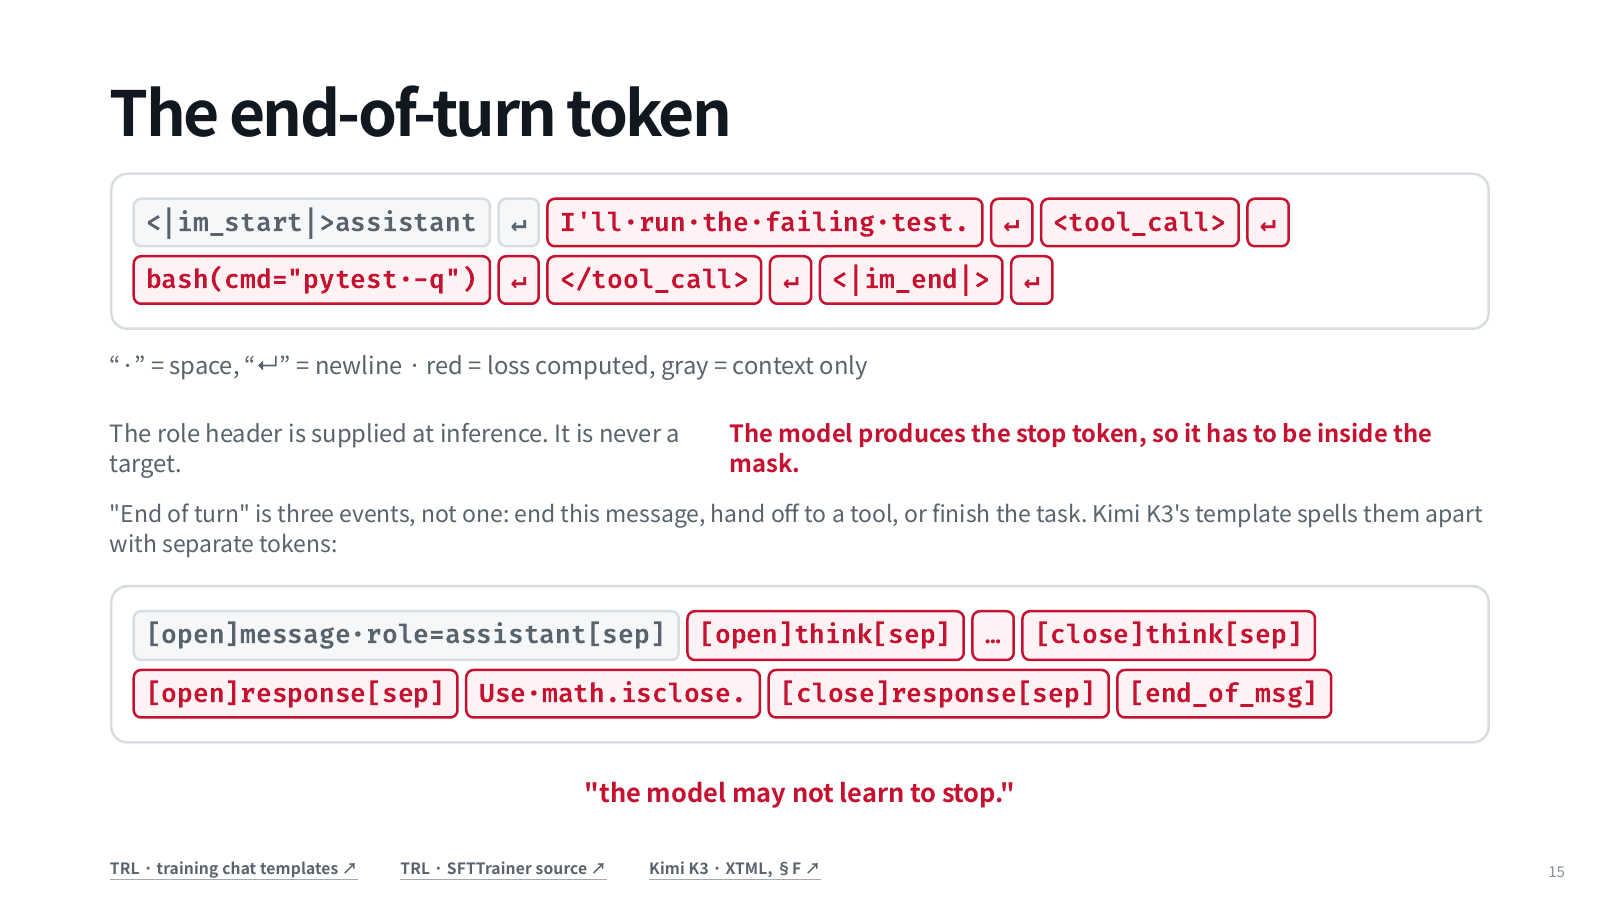
第 39 节的 mask 在这里兑现。若训练时把助手结束标记全部忽略,模型可能没有学到需要的停止行为;若训练标记正确但运行 stop 配置不同,也会失败。两者症状相似,却分别属于训练标签与执行协议,应该分开验证。
推理文本也需要明确处理。如果数据中调用前包含某种 reasoning 区块,部署时把它剥离、换边界或截断,都会改变模型的上下文。不是所有变化都会造成失败,但都不能假设毫无影响。应保存可复现的序列对照,而不是只写“使用同一个提示词”。
模板完全一致,为什么仍然可能走偏
监督训练常使用示范前缀,模型预测下一步后继续看到示范里的真实后续。运行时却由模型自己的行动改变环境:示范编辑 A 后测试通过,模型编辑 B 后测试失败,下一轮就来到示范没覆盖的状态。这叫训练与自身运行状态的分布差异。
它与字段不匹配不是同一个问题。前者要增加对真实中间状态的覆盖、反馈与恢复能力,后者先修接口契约。把两类都称为“模型退化”,容易用更多训练掩盖一个可以直接修复的解析错误。
从最小例子向完整任务逐层验
先挑少量能确定答案的样本,确认训练管线能把它们学到。原课建议先过拟合二十个例子作为管线排错手段:若 loss 根本降不下来,优先检查数据、标签、掩码、训练配置。它不是泛化评估,更不能把这二十题的高分当最终能力。
然后用协议固定样本检查调用能否解析、执行、接回观察和继续生成;再做一个真实可验证的小任务;最后扩展到保留任务集。每一级失败都尽量留在本级诊断:解析没过就别先调奖励,环境没重置就别比较模型排名。
你要拍板与验收的边界
将模型、tokenizer、聊天模板、工具 schema、结束规则、观察格式、上下文裁剪策略作为同一套运行配置记录版本。改一项就用相应的最小回归样本检查。迁移到新宿主时,先决定保持规范化动作还是重新渲染示范,不要让训练端和运行端各自猜字段含义。
验收至少保留一次完整工具循环:模型发出可解析调用,工具真实执行,观察带正确关联信息返回,模型根据观察继续并最终停止。再检查没有工具需求的普通回答,防止修复调用流程时把原有能力破坏。
模型学到的是在特定序列与环境中选择行动;部署必须接住同一套协议,还要检查它自己走出的状态。 下一阶段会把监督示范之外的尝试也纳入学习,利用实际反馈改进这些自身运行轨迹。
理解题 1:模型输出文件路径正确,为什么工具仍拒绝?
参数名或格式可能不符合 schema。值的业务含义正确与请求结构合法不同,应先检查执行器收到的实际请求。
理解题 2:二十条训练样本全会做,证明新仓库也能做了吗?
没有。小集过拟合用于排查训练管线,泛化必须在未参与训练的任务或仓库中运行,并检查闭环结果。
理解题 3:模板和工具完全相同,为何线上还可能出错?
模型自己的动作会产生示范里没有的观察和状态。协议对齐消除一类问题,但没有自动解决偏离后恢复与分布变化。