都是一百条成功轨迹,为什么训练效果可能完全不同?
上一节确认了哪些助手位置进入 loss。现在模板和掩码都正确,却仍不能只凭“收集了一百条成功数据”判断训练价值。轨迹包含什么任务、怎样成功、有多长,都会改变模型实际看到的行为。本课讲数据选择与训练信号的账目,不给一个跨模型通用的最佳数据配比。
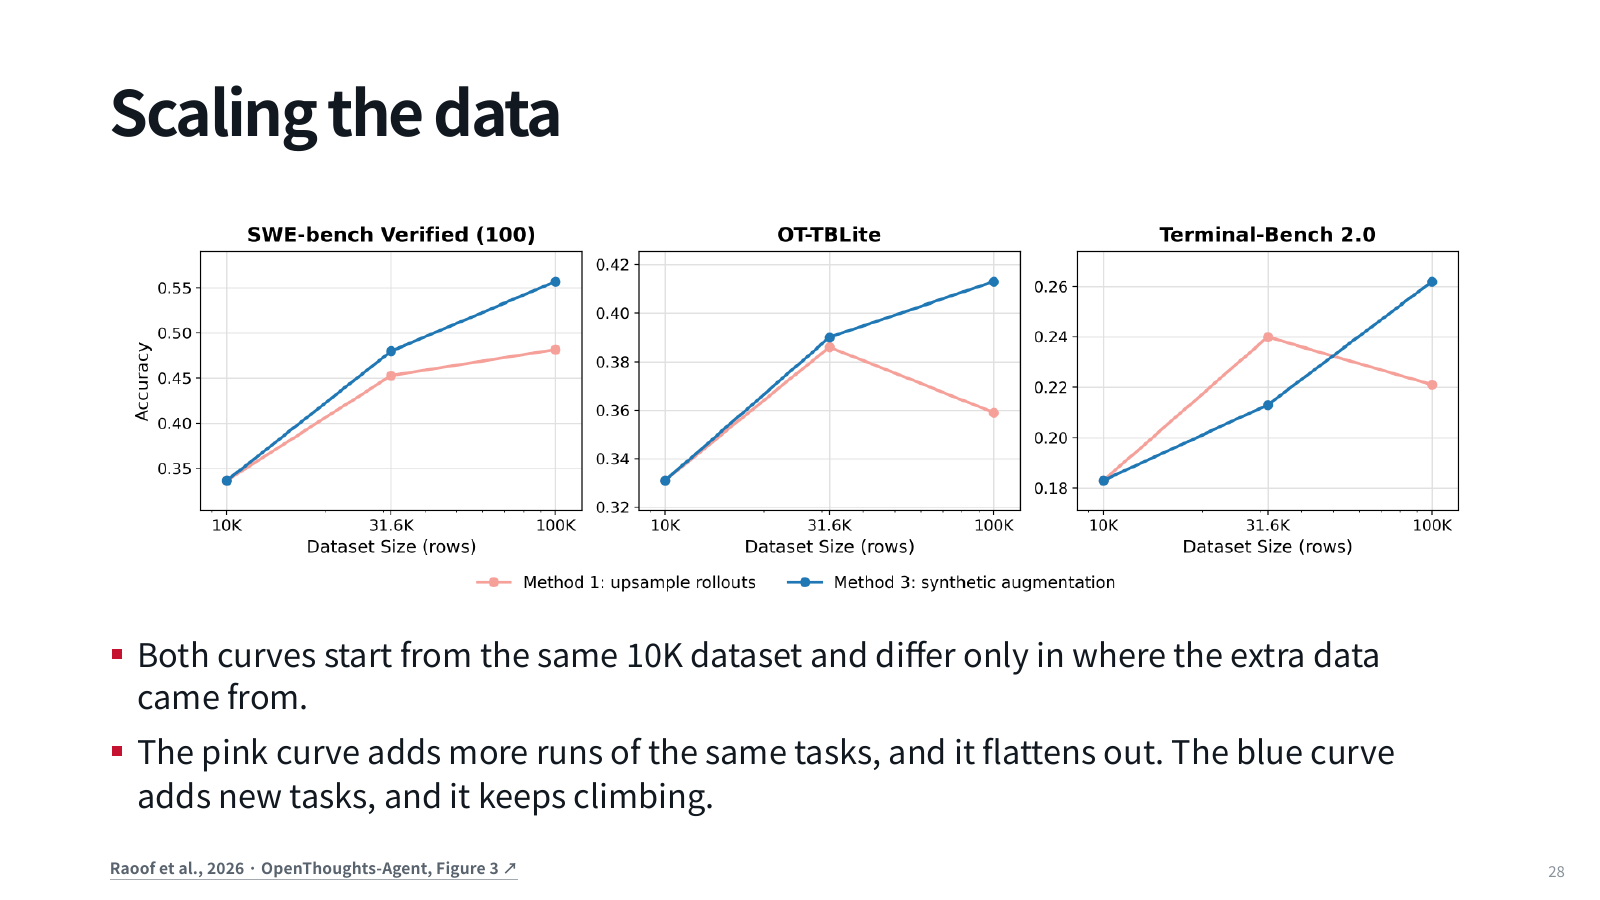
一百次成功,可能只覆盖十种问题
设数据集 A 来自 10 个任务,每题重复采样 10 条成功轨迹,总数 100;数据集 B 来自 100 个不同任务,每题一条,也是 100。A 更充分展示同题不同解法,B 覆盖更多问题。若目标测试强调新任务泛化,两者提供的信息不同;不能因为总条数相同,就认为训练信号等价。
这也不意味着 B 必然更好。一百个不同任务若都不属于目标领域,可能不如十个高质量代表任务;新任务如果大部分简单重复模板,名义数量也夸大多样性。应该同时记录任务来源、难度、工具类型与错误类型,而不是只数文件个数。
通过测试,不代表每一步值得模仿
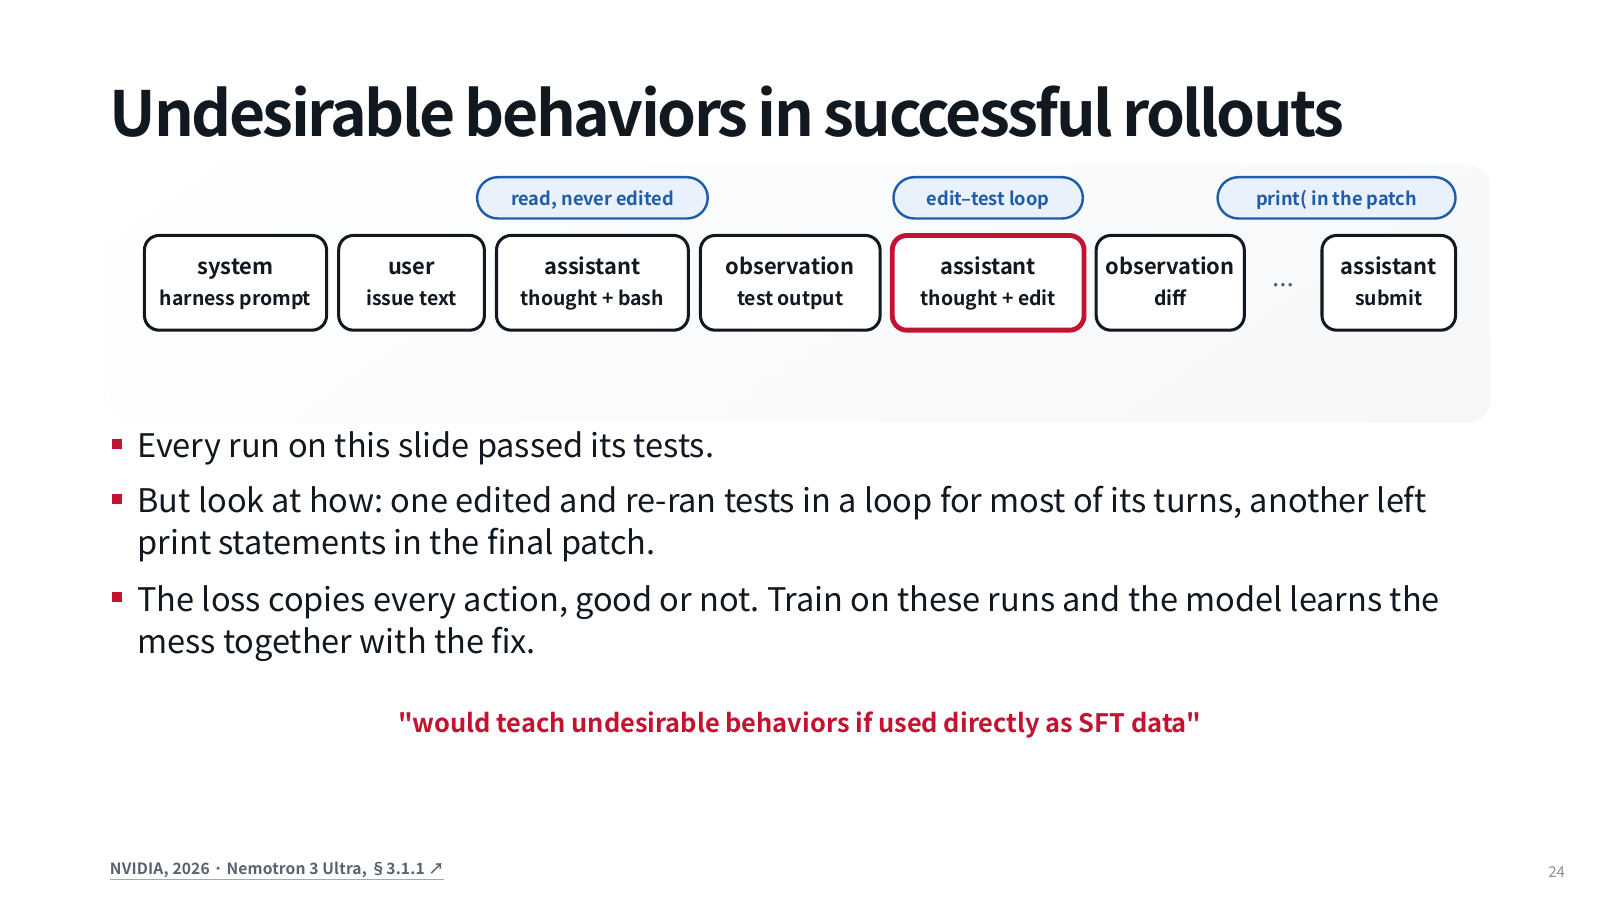
继续重试次数修复任务。轨迹甲四步完成:复现、定位、修改、回归;轨迹乙先错误地把默认值改成 0,看到回归失败后恢复并做正确修复;轨迹丙连续执行十一轮没有改变任何文件的测试,最后碰巧切到正确文件才通过。
甲提供直接有效的路径;乙提供如何利用失败反馈恢复的行为;丙的大段重复未带来新信息。只保留最终成功会把这些都喂给模型。第 39 节已经说过,SFT 会提高记录中目标行动的概率,不会因为最终成功就自动识别中间哪一步是坏习惯。
不能靠“越短越好”解决
如果简单删除所有长轨迹,会丢掉乙这种有价值的错误恢复示范;如果规定至少五轮,又会删掉干净的四步甲。轮数只是过程长度的代理,不直接说明质量。应判断某一步是否获得新证据、改变有效状态、验证假设或恢复错误。
想删除坏步骤也不能随意剪切。乙后面的“撤销刚才的改动”依赖前面的错误编辑;删掉错误行动却保留撤销,就会让状态对不上。可以保留连贯轨迹但对部分位置采用明确的监督策略,也可以重新执行产生干净示范;不能伪造一个从未成立的工具返回。
成功轨迹要看怎样成功
先判断每一步是否提供新信息,再比较长度与教学价值。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
目标相同:保留显式0且通过默认值回归
- 1. 复现与定位
看到 3 != 0 并找到 or 3。
- 2. 修复
只对 None 使用默认值。
- 3. 回归
检查缺省、None、0、2,行为均符合约定。
看到 3 != 0 并找到 or 3。
先预测,再核对结果与原因
短轨迹,每一步都推动任务。不该仅因少于某个轮数阈值就删除。
比较固定的短直接轨迹和长恢复轨迹。回放不是说长一定更好,而是让你看到“有没有必要的新信息”比长度本身更接近我们想训练的行为。
按条数平衡,为什么按 token 看又失衡
设一百条样本中,90 条每条有 100 个有效目标 token,10 条每条有 1000 个。它们是用来演算的数据长度输入,不是某模型 tokenizer 的实测。短组贡献 90×100=9000,长组贡献 10×1000=10000,总计 19000。
长轨迹只有条数的 10%,却占目标 token 的 10000÷19000≈52.63%。如果采用把所有有效 token 等权平均的训练口径,它们在 token 账目里已经超过一半。若训练器先按样本平均再聚合,权重会不同;所以既要看长度,还要检查实际 loss reduction 和采样方式。
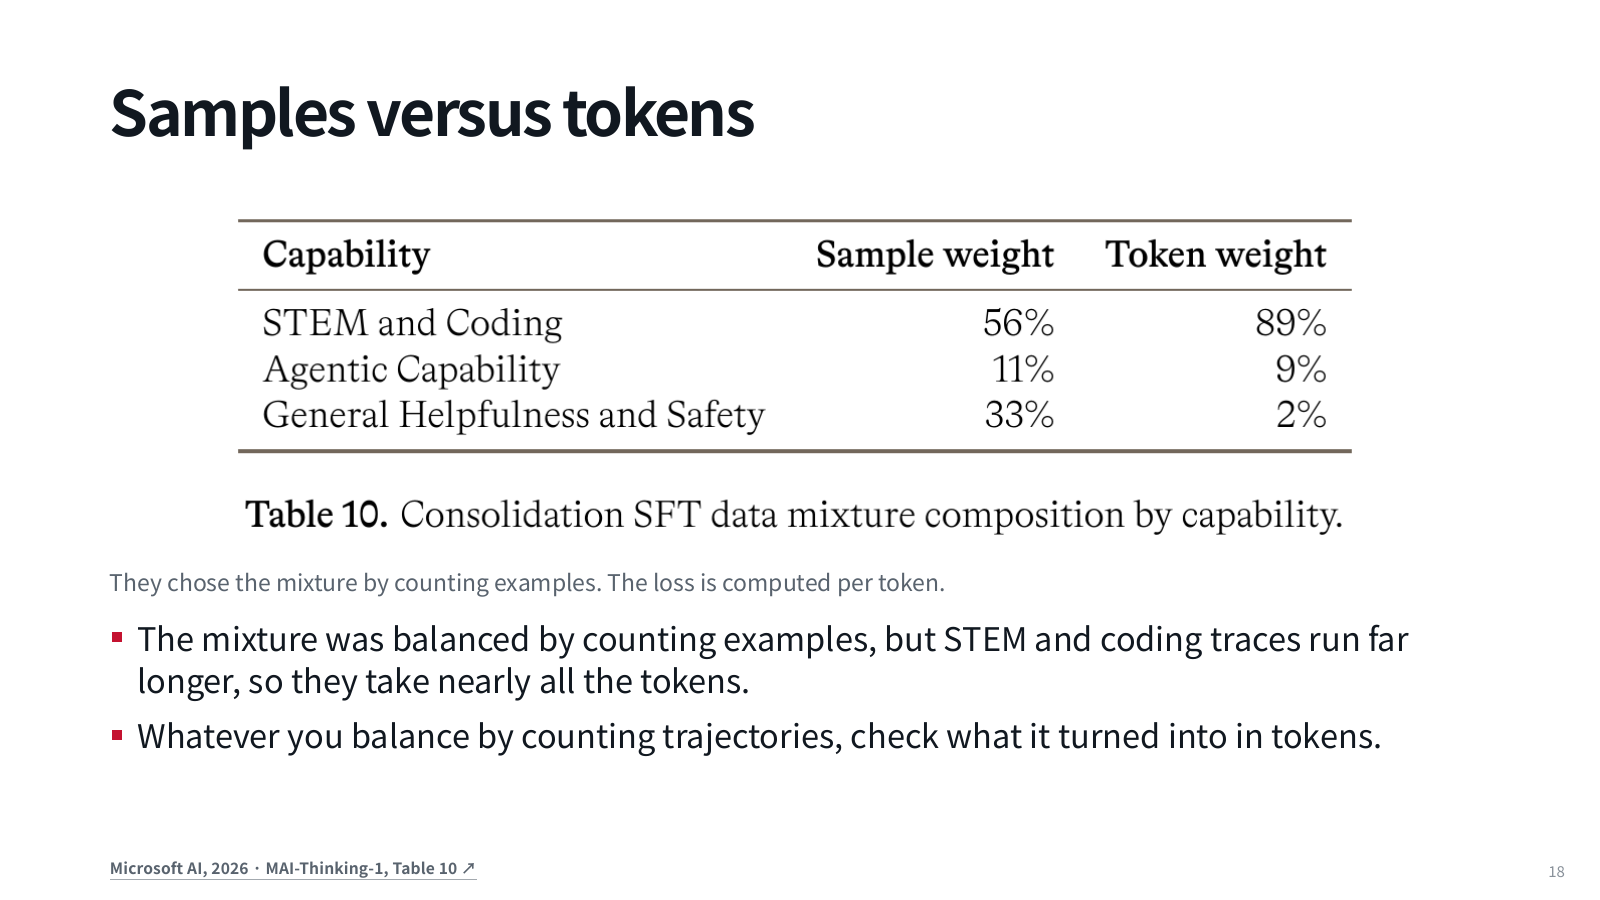
同一条轨迹内部也可能失衡。900 个推理 token 加 100 个调用 token,在简单等权口径下调用只占 10%。但实际任务可能对工具参数的精确性极敏感。加权或重采样是可探索的方案,具体权重需要验证;不能因为“动作重要”就任意把所有说明文本删掉。
教师强,不等于它的数据最适合学生
教师自己能做对更多题,不保证其长上下文策略、工具格式和推理风格适合较小学生。学生可能只能复制表面,不能维持老师的长程依赖。要用目标学生在保留任务上的结果检验数据价值,而不是只根据教师榜单分数选择。
数据切分也必须避免同一任务的十条轨迹散落在训练与测试两边。否则所谓“新问题表现”可能只是看过近似轨迹。若要声称跨仓库泛化,应按仓库隔离;如果只声称同一类任务的新运行,也要明确这个更窄的边界。
需要拍板的不是一个总数
先定义目标任务分布,再决定覆盖与重复的预算;同时检查结果标签、过程连贯、冗余动作、真实目标 token 分布与训练归一化。验收保留小规模基线,在相同训练预算下比较一项数据改动,并检查目标能力与原有能力的回归,避免把“训练 loss 更低”当唯一胜利。
数据量是条数,学习信号还取决于覆盖、行为质量、长度和权重。 下一节即使这些都做好,部署时仍可能失败:因为模型面对的协议与状态不再是训练时那一套。
理解题 1:十个任务各十条成功,与一百个任务各一条,有什么不同?
前者增加同题策略样本,后者增加任务覆盖。对泛化的价值取决于任务相关性和质量,不能只按一百条判等价。
理解题 2:为什么不能直接删掉恢复轨迹中的错误编辑?
后续观察与撤销可能依赖它。随意删除会破坏环境状态因果链,形成模型运行时不可能遇到的示范。
理解题 3:长轨迹占条数10%,就只影响10%的训练吗?
不一定。例子中它们占有效token约52.63%;实际权重还取决于采样和loss归一化。必须同时核对实现与长度账本。