给模型看一条工具轨迹,它究竟在学习哪几个 token?
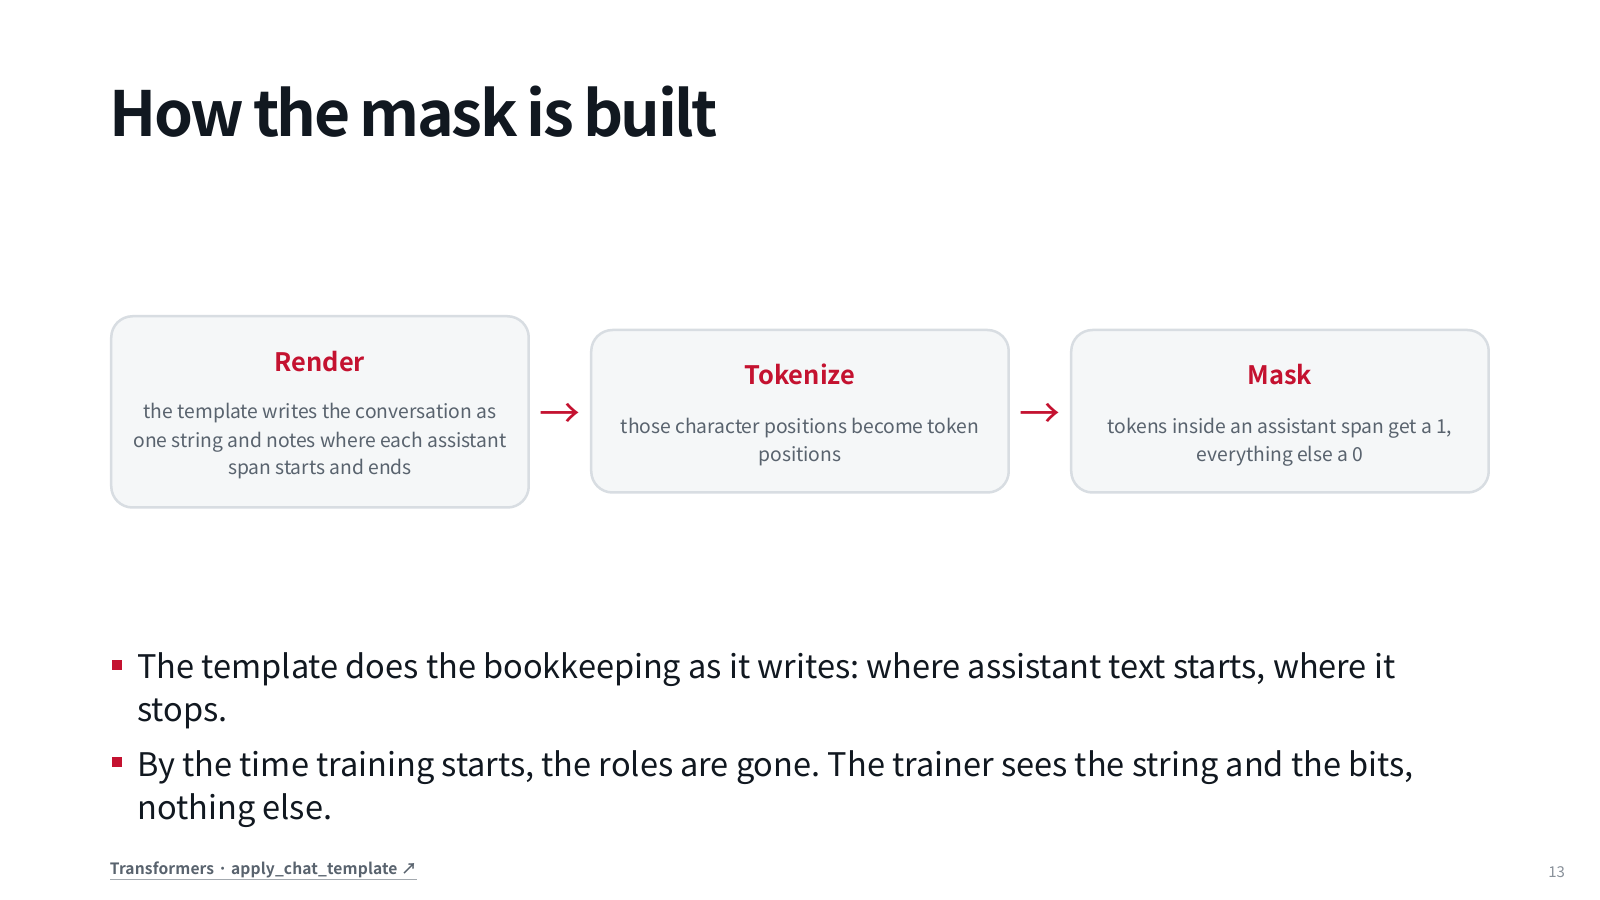
上一节已经会读轨迹中的用户要求、助手行动、工具结果。把同一轨迹用于监督微调时,训练器并不天然理解“这句话是用户说的”。角色先经过模板写成序列,再通过标签与掩码决定哪些位置计入预测损失。本课讲清输入与训练目标的区别,不展开反向传播矩阵运算。
“看见”与“被要求预测”不是一回事
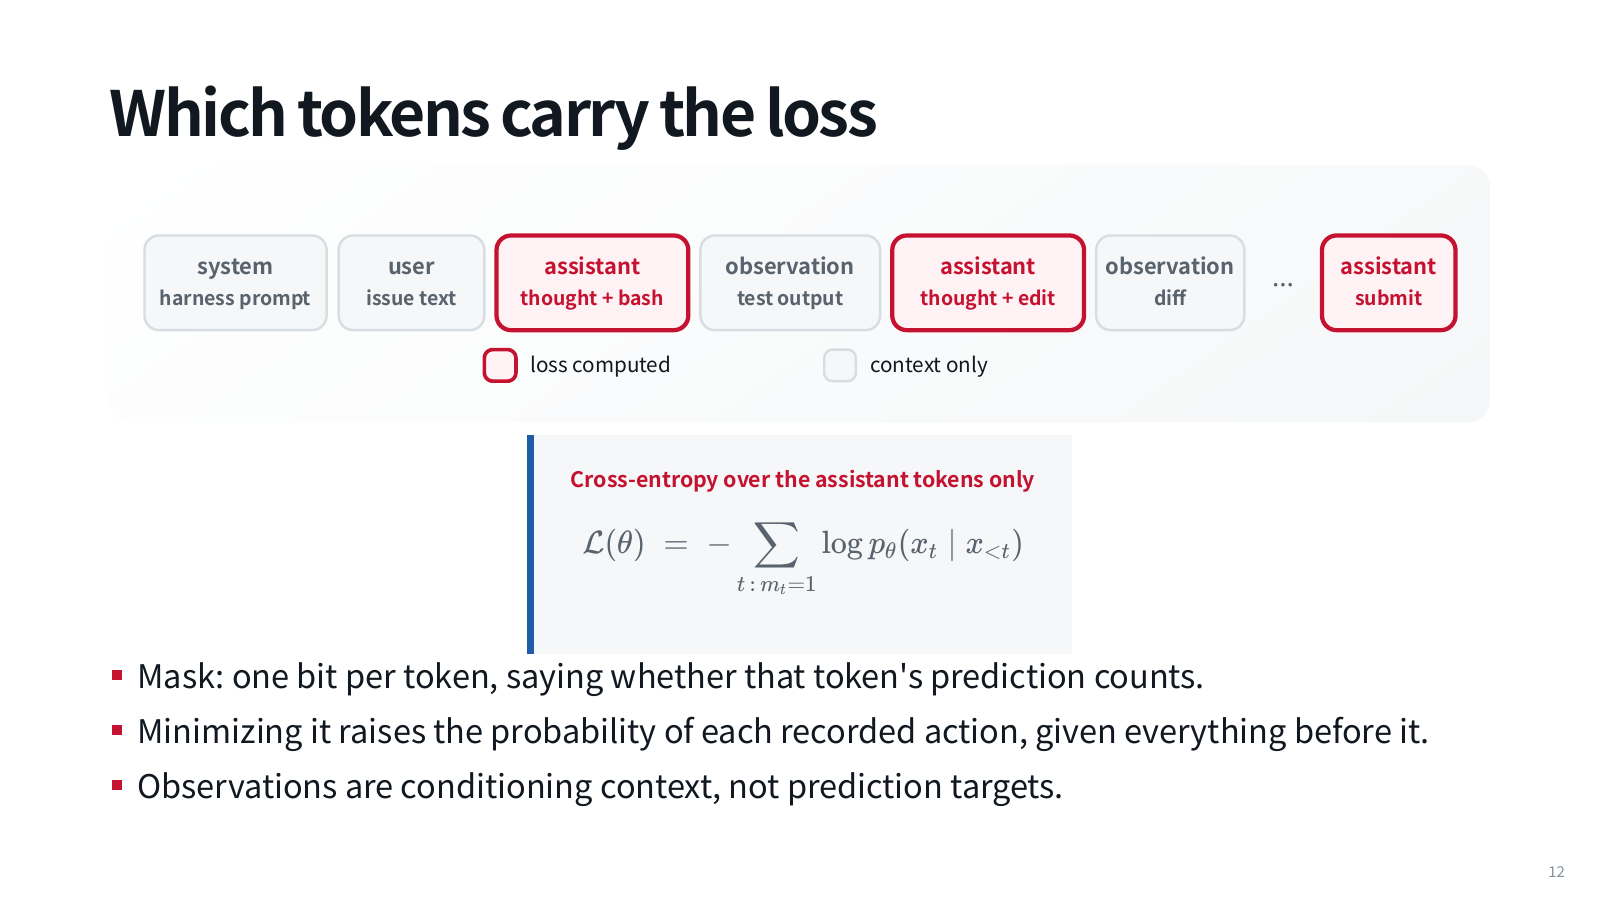
一条最小轨迹可以写成:用户要求读取配置;助手调用读文件;工具返回 retries=0;助手解释应保留显式 0。运行时,用户和工具提供的内容是外部事实,模型负责生成自己的调用与回答。因此常见 Agent SFT 做法是把全部必要消息保留在上下文中,只对助手输出位置计算 loss。
如果把工具结果也作为预测目标,模型就同时在学习“如何预测环境会返回的内容”。这不等于它下一次运行必然会伪造结果,但确实改变了训练目标,并消耗容量去拟合本应由环境提供的文本。能否在某些数据条件下受益需要实验,不能只凭直觉宣布全序列训练永远错误。
掩码到底做了什么
给每个预测目标位置一个 m:1 表示这一位置的负对数概率要计入损失,0 表示忽略该位置的直接预测损失。可写成 L = −Σ mₜ log p(xₜ | x<t)。这里 xₜ 是示范中的正确目标 token,条件是它之前的序列;求和范围与模板边界有关。
工程里还常除以有效目标数得到平均 loss。总和与平均会影响数字大小;必须说明归一化口径,不能把两种日志直接比较。标签通常与输入错开一个位置,因为前面位置的模型输出用于预测下一个 token;若把掩码偏移错一格,可能让工具结果末尾被训练,而助手开头被漏掉。
用四个位置算一次
下面抽出四个教学预测位置:助手调用 token、工具观察 token、助手回答 token、助手结束 token。为了演算,给正确 token 的条件概率分别设为 0.5、0.1、0.25、0.5。这是计算输入,不是实测模型概率,也不声称中文句子被某 tokenizer 切成四个 token。
| 位置 | 正确目标的概率 | 助手训练掩码 | 计入损失 |
|---|---|---|---|
| 助手调用中的一个位置 | 0.5 | 1 | −ln(0.5)=0.6931 |
| 工具观察中的一个位置 | 0.1 | 0 | 0 |
| 助手回答中的一个位置 | 0.25 | 1 | −ln(0.25)=1.3863 |
| 助手结束标记位置 | 0.5 | 1 | −ln(0.5)=0.6931 |
总损失约 2.7726,有效目标为 3,平均约 0.9242。若打开观察位置的 mask,则多加 −ln(0.1)=2.3026,总计约 5.0752,除以 4 得约 1.2688。数字变大不直接说明模型变差;我们改了考题和分母。
只拨动一位掩码,训练问题怎样改变
先预测哪些项参与求和,再按步骤核对自然对数计算。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
四位置概率固定为 0.5、0.1、0.25、0.5
- 1. 选择目标
掩码 [1,0,1,1],观察仍在输入中。
- 2. 逐项求和
0.6931 + 0 + 1.3863 + 0.6931 ≈ 2.7726。
- 3. 明确分母
三个有效目标,平均 loss≈0.9242。
掩码 [1,0,1,1],观察仍在输入中。
先预测,再核对结果与原因
训练助手调用、回答与结束。环境观察影响后续预测,但不直接成为预测目标。
对照只改变观察位置是否计入 loss。所有概率与输入顺序保持不变,先算新增损失,再看平均值变化。它说明训练目标改变,不模拟一次参数更新。
掩码不是注意力遮罩
loss mask 决定“哪些预测得分”,attention mask 决定“一个位置能看到哪些前文”。把工具观察的 loss 设为 0,不会自动让后续模型看不见它。观察仍能影响后续隐状态与助手位置的损失,也可能通过后续计算参与梯度路径;准确表述是它不贡献自己的直接 token 预测损失。
如果干脆删除工具观察,后续助手就失去了读文件内容,需要在信息不足时生成答案。这和保留观察、mask 为 0 完全不同。训练检查时应该同时展示实际序列与掩码,不能只查看一个“assistant_only”配置名字。
为什么结束标记也要学习
助手不仅要生成工具参数,还要交出控制权。原课模板把角色头作为运行时给定内容,而结束标记由模型生成,因而后者需要进入目标区域。不同系统可能用不同标记区分消息结束、工具交接与任务结束;它们不是天然同义。
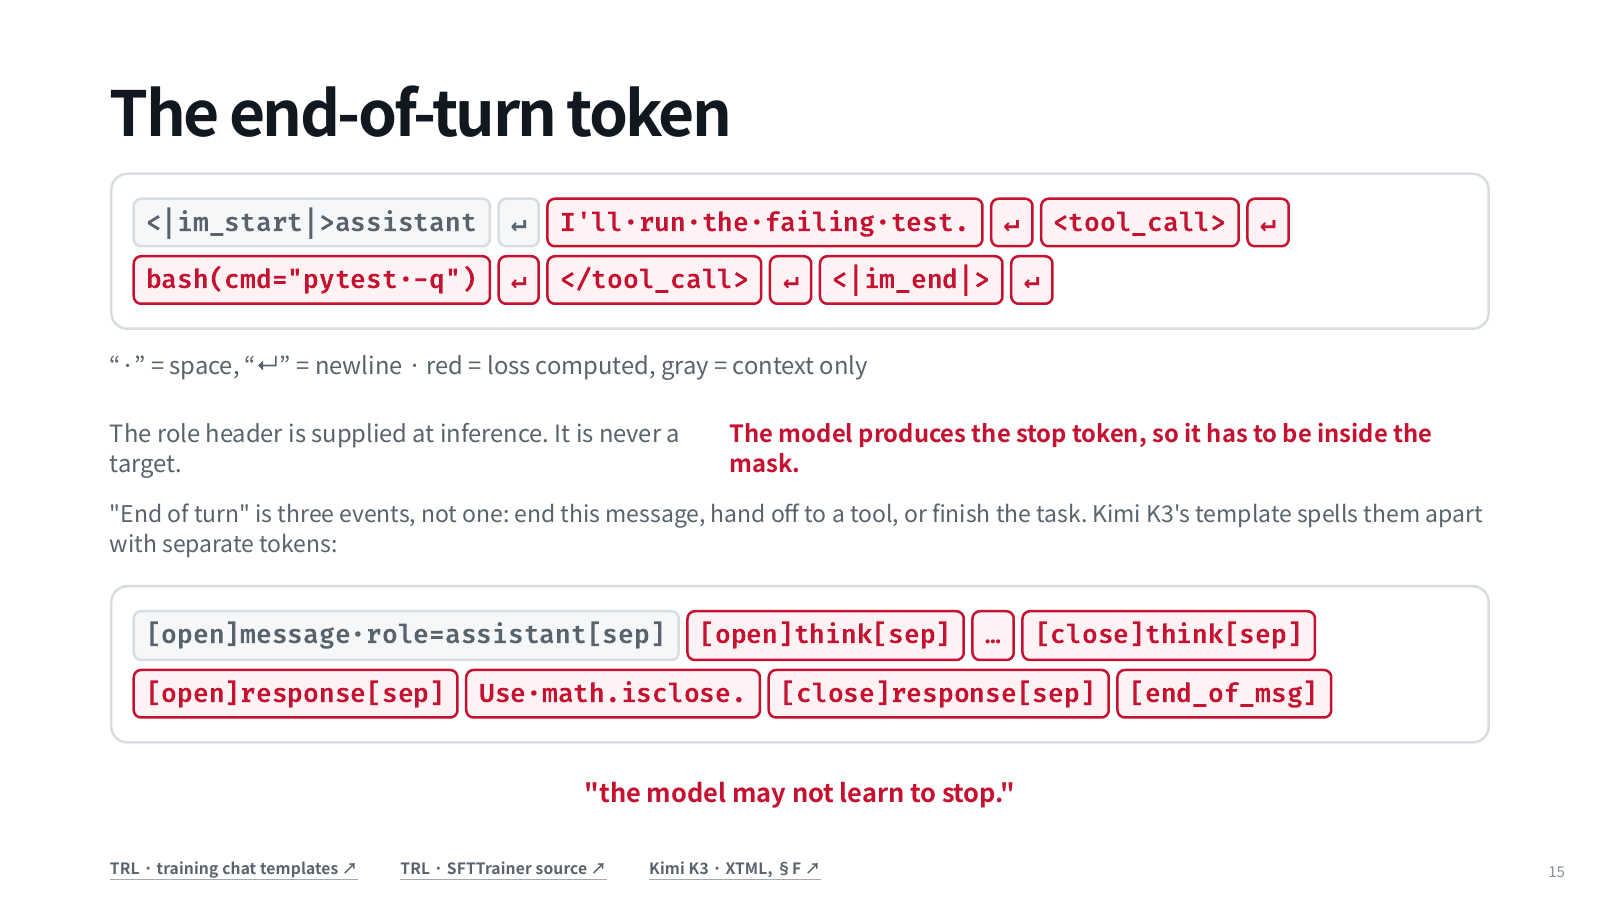
还有一个细节:保留示范里的推理文本与训练模型生成该推理,是两个独立选择。它可以作为上下文但不计 loss,也可以作为助手输出训练;若记录被人为截断,截断处不应被误当自然的结束方式。这些决定必须与目标模型和部署协议配套。
最小验收不是看 loss 曲线下降
随机抽一条样本,解码模板化序列,把有效目标位置着色;检查用户与观察是否按计划被忽略,助手调用和结束是否保留,序列截断后是否还留有有效目标。全零 mask 会让训练没有预期信号,角色边界偏移则可能在错误内容上得到很好看的 loss。
轨迹提供全部必要上下文,掩码明确模型究竟要为哪段输出负责。 下一节保持模板正确,再问:同样一百条成功轨迹,为何仍可能教出不同的行为?
理解题 1:工具观察 mask 为 0,模型后续还能用它吗?
能,只要它仍在上下文且注意力允许访问。loss mask 关闭的是该观察自身的预测损失,不是删除观察或切断全部梯度路径。
理解题 2:加入一个很难预测的工具 token 后 loss 上升,能断言能力下降吗?
不能。训练目标和有效目标数都改变了。必须在同一掩码口径及运行任务上比较,不能直接比较这两个 loss 数字。
理解题 3:结束标记为什么可能比普通文本更影响工具循环?
它告诉运行系统何时停止当前生成并交接控制。即便参数文字正确,缺少正确边界也可能让调用无法执行或继续生成无关内容。