失败轨迹有几百步,怎样找到最值得修的环节?
上一节用逐题比较找到了改善与退步。点开一条失败轨迹,看到几千行工具输出,又很容易被最后一句“操作失败”吸引。真正原因却可能在前面一次读错、一次参数选择或评价器误判。本课建立从原始事件到故障假设的路径,先不讨论自动聚类算法的全部实现。
先定位第一个有证据的偏离
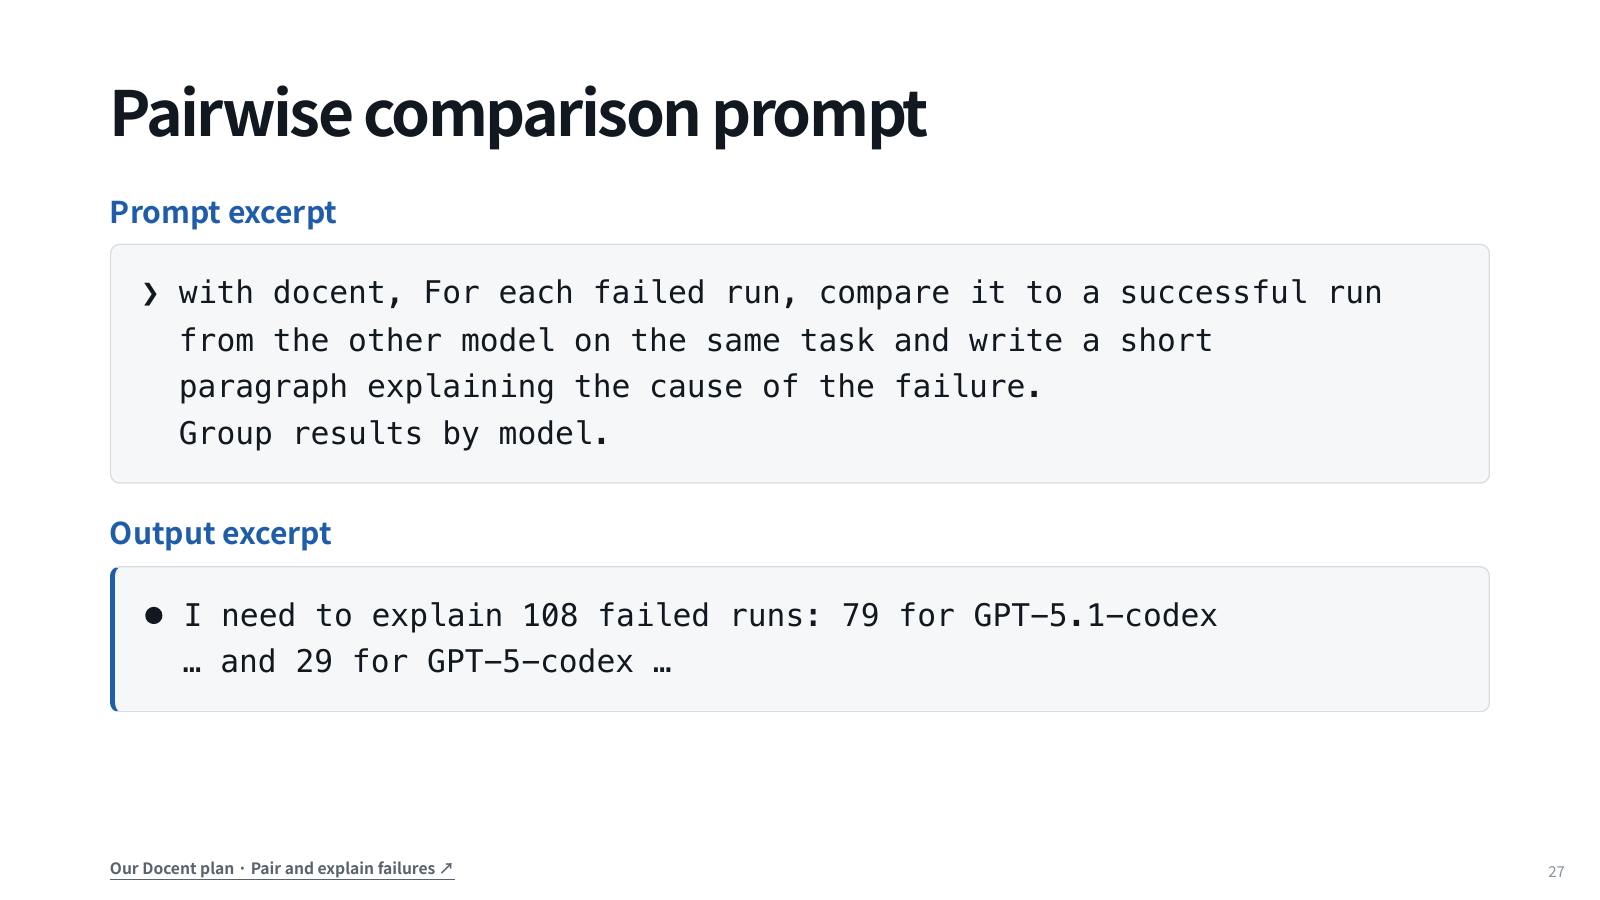
沿用代码 Agent 的重试配置任务。正常过程应是搜索实际函数、读到 or 3、改为 None 判断、运行验证。如果最后测试报“文件不存在”,就要先检查测试路径从哪来的:是模型猜了路径,还是文件工具返回了旧目录?若测试压根没启动,不能把它归为修复逻辑错误。
一次事件至少要保留时间、动作、参数、工具结果和当时的环境状态。模型说“我已经读取配置”不是读取成功的证据;实际工具返回与文件版本才是。可以先用摘要缩短阅读,再跳回事件核对决定性细节。摘要省略了异常码,往往会把不同错误压成一句“工具失败”。
六条记录,不一定是六次模型失败
下面是构造的教学记录,用于练习分类,编号不对应官方 benchmark 运行。它们都在结果表里被标为失败,但原始证据不同。
| 记录 | 可核对事件 | 初步归类 |
|---|---|---|
| T1 | 测试启动后 120 秒被环境终止 | 时间预算或执行瓶颈 |
| T2 | 下载依赖 120 秒后超时,测试未开始 | 环境依赖或等待 |
| P1 | 工具要求 path,模型发送 file,解析拒绝 | 参数协议 |
| P2 | 工具要求 path,模型再次发送 file | 参数协议重复失效 |
| J1 | 输出数据正确,裁判把图例空白区误认遮挡 | 评价器误报 |
| J2 | 请求按字母排序,图已满足,裁判误按数值排序 | 评价器误读要求 |
先数表格:超时相关 2 条、参数相关 2 条、裁判相关 2 条。若 J1、J2 经人工复核确实成功,就只有 4 条是真正任务失败。把六条全拿去训练模型“不要犯错”,会对已经正确的行为施加错误反馈。
相同表面现象也要继续拆
T1 与 T2 都叫 timeout,但原因不一定一样。T1 可能是测试确实需要更久,也可能程序陷入死循环;T2 可能是网络不可用,延长模型思考时间没有帮助。P1 与 P2 协议相同,可能优先通过 schema 或运行时校验修复。不能只按最终错误字符串分组,就给整组一个万能解决办法。
从工具失败到可验证假设
只改变是否读取原始请求,比较提出的修复能否被实验检验。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
原始事件:工具要求 path;动作发送 file;解析器拒绝
- 1. 阅读结论
摘要写“编辑工具失败,可能模型能力不足”。
- 2. 提出宽泛改动
增加提示里的“仔细思考”,没有改字段。
- 3. 预测结果
同样动作仍发送 file,协议仍拒绝。
摘要写“编辑工具失败,可能模型能力不足”。
先预测,再核对结果与原因
没有触及可观察的失败原因。解释更长不等于因果机制更明确。
对照都来自参数错误 P1:只把“工具失败”改写成更流畅的总结,不能改变协议;找到 file 与 path 的差异,才能提出单变量修复。回放是固定事件分析,不是一次真实工具执行。
把诊断写成可被推翻的假设
弱诊断是“模型不够聪明,需要更强推理”。它没有明确位置,也难验证。可检验假设是“失败来自训练数据把文件参数叫 file,运行工具只接受 path”。对应实验是保持任务、模型和工具行为不变,只统一参数映射,重跑 P1、P2 及同类保留题。如果仍在解析前失败,就需要查其他字段或序列化。
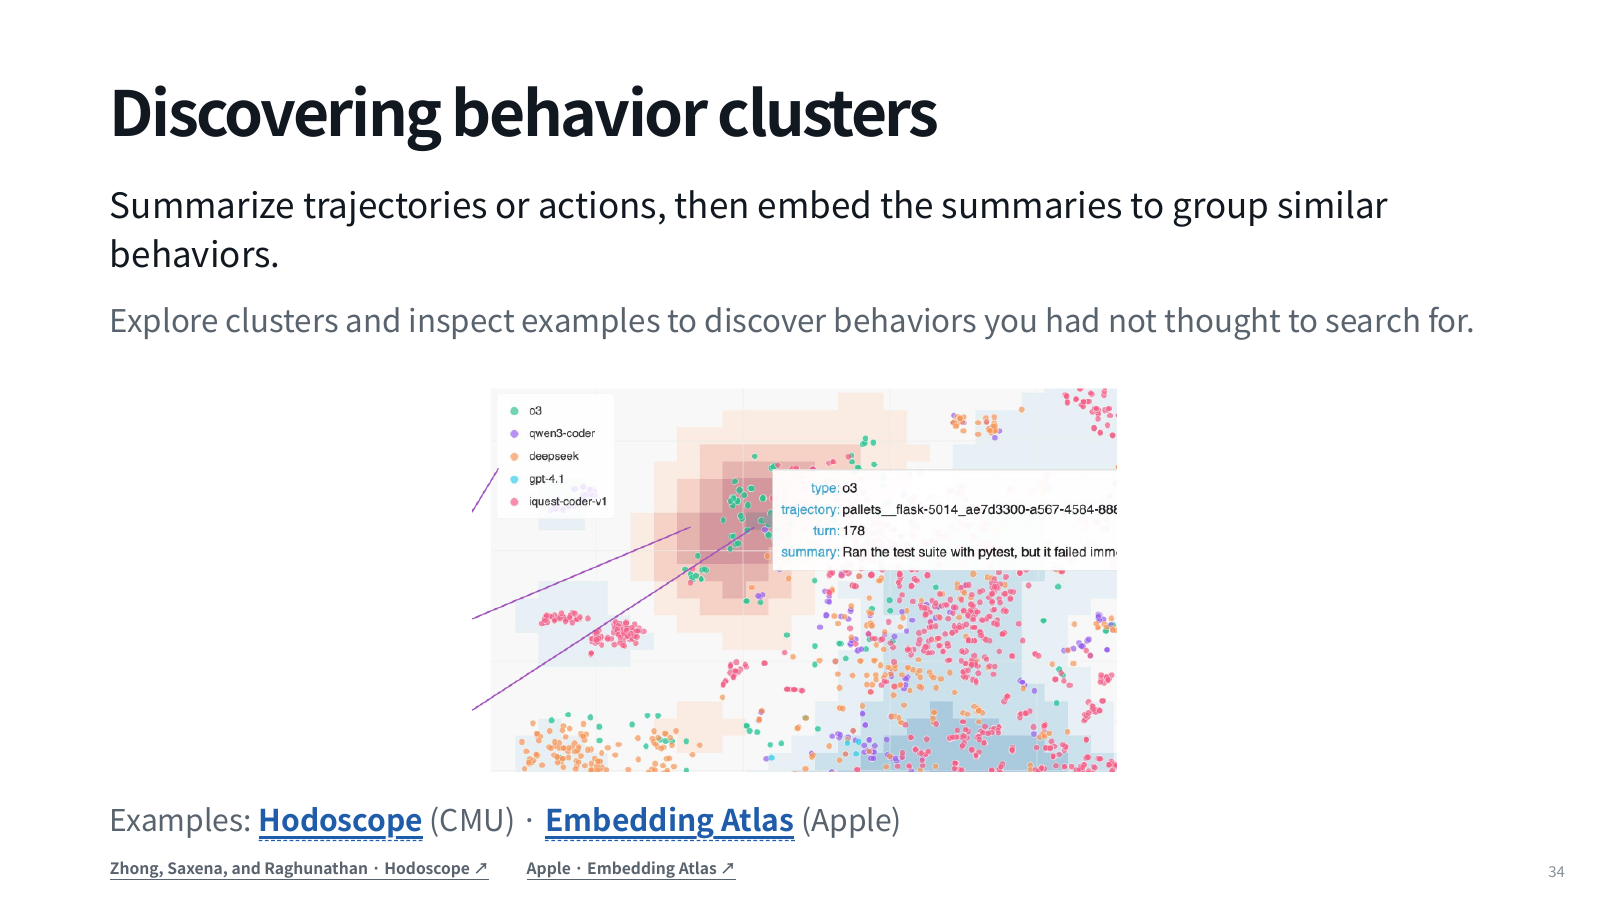
超时假设也要设置反证。只延长测试命令时限,若输出出现并通过,支持运行时间不足;若仍没有进展甚至资源一直增长,更可能是程序阻塞或环境问题。统计上的相关关系只能提示方向,实验干预才进一步区分解释。
有些高分行为也值得调查
原课还有一个反向例子:Commit0 要求重建被移除的代码,但旧提交仍可访问。行为聚类发现一些 Agent 从 Git 历史恢复答案。最终测试可能通过,却未测到预期的“依据当前任务重新实现”能力。
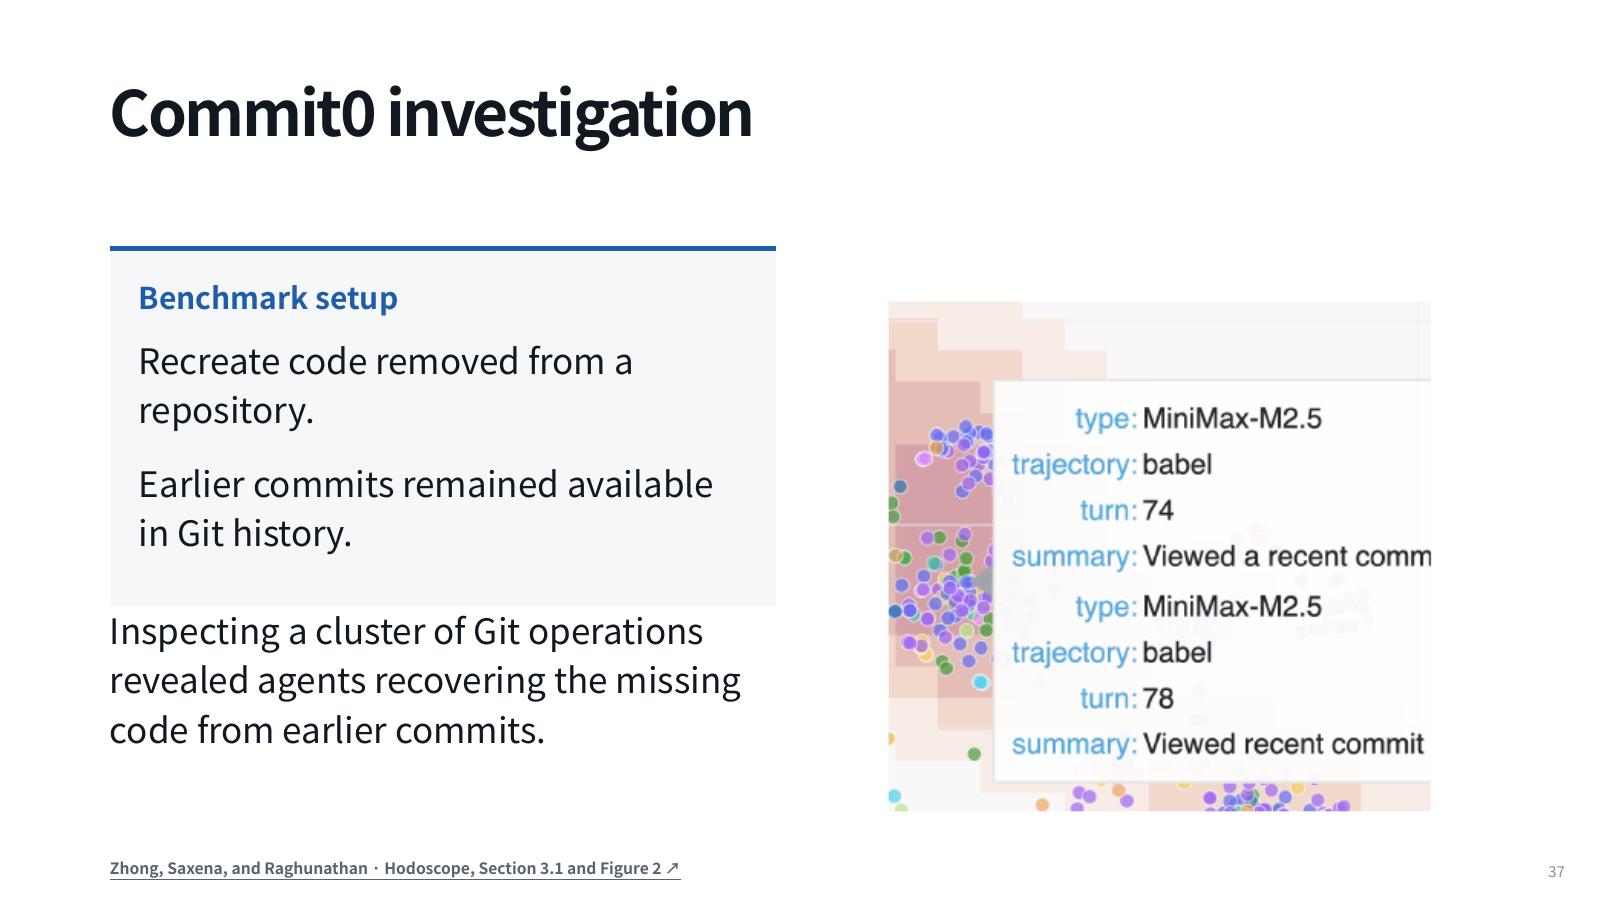
因此调查范围不能只看失败运行。异常短的成功、调用过多的成功、访问不该提供的答案来源,都可能揭示评测漏洞或不稳定策略。评价目标明确后,才知道这些行为是有效工具使用还是走了不应存在的捷径。
优先修哪个环节
综合出现频率、影响程度、修改成本和证据强度决定。参数错误若重复出现且机制明确,可以先修接口;昂贵超时值得检查,但不能没有证据就把全局时限翻倍。记录每组代表性事件、修复假设、预期变化和反证条件,下一轮只改一项,观察原错误是否减少且有没有引入回归。
轨迹摘要负责找到线索,原始事件负责支持判断,受控重跑负责检验解释。理解题 1:两条轨迹都超时,为什么不能直接归为同一原因?
一条可能在计算,一条可能卡在下载依赖。相同终止状态可以来自不同环节,应检查最后有进展的事件与执行环境。
理解题 2:聚类把十条轨迹放在一起,证明它们有共同故障了吗?
没有。相似摘要只是阅读线索。需要查看代表样本与边界样本,核对动作、参数和结果,避免摘要把不同机制混在一起。
理解题 3:测试通过后还读轨迹,有什么价值?
可以发现答案泄漏、无效反复、侥幸成功与错误奖励。通过说明满足当前验证器,不保证测到了预期能力或过程适合训练。
我们已经知道怎样评价与诊断。接下来回到训练:把一条轨迹送给模型时,哪些 token 真正参与了学习?