换了一个提示词,成功率涨了,真能说明它更好吗?
上一节已经把次数预算讲清楚。现在固定每题一次、同样工具和时间限制,只比较旧提示 A 与新提示 B。即使总分上升,也要问上升发生在哪些题、是否来自任务构成变化,以及一次抽样是否稳定。本课做配对比较和子集核查,先不把小表格当统计显著性证明。
把两版放在同一道题旁边
下面十题是教学用固定结果。前五题是简单任务,后五题需要多步处理;1 表示通过同一验证规则,0 表示未通过。
| 任务 | 类型 | A | B | 变化 |
|---|---|---|---|---|
| 1 | 简单 | 1 | 1 | 都成功 |
| 2 | 简单 | 1 | 1 | 都成功 |
| 3 | 简单 | 1 | 1 | 都成功 |
| 4 | 简单 | 1 | 1 | 都成功 |
| 5 | 简单 | 1 | 0 | 退步 |
| 6 | 多步 | 0 | 1 | 改善 |
| 7 | 多步 | 0 | 1 | 改善 |
| 8 | 多步 | 0 | 1 | 改善 |
| 9 | 多步 | 0 | 0 | 都失败 |
| 10 | 多步 | 0 | 0 | 都失败 |
A 成功 5/10,B 成功 7/10,差 20 个百分点。配对表进一步显示:3 题改善、1 题退步、6 题不变。没有这张表,我们看不见新提示在第 5 题引入了回归,也不知道是否同一类任务获得了收益。
只换子集,排名就能反过来
如果只看前五道简单任务,A 是 5/5,B 是 4/5,A 反而更好。看后五道多步任务,A 是 0/5,B 是 3/5。两版结果没有改变,改变的是我们在回答“哪种任务上的表现”。
这不是矛盾,也不该故意挑一个子集宣传胜利。真实产品若主要处理简单任务,总体测试集合里简单与多步各一半的平均分就未必代表产品使用分布。应提前定义目标任务集合和权重,保留分组结果,避免看到成绩后才挑分法。
同样结果,为什么排名反过来了
只切换任务集合,不改变任何一次运行的成功标签。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
固定结果:A 简单5/5、多步0/5;B 简单4/5、多步3/5
- 1. 确定集合
纳入 5 个简单题和 5 个多步题。
- 2. 合并计数
A=(5+0)/10=50%;B=(4+3)/10=70%。
- 3. 查看配对
B 改善 3 题、退步 1 题,其余不变。
纳入 5 个简单题和 5 个多步题。
先预测,再核对结果与原因
这十题上 B 领先 20 个百分点。平均结果对应当前任务组成。
先在十题集合看排名,再切到只看简单题。固定同一张逐题结果表,只改变集合,观察分母、成功数与结论怎样一起变。所有数值直接来自上表。
官方案例怎样追问平均分下降
原课讨论一次 Terminal-Bench 回归:在其报告的运行设置下,新旧模型总体成功率不同;进一步查看发现超时比例也不同。它没有停在一个总数,而是提出“新模型是否更常在交付前耗尽时间”的假设。
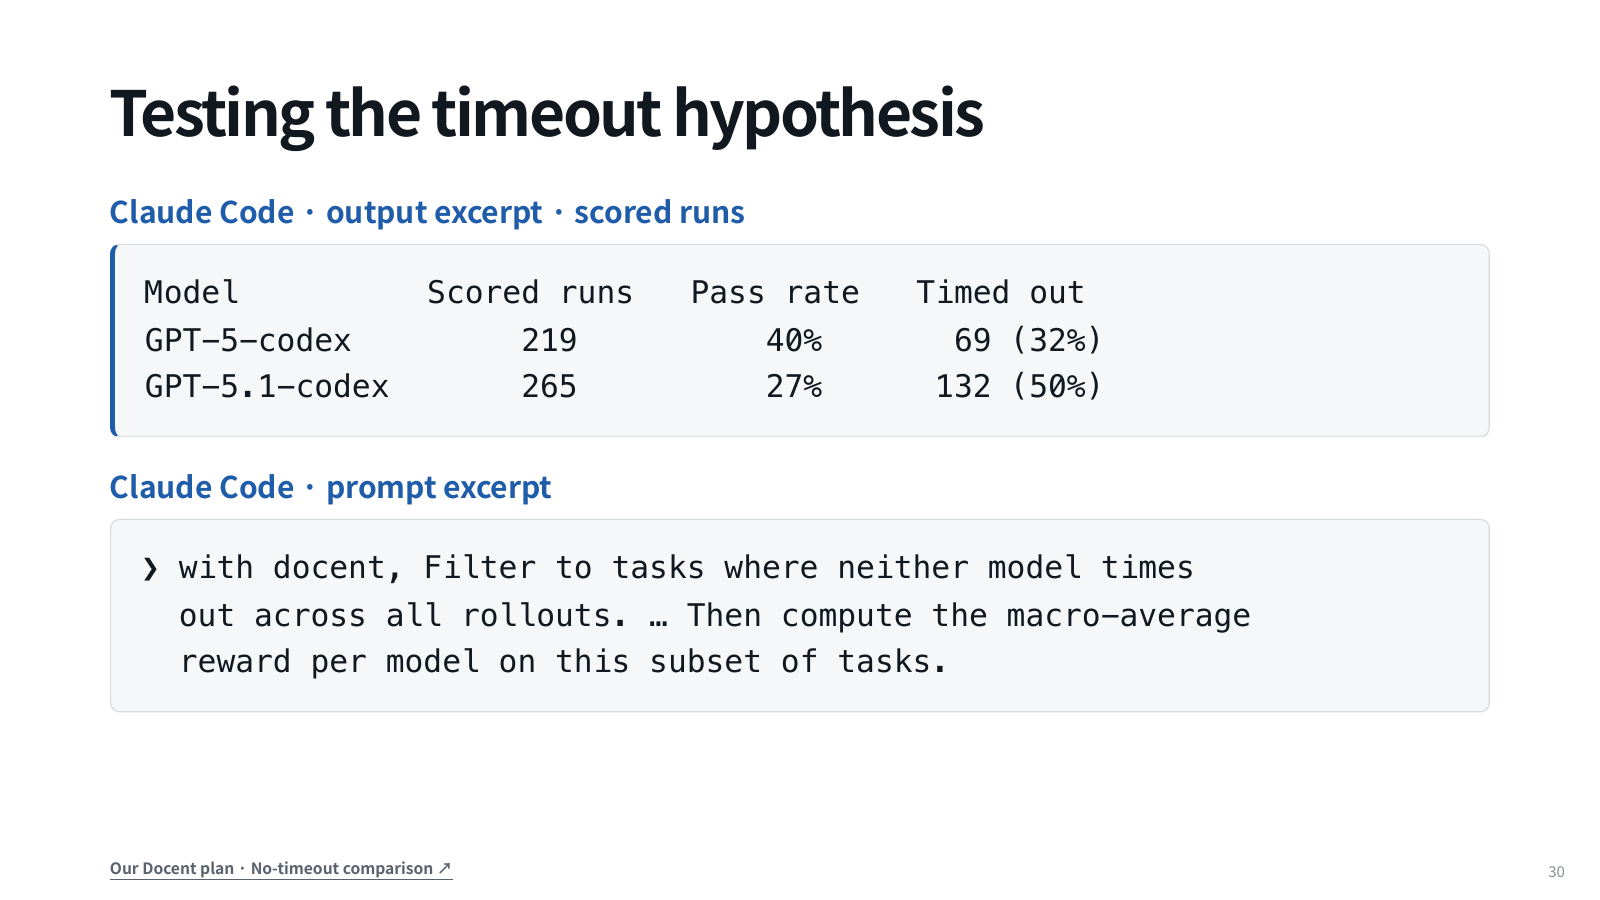
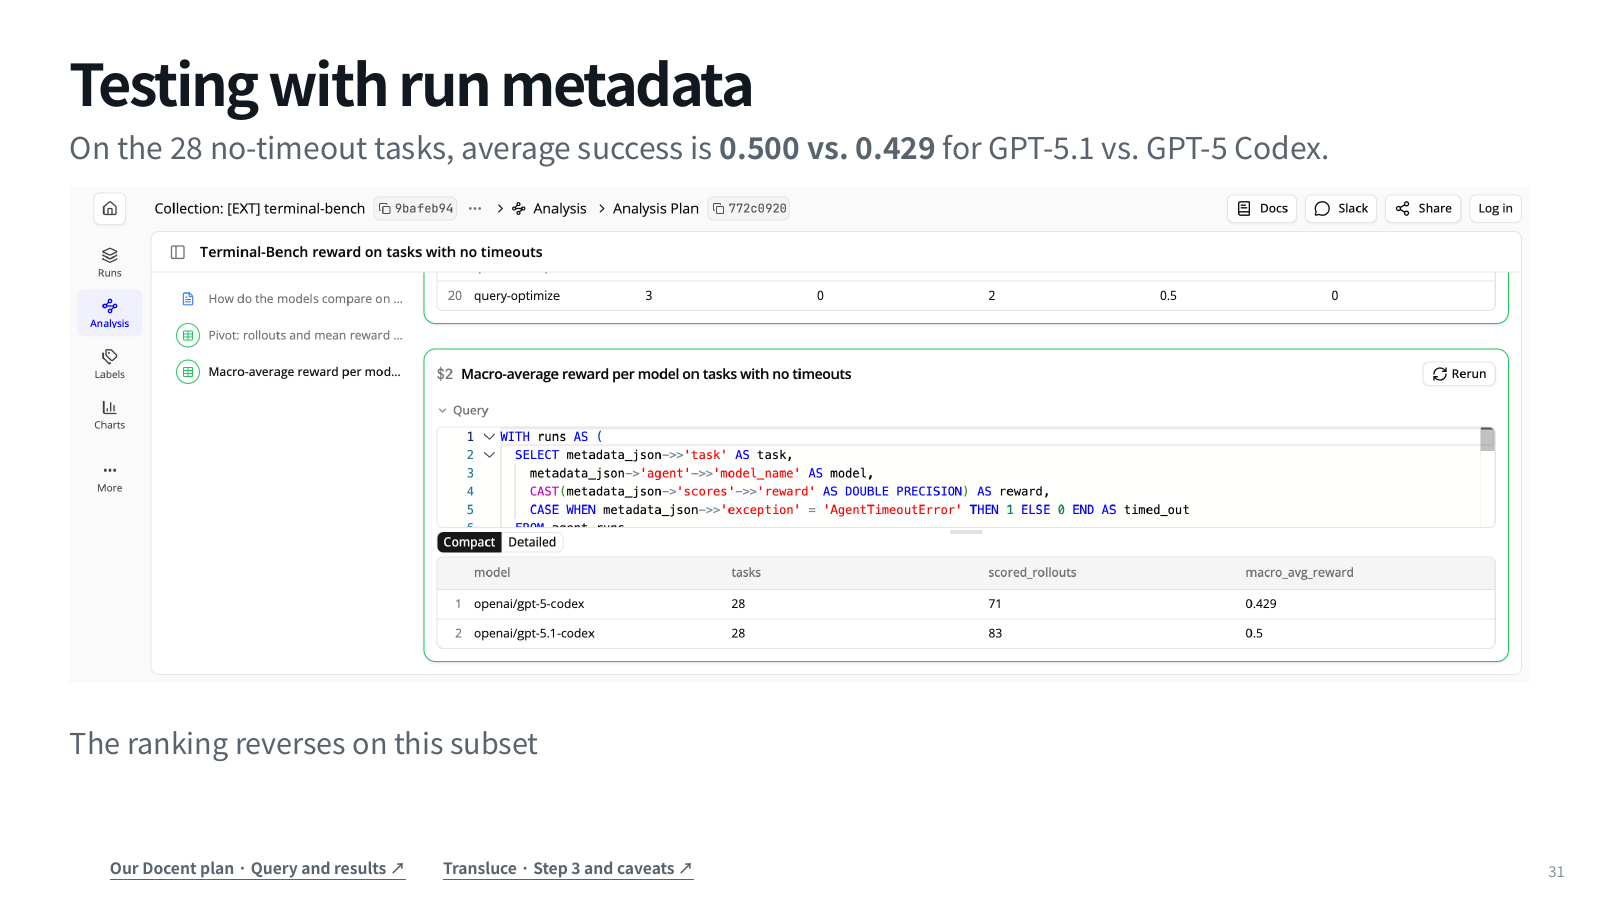
为什么不能证明?因为容易不超时的任务可能本来就不同。筛掉超时任务,同时改变了任务组成。真正要检验“更长时间能否解决回归”,应在同一任务集上只改变时间限制,保持模型、提示、工具、评分不变,再观察交付与成本。子集分析用来产生假设,受控干预用来检验假设。
提示词只是运行条件中的一个变量
如果改提示同时换模型、工具版本或上下文窗口,成功率改变不能只归因于提示。环境初始状态、任务集合、评分器、重试策略也要固定。第 30 节讲的可重置环境在这里兑现:两版必须从可比较的起点开始。
并不是所有不确定性都能消掉。模型采样、网络延迟与工具偶发故障可能造成同一题多次结果不同。报告运行次数、随机设置与失败分布,必要时做重复配对运行;但不能只重跑新版本失败的题直到成功,再与旧版第一次结果比较。基础设施错误若要重跑,需要对两版一致的规则。
怎样决定是否采用 B
先问 B 改善的多步任务是否是目标用户的重要需求,再看第 5 题退步有多严重,以及成本是否增加。若目标是提高整体通过率,当前表格提供 B 在这十题上领先的观察;若第 5 题是不可接受的核心场景,就应修复该回归后再决定。一个平均数不能替产品定义所有取舍。
验收记录至少包括:版本标识、固定任务清单、每题结果、预算、环境与裁判配置,以及改进和退步案例的证据。结论应限定为“在这套条件下观察到提升”,不能把十题结果推成所有任务都提升。样本量小,20 个百分点的观察差异本身也不保证统计稳定。
平均分回答“这批题总体怎样”,配对轨迹回答“哪些题为何变了”。 可以先用表格找到值得读的几条轨迹;下一节再学习如何从长轨迹中定位值得修的环节。
理解题 1:B 从 50% 到 70%,是否意味着每道题都变好?
不是。表里有三题改善、一题退步,其余不变。平均提升掩盖了局部回归,必须保留逐题配对结果。
理解题 2:只看无超时子集排名反转,能证明加时一定有效吗?
不能。该子集的任务组成也变了。它提供时间瓶颈的线索,需要在同一任务上只改变时限再检验。
理解题 3:多跑新提示十次、旧提示只跑一次,能直接比最好成绩吗?
不公平。尝试预算与选择机会不同。应统一协议,或明确报告各自预算与不同指标,不把差异全归因于提示。