一次没成功,多试几次成功,应该怎样报告成绩?
上一节讨论的是评价器能否正确识别错误。现在假设每次结果已经可靠判定,要衡量的是做任务的 Agent。单次成功率、至少一次成功比例和评价器准确率属于不同对象,不能互换。本课手算多次尝试的统计与预算,先不讨论自适应搜索的最优策略。
先看完整结果,别只挑最好的一次
下面是四个教学任务各五次固定尝试,1 为成功,0 为失败。这些是演算用的构造结果,不是模型跑分。
| 任务 | 第 1 次 | 第 2 次 | 第 3 次 | 第 4 次 | 第 5 次 |
|---|---|---|---|---|---|
| A | 1 | 1 | 0 | 0 | 0 |
| B | 0 | 1 | 0 | 1 | 0 |
| C | 0 | 0 | 0 | 0 | 0 |
| D | 0 | 0 | 0 | 0 | 1 |
固定只取第一列,成功 1 个任务,占 25%。把全部 20 次运行放一起,成功 5 次,运行级成功比例也是 25%;这次相等只是表格恰好如此。给每个任务五次机会并允许识别成功候选,A、B、D 都至少成功一次,任务覆盖变成 3÷4=75%。
这不表示 Agent 单次能力从 25% 变成 75%。我们改变了问题:从一次运行能否完成,变成五个候选里有没有一个能完成。C 五次全失败,也提醒我们重复不一定覆盖新的困难。
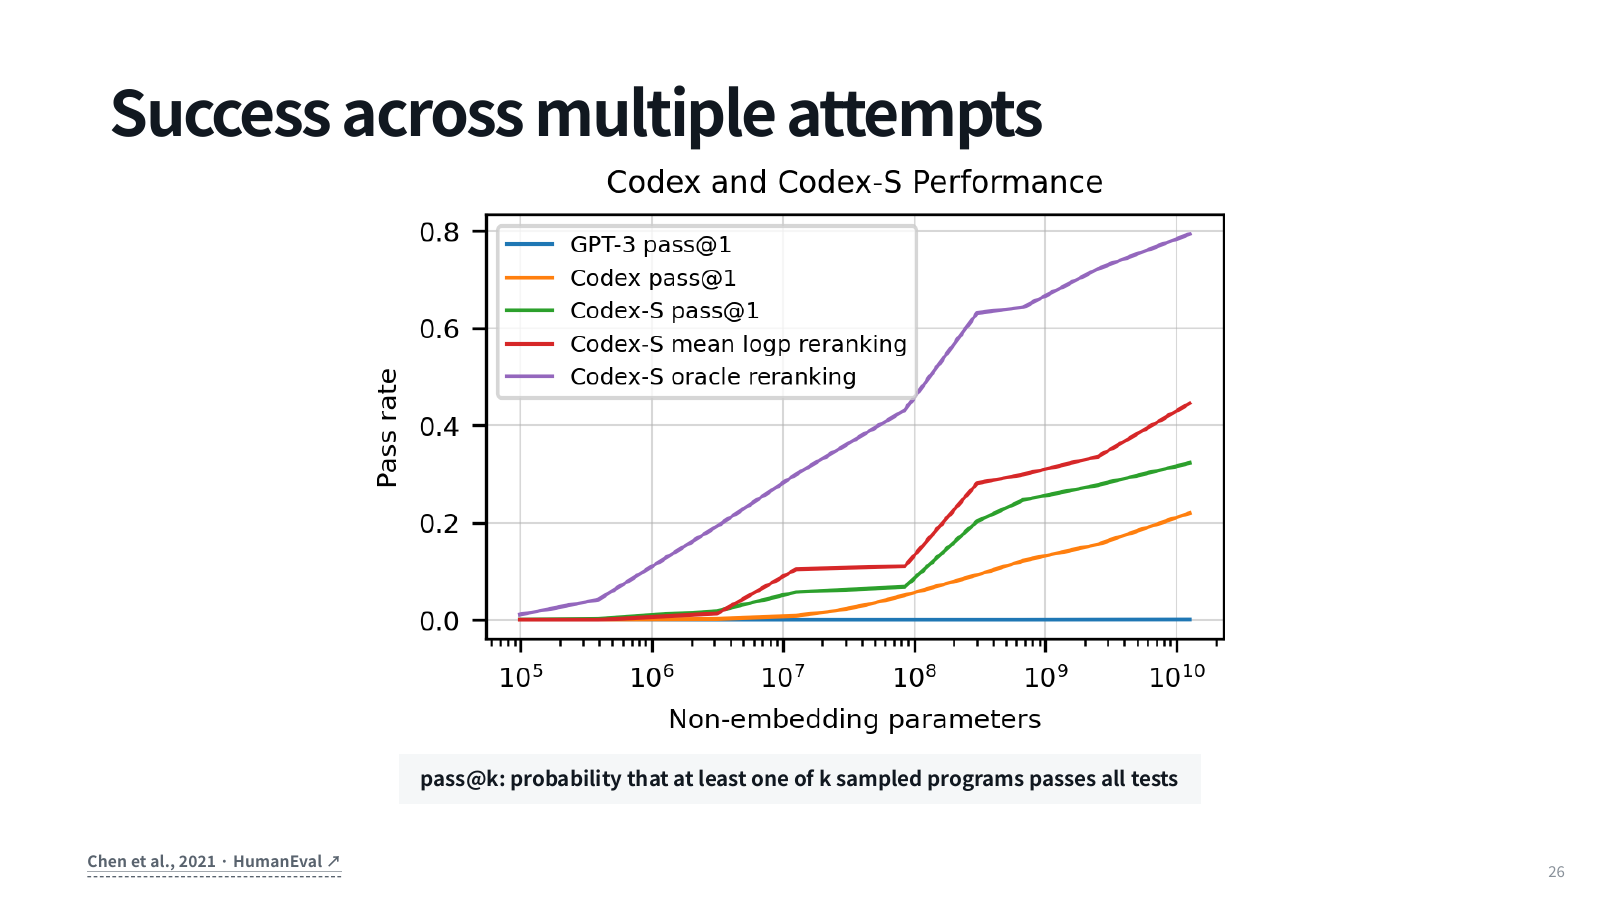
从 n 个已测候选估计 pass@k
常用估计式是 1 − C(n−c,k) / C(n,k)。n 是已生成并检查的候选数,c 是其中成功数,k 是每次允许的候选数;C 表示不考虑顺序地选择组合。分母数出全部 k 元组合,分子数出只从失败候选中选的组合,两者相除是“全失败”的比例,最后用 1 减掉。
以 n=10、c=2、k=3 为例,全部组合是 C(10,3)=120,全失败组合是 C(8,3)=56。至少一次成功的估计为 1−56/120=64/120≈53.33%。这是从同一题已测候选池中无放回选三份的组合统计;在常见采样假设下用于估计 pass@3,不是说已经顺序运行的每三个候选都会成功。
从 n 次采样估计 pass@k
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- 有效设置:n=10,c=2,k=3(c、k 不超过 n)
- 全部抽中失败的比例 = C(n−c,k) / C(n,k) = 0.4667
- 至少一次成功估计 = 1 − 0.4667 = 53.3333%
标准采样估计量假设采样和判据一致;不是用户看到 k 个答案就必然获得可用答案。
先看默认值 10、2、3,再只把 k 改成 1,结果应为 20%;把 k 改成 10,因池里有两个成功候选,结果为 100%。最后把 c 改为 0,任何合法 k 都不能创造成功。若输入的 c 或 k 大于 n,组件会将它们截到 n,并在“有效设置”中显示实际计算值。
为什么不是简单算 1−(1−p) 的 k 次方
如果每次尝试独立、同分布,单次真实成功概率为 p,那么全部失败概率为 (1−p)^k,至少一次成功就是它的补集。代入 p=0.2、k=3 得到 1−0.8³=48.8%。它与上面 53.33% 不同,是因为这里使用一个假定的单次概率,描述独立重复抽样;上面依据有限候选池做无放回组合估计。
真实 Agent 重试还可能读取上一轮失败、改变提示词或继续同一个环境,尝试不再是独立同分布。因此必须说明实验协议。固定策略独立采样的 pass@k、读反馈后连做 k 轮的修复成功率,以及人工挑最好结果,不能混成同一个数字。
把成绩与预算放在同一张账里
只改变每题允许次数,分别观察覆盖与总成本。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
A首轮成功,其余 B、C、D 首轮失败;每次成本 2
- 1. 固定预算
四个任务各运行一次,共 4 次。
- 2. 计算覆盖
只有 A 成功,1/4=25%。
- 3. 计算成本
4×2=8 个成本单位。
四个任务各运行一次,共 4 次。
先预测,再核对结果与原因
一次预算:覆盖 25%,成本 8。分母是四个任务,预算是每题一次。
回放保持四个任务不变,只改变每题预算。五次全部运行需要 20 次尝试;若每次恰好 2 个成本单位,总成本是 40,而一次预算总成本是 8。这是明确假设下的乘法,不代表真实 token 或美元价格。
有成功候选,为什么用户仍可能拿到失败答案
评测可以用隐藏测试识别哪份代码正确,部署时未必有这样的选择器。若模型从五个候选中挑中错误的那份,候选池 pass@5 高也没有转化成交付成功。报告应分开写候选池覆盖、选择策略与最终交付结果,必要时给出选择器漏选情况。
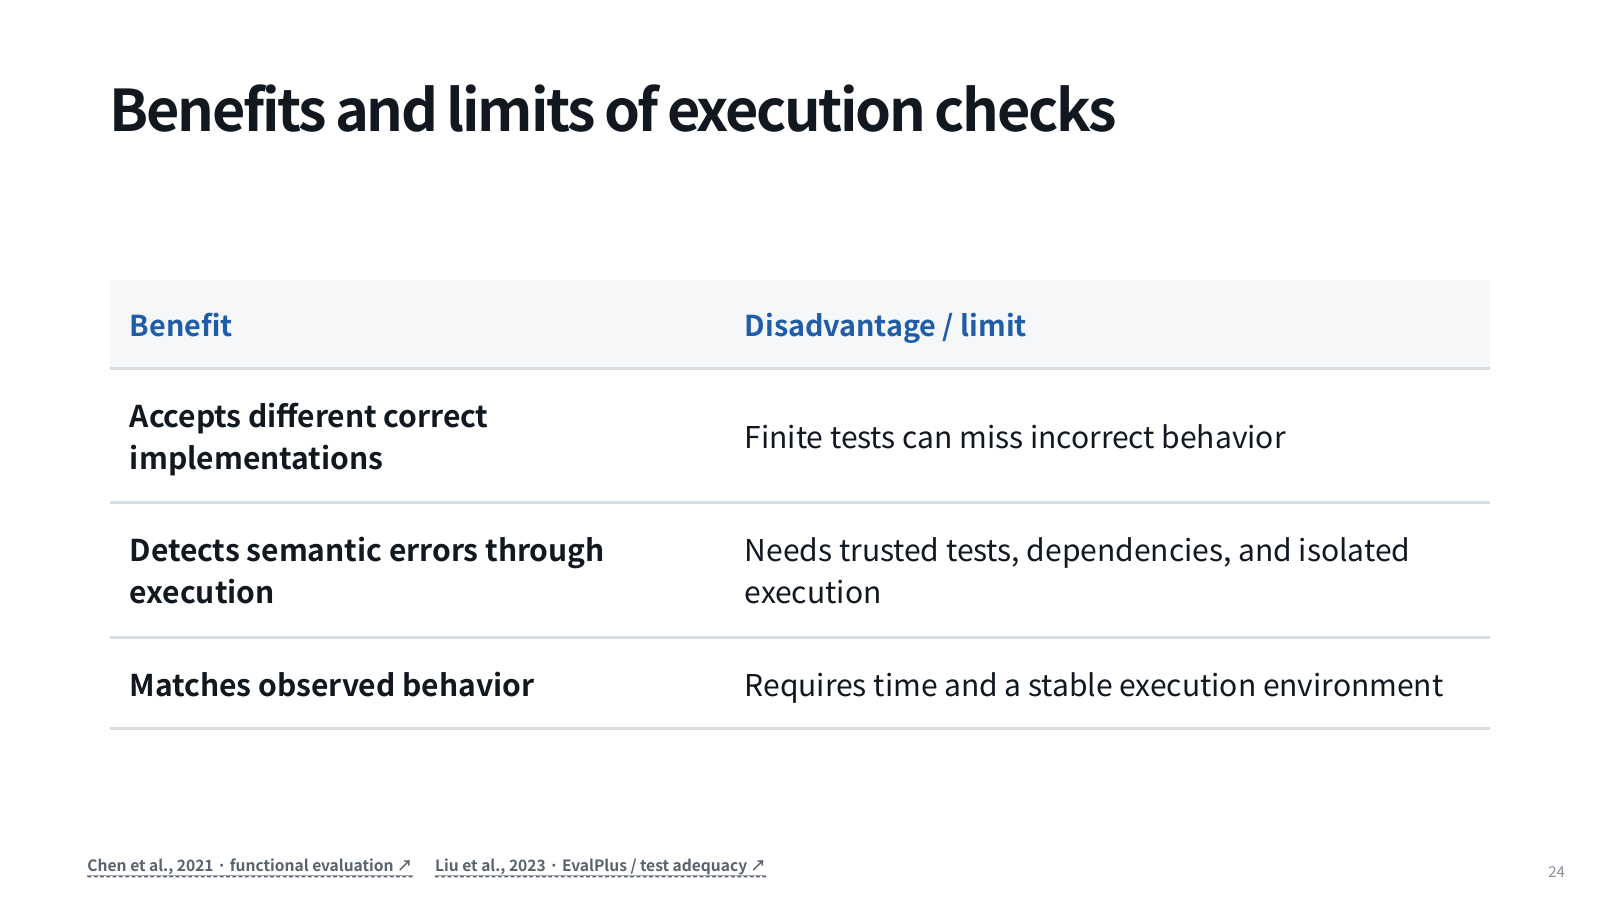
改变预算时还要计入工具调用、token、耗时和并发。并行五次可能缩短等待,却不会把总计算量变成一次;遇到成功就停会降低平均成本,但需要可靠的在线成功检测。若比较两版 Agent,先固定预算协议,再讨论哪个更合算。
多次尝试提高的是找到至少一个成功结果的机会,报告必须把机会数与选择成本一起写出来。理解题 1:四题五次,三题至少成功一次,可以写单次成功率 75% 吗?
不可以。75% 是该固定结果表中五次预算的任务覆盖。单次或运行级比例必须按相应分母另算。
理解题 2:n=10、c=0,把 k 从 1 加到 10 会发生什么?
估计仍为 0。当前候选池没有任何成功项,选再多也没有。提高尝试数可能未来产生新成功,但那需要新实验。
理解题 3:pass@5 很高,为何还需要报告最终交付成功率?
因为系统未必知道五份中哪份正确。候选存在与正确选出不同,部署成绩还受选择器与验证条件影响。
下一节保持预算不变,再问另一个常见误判:换了提示词后平均分提高,真的能说明提示词更好了吗?