本节要解决的事:前缀缓存复用的是相同输入对应的计算状态。它不是“出现过的句子都打折”,也不是模型多长出了一段永久记忆。
一个时间戳,为什么会影响后面两千格
构造两次请求:固定规则 100 个 token,工具说明 2,000 个 token,动态时间 10 个 token,新问题 20 个 token。第一种布局把时间放最前面;第二种把时间放在固定规则和工具说明之后。两次请求长度都是 2,130,但可共享的连续开头不同。
为便于手算,我们假定动态块第一个 token 就不同,其他块完全一致,不考虑缓存最小块长和过期。时间在最前面时,共有前缀为 0;时间在固定内容之后时,共有前缀为 2,100。现实时间字符串可能共享若干起始 token,实际服务又有分块规则,所以这个数字是教学设定,不是所有平台的测量结论。
为什么“后面的内容一样”还不够
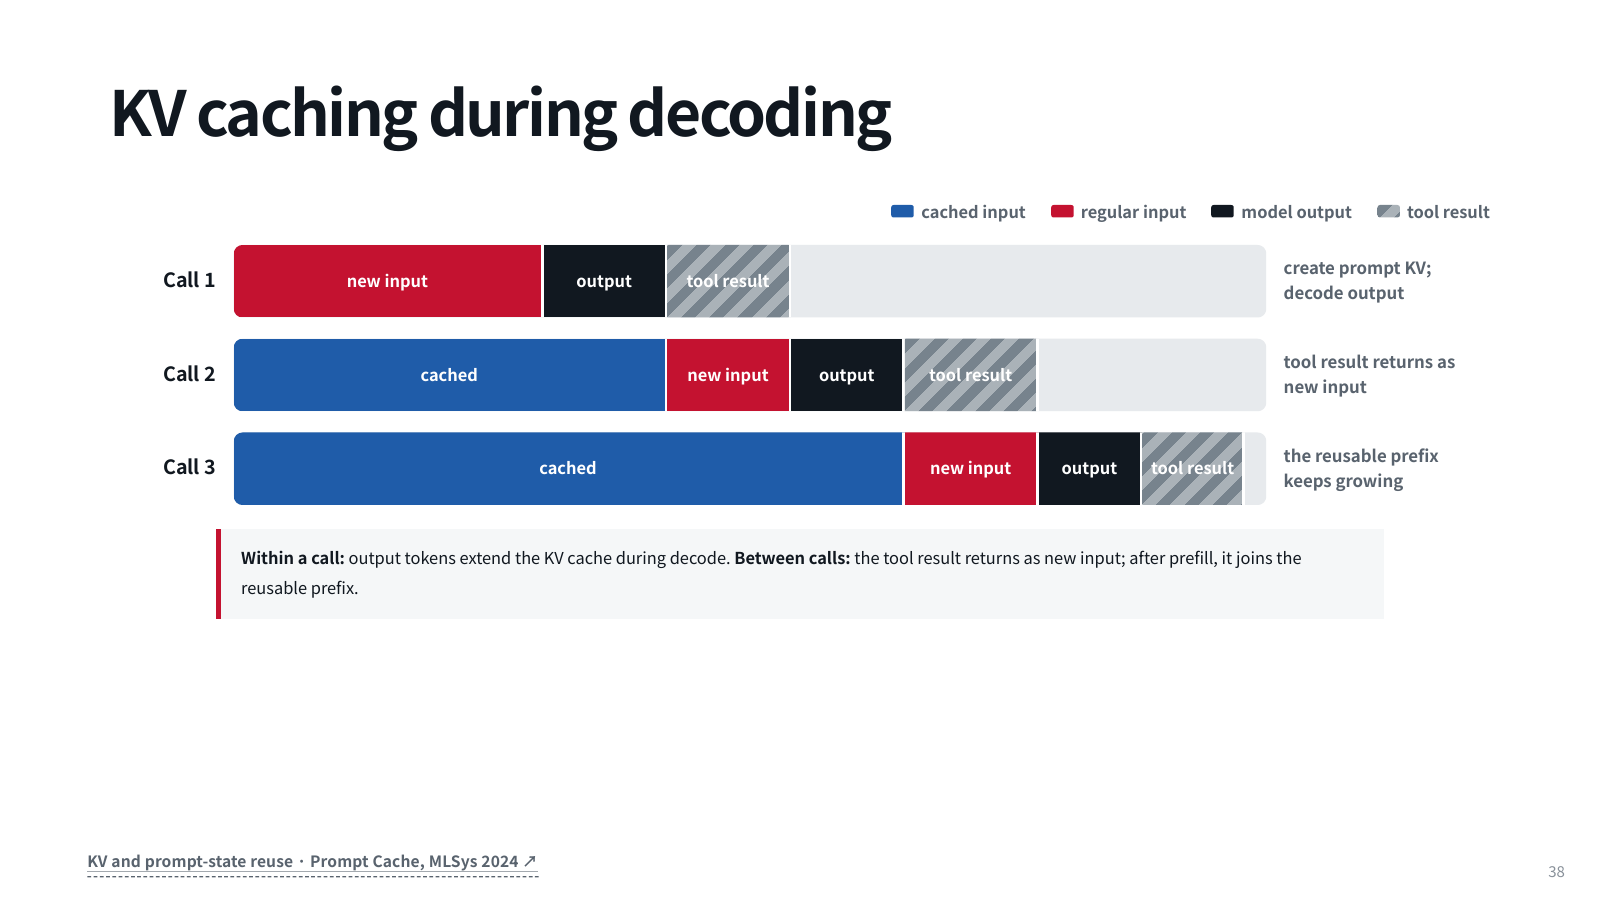
在因果模型里,某位置的计算与它前面的序列相关。若开头改变,后面相同文字对应的状态也未必相同。因此常见的前缀复用需要从开头连续匹配,而不是像文件去重那样把任意相同段落随意拼接成缓存。具体系统可能采用更复杂方案,但不能默认具备这种能力。
所谓相同也应按实际序列化后的 token 理解。工具顺序、空白、角色分隔、模板版本都有可能影响序列。界面上看起来一样,不保证服务器看到完全相同的前缀。排查时要保存经过必要脱敏的请求结构与版本,而不是只对比截图。
只移动动态块,比较共同前缀
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
时间 10+规则 100+工具 2,000+问题 20;时间首 token 改变。
- 1. 比较开头
两次请求第一个 token 就不同。
- 2. 找连续匹配
在本例假设下,公共前缀长度为 0。
- 3. 计算长度
整段逻辑输入仍为 2,130。
两次请求第一个 token 就不同。
先预测,再核对结果与原因
没有可复用的共同前缀后面文字一样,不能直接等同于状态也一样。
机会、命中、收费,是三个不同问题
有相同前缀,说明存在复用机会;缓存仍驻留并满足实现条件,才可能实际命中;命中的输入如何计费,还取决于提供方的价格规则。不要从“物理上少算了”直接推出“账单一定打某个折扣”。缓存也可能要付写入、存储或读取成本,具体情况必须核对所用服务。
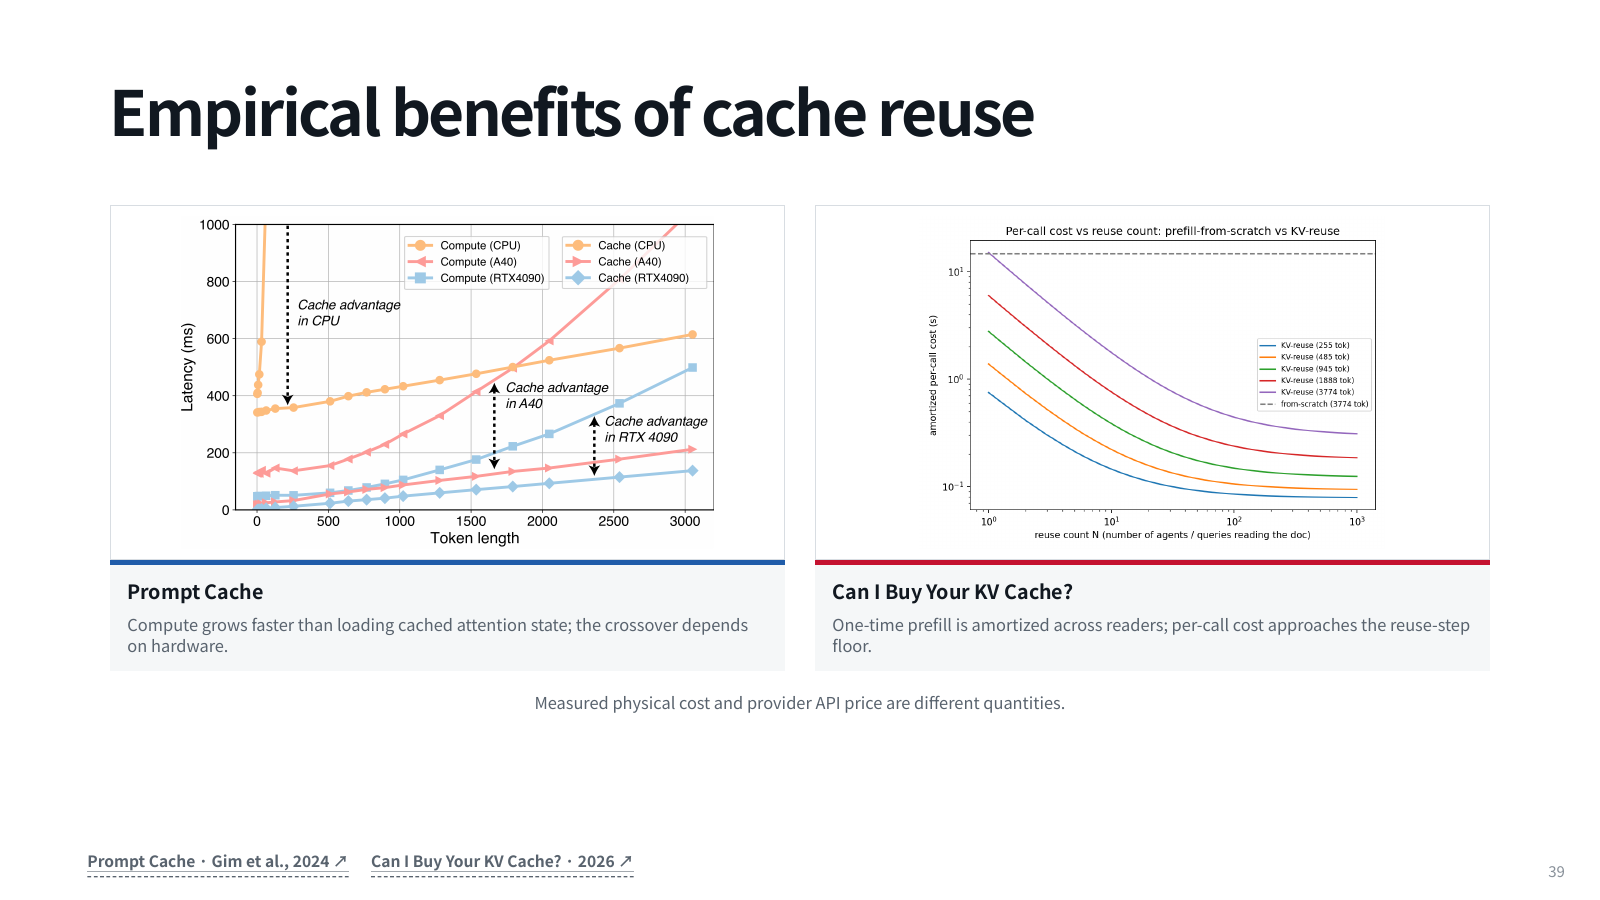
比较短提示和很长的稳定提示:后者通常更有值得复用的内容,前者即使命中,绝对节省也可能很小。再比较紧接着重复请求和间隔很久重试:缓存可能被回收,前缀一致也不保证仍在。我们应观察实际缓存统计和延迟,并保留没有命中时仍然正确的执行路径。
缓存不应改变任务语义
为了提高命中率,把时间戳后移只有在规则含义和所需新鲜度保持正确时才成立。不能为了缓存删除必须更新的权限、库存或截止日期。真实库存每次变化时,仍需取回并使用新结果;拿旧工具结果凑出稳定前缀,可能省计算却做错任务。
同样,前缀缓存不是长期记忆库。新会话如果没有把旧事实放入逻辑输入,不能指望缓存偷偷补上;重启或缓存失效,也不应让任务忘掉业务状态。长期事实需要明确存储与检索,缓存只是服务层如何计算同一请求的优化。
理解检查
问题一:规则 100、工具 2,000 在前,是否保证按 2,100 个缓存 token 收费? 不保证。这只是共同前缀长度;分块、最小长度、缓存驻留与定价方式可能不同。需要看实际服务返回的缓存统计。
问题二:只改第一个时间 token,后面工具文字没变,为什么不能直接复用全部后文? 因为后文的状态是在给定前缀下算出的,开头变动会影响其条件。本节讨论常见连续前缀缓存,不把任意片段复用能力当成默认。
问题三:让旧库存留在前缀里可以提高命中,应不应该这样做? 只有当它明确标为历史、且决策使用新的有效库存时才可能合理。若把旧库存冒充当前值,正确性已经丢失,缓存率再高也没有意义。
下一问
缓存减少重复计算,却没有缩短逻辑输入。历史最终仍会太长;下一节学习怎样压成可继续工作的状态,而不是一段听起来顺滑却丢失证据的故事。