本节要解决的事:所谓“高效长上下文”,并不是一个万能开关。先数十二个位置之间能看见多少连接,再讨论不同层的优化。
十二格历史,最后一格要找第二格
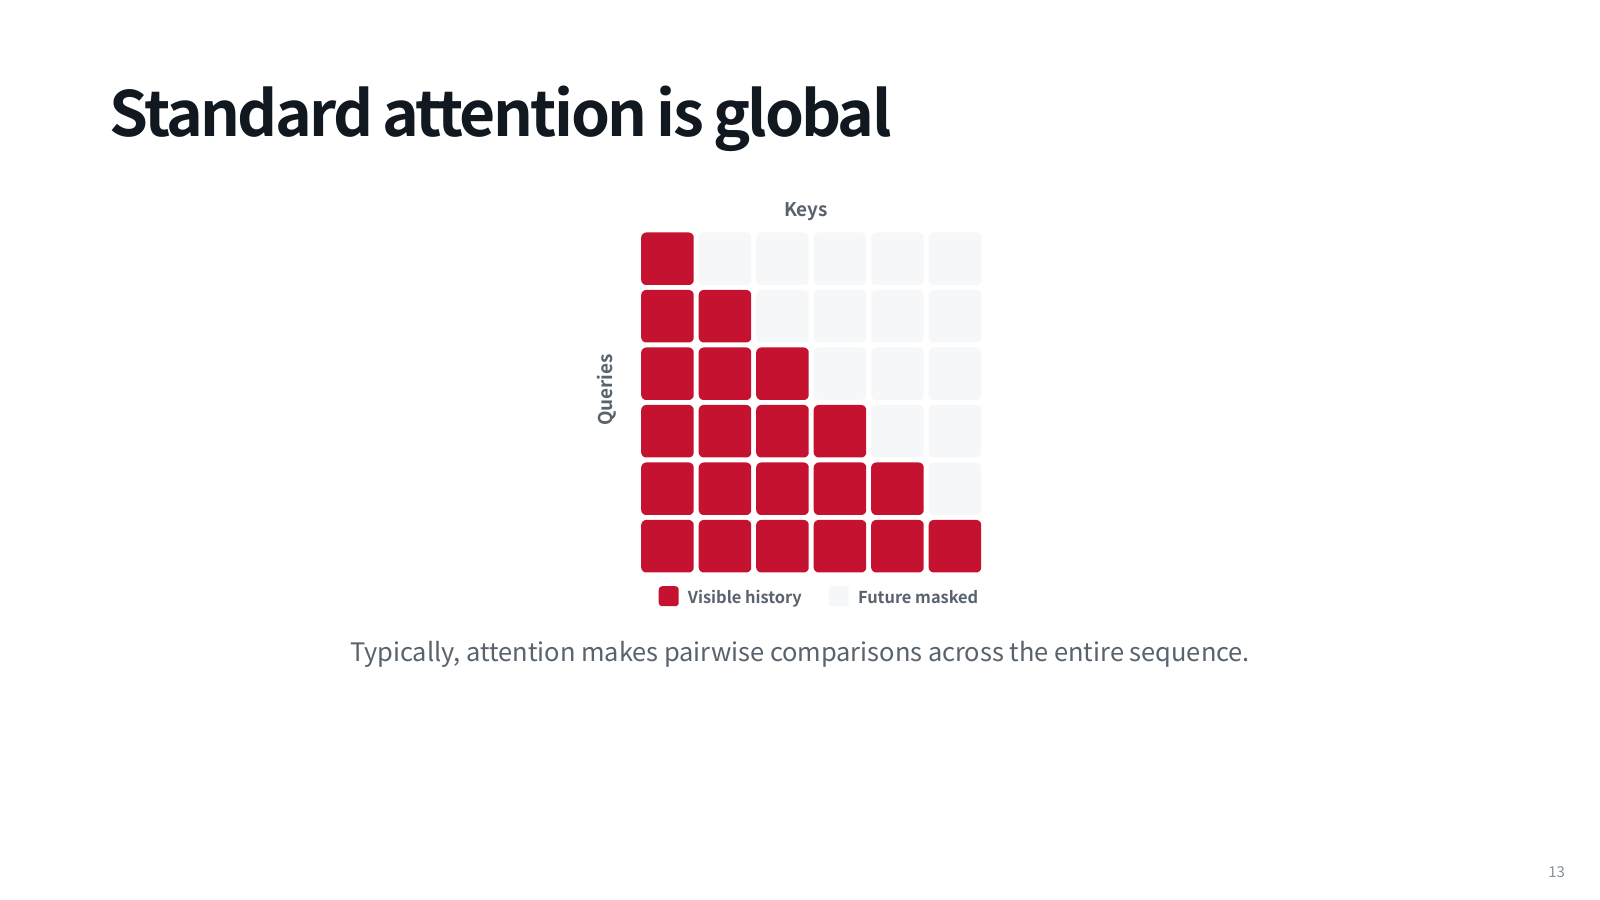
想象输入有十二个 token,编号 1 到 12。第 2 格编码一条重要信息,第 12 格正在回答需要它的问题。标准因果注意力让第 i 格直接访问从 1 到 i 的位置,未来位置被遮住。因此第 12 格能看见第 2 格。整段可见的位置对数是 1+2+…+12=78;这里算的是单层、单个头的可见连接示意,不是模型总浮点运算量。
朴素地让每个位置都与所有历史位置比较,随着序列变长会产生大量连接。长度翻倍时,配对数量的主导项接近四倍。这解释了为什么长文本不能只靠扩大输入上限,还需要考虑注意力计算、KV 内存与训练后的有效利用。
窗口为四,究竟少看了哪些
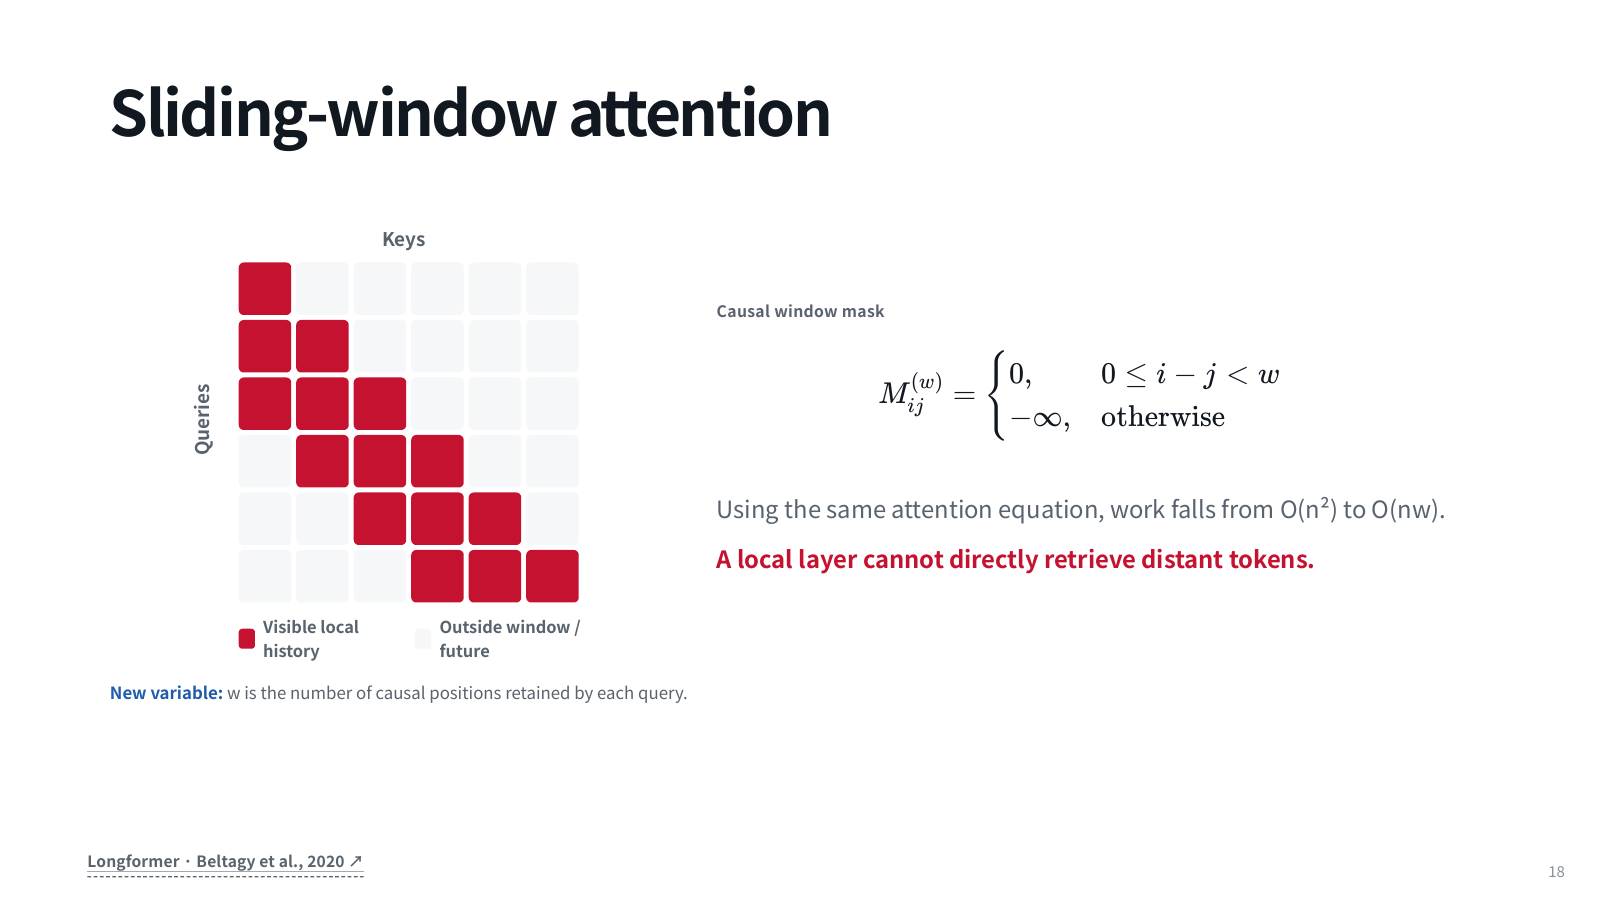
把规则改为每个位置只直接访问包含自身在内最近四格。前几行分别能看 1、2、3 格;第 4 到第 12 行各看 4 格,所以共有 1+2+3+9×4=42 个位置对。与 78 相比少 36 个,约少 46.2%。这个数只是本例的连接比例,不应直接当作真实推理速度提升。
第 12 格此时只能直接看 9、10、11、12,看不到第 2 格。请注意“单层直接”这几个字:多层网络可能通过中间位置传递更远的信息,混合架构也可能插入全局层。因此不能把局部注意力说成绝对不可能获得任何远处信息;准确说法是它取消了这条直接连接,远距信息能否保存和传递需要其他机制。
最后一格能直接读取第二格吗?
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
12 个位置;需要第 2 格事实;单层直接访问。
- 1. 逐行计数
第 i 行能看 i 个位置。
- 2. 计算总数
1 至 12 相加为 78。
- 3. 检查目标
第 12 行包含第 2 列。
第 i 行能看 i 个位置。
先预测,再核对结果与原因
直接连接存在容量开销较大,但这条远距离边没有被掩掉。
别把五种方法都叫“少看历史”
滑动窗口限定邻近位置;稀疏注意力选取一部分连接,有时加入特殊全局位置;混合结构让部分层或模块处理局部信息,另一些保留远距访问。它们改变“怎样连接”,并不必然删除应用层原始聊天记录。
线性注意力类方法常把历史累积为可更新的状态,通过不同于完整注意力矩阵的计算避免显式列出所有位置对。它与简单窗口截断不同,压缩状态也会带来表达和记忆上的取舍。不同变体不能仅凭同一个“线性”名字推断效果相同。
KV 压缩主要处理保存的键值状态,例如改变精度、选择保留内容或压缩表示。它着重缓解内存及带宽问题;压缩是否有损、损失影响什么,要按方案验证。位置编码扩展则处理更长位置范围的表示和外推,例如 RoPE 相关方法。让位置编号能延伸,不会自动教会模型在长材料里使用每条约束,通常还涉及长文本训练和评估。
连接存在也不代表模型必定使用该信息;注意力权重、各层表示和训练都参与结果。我们的格子图只说明可访问关系,不把它画成真实模型的思考过程。
因此,架构、训练、推理服务、应用摘要是不同层。开发者给普通全局模型删去八格历史,是输入管理;训练一个窗口注意力模型,是模型设计。两者都可能减少某些成本,但责任边界与恢复信息的方式不一样。
理解检查
问题一:十二格窗口四为什么不是 48 条连接? 最前面的三行没有足够过去位置,只能分别看 1、2、3。不能把不存在的历史也算进去,所以是 42。
问题二:局部层看不到第二格,是否证明整个多层模型永远用不到它? 不能。信息可能经中间表示传播,也可能由其他全局层读取;本图只证明单层直接边缺失。要验证整体能力还需具体架构和任务测试。
问题三:把 RoPE 支持范围扩大,就能证明长任务不漏约束吗? 不能。位置范围、训练分布、信息检索和决策应用是不同问题。可接受更长输入只是前提,仍需上节那类受控实验。
下一问
即便架构不变,旧前缀完全一致时也可能复用计算。下一节只移动一个时间戳,看看为何同样长的两次请求,缓存机会会截然不同。