本节要解决的事:上下文窗口像一个很大的桌面,东西放得下,并不代表每次做决定都能准确找到需要的那张纸。
一份 280 元报价,为什么会被另一个 360 元方案挤掉
用户要求采购,预算上限 300 元。方案 A 总价 280,方案 B 总价 360、到货更快。只考虑预算,A 可行而 B 不可行。现在把这条预算夹在许多物流记录、历史报价和聊天中。模型输出“推荐 B,速度更好”,并不一定是算错了 360 比 300 大;它也可能没有正确取回或使用那条约束。
朴素做法是把全部材料塞进去,觉得既然没有超过窗口上限,就不需要整理。窗口首先是输入容量约束;任务成功还要求定位事实、区分旧新版本、把多个事实结合、遵守目标。这几件事比“收到了这些 token”更强。一个百万 token 窗口的声明不能直接推出百万 token 上任意任务都可靠。
三种失败必须分开诊断
第一种是没找到:问“预算是多少”,它回答不知道或引用无关金额。第二种是找到但没用:能复述 300,却仍推荐 360。第三种是版本混淆:历史曾说 500,后来改成 300,它找到了一个真实出现过的数字,却用了已过期的约束。三种情况表面上都像长上下文失败,修复方法却不同。
没找到时可尝试检索或更清晰的任务状态;没用时需要在决策处显式检查预算;版本混淆时要记录来源、时间与有效版本。把预算不断重复十遍未必能解决后两种问题,还可能增加噪声。对于金额这种可以程序检查的硬条件,最终方案金额是否不超过预算,应由明确规则复核。
一个真正控制变量的小实验
制作三份内容相同的记录,分别把同一条“当前预算上限 300 元”放在开头、中间和结尾。先固定总长度、其他报价、问题和模型设置,只改变位置。每次要求同时给出预算证据与方案判定,记录取回正确率、应用正确率和版本判断。然后再开第二轮实验,只增加干扰记录而保留位置。
不要让开头版本刚好更短、中间版本刚好多了旧预算,再把差异归因于位置。重复运行或换多组同结构数据,才能看到稳定趋势。下面的互动只展示确定的验收规则,不假装我们已经跑出了三个位置的真实模型准确率。
拿到约束与遵守约束是两道检查
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
有效预算 300;A=280,B=360;用户优先满足预算。
- 1. 取回
从当前有效记录读取预算 300。
- 2. 比较
A 余量 20;B 超出 60。
- 3. 选择
先排除 B,再在合规方案中选择 A。
从当前有效记录读取预算 300。
先预测,再核对结果与原因
A 可行,B 不可行硬约束在偏好排序之前检查。
两种有用的改善,适用条件不同
如果任务是定位一条合同条款,先按关键词和语义找候选段落,再让模型阅读附近上下文,能减少无关材料。但检索可能漏掉否定句或其他章节的例外,因此应保留可回原文的指针,必要时扩大阅读范围。检索不是自动保证事实正确的过滤器。
如果任务必须跨许多章节综合,例如比较全部例外条款,只取一段会人为丢掉关系。此时可以分段提取带来源的事实,再汇总,并对缺失范围做检查。上下文更长仍有价值,只是要用任务对应的验证方法衡量,而不是仅比较窗口数字。
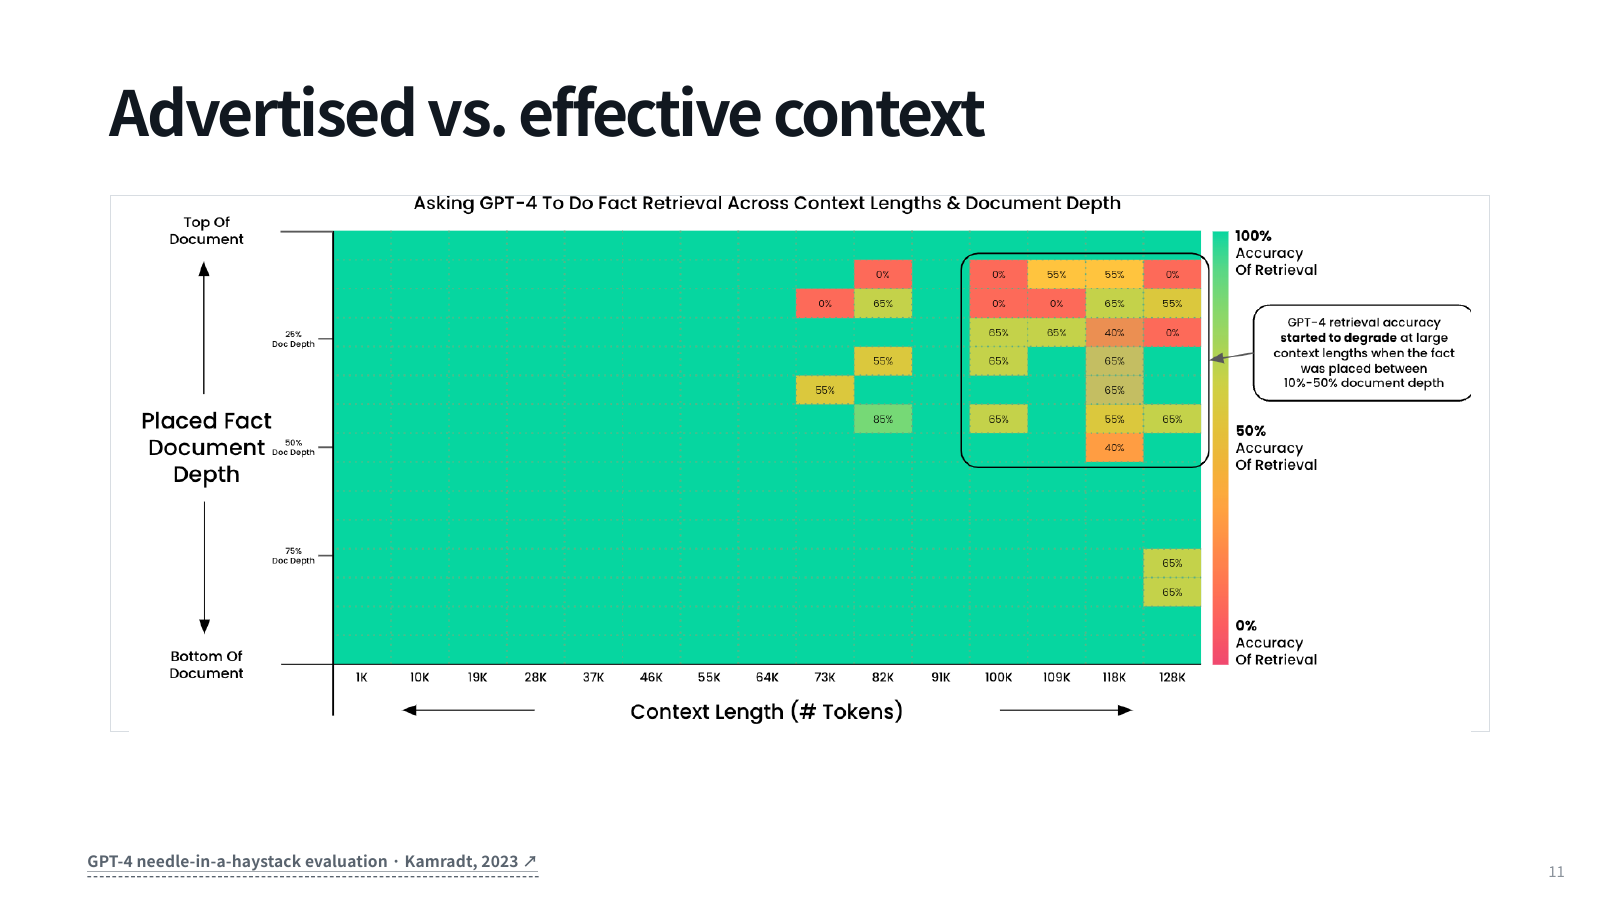
位置也不是唯一变量。文本相似度、干扰项、指代、多个版本和问题复杂度都会影响结果。课件中的“找针”实验测的是一种事实检索能力,不能直接等同于长篇规划、代码修复或整本书理解。读性能图时先问测试了什么,再问数字高低。
理解检查
问题一:模型准确回答“预算 300”,却选择 B,说明哪里需要检查? 至少说明简单取回已经成功,问题出在应用约束或决策链。应让最终方案通过预算规则,不能只增加检索次数。
问题二:开头成功一次、中间失败一次,能否证明它永远忽略中间? 不能。一次样本可能受生成随机性和其他差异影响。要控制变量、多任务多次重复,并保留具体失败证据。
问题三:先检索再回答一定优于直接读全文吗? 不一定。若检索遗漏决定性的例外,答案会更自信地出错。需要根据任务是局部定位还是全局综合设计材料选择与覆盖检查。
下一问
模型不能无限扩大计算。下一节把注意力画成只有十二个位置的连接:少保留一些连接,具体节省了什么,又可能断开哪条远距离关系?