本节要解决的事:同样只问一句“接下来呢”,为什么第十轮可能比第一轮慢?先数请求里到底放了什么,再分清计算与收费。
屏幕上只有一句,输入里却可能有一本记录
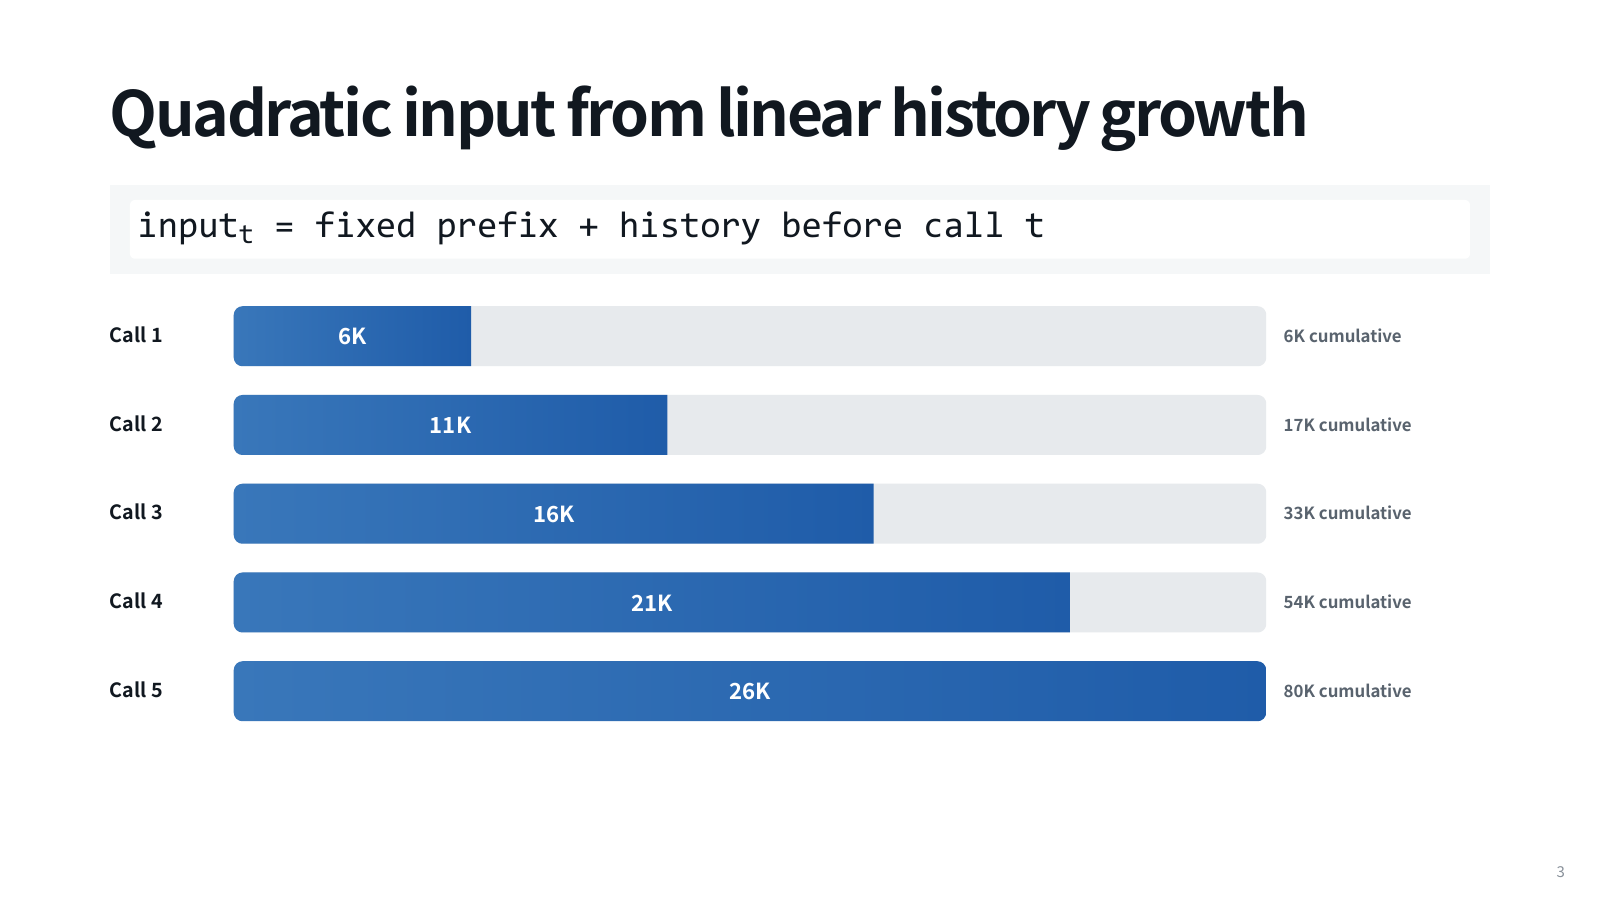
假设一个教学系统每轮发送 200 个 token 的固定前缀,每次交互再给历史新增 100 个 token。第一轮输入 200;第二轮是前缀 200 加历史 100,合计 300;第三轮 400;第四轮 500。四轮逻辑输入累计是 200+300+400+500=1,400。这里的 token 数由教学样本直接给定,不是把中文字符数当成分词结果。
朴素直觉是“四轮新增了 300 个历史 token,所以只读了 500”。这个 500 是第四轮的长度,不是四次请求的总量。每次请求如果都带完整历史,旧内容会再次出现在输入中。用户只看到最后一句,并不代表服务只收到最后一句;反过来,有些系统会截断或摘要,不能假定所有应用都完整回传。
两个计算阶段,不要混在一块想
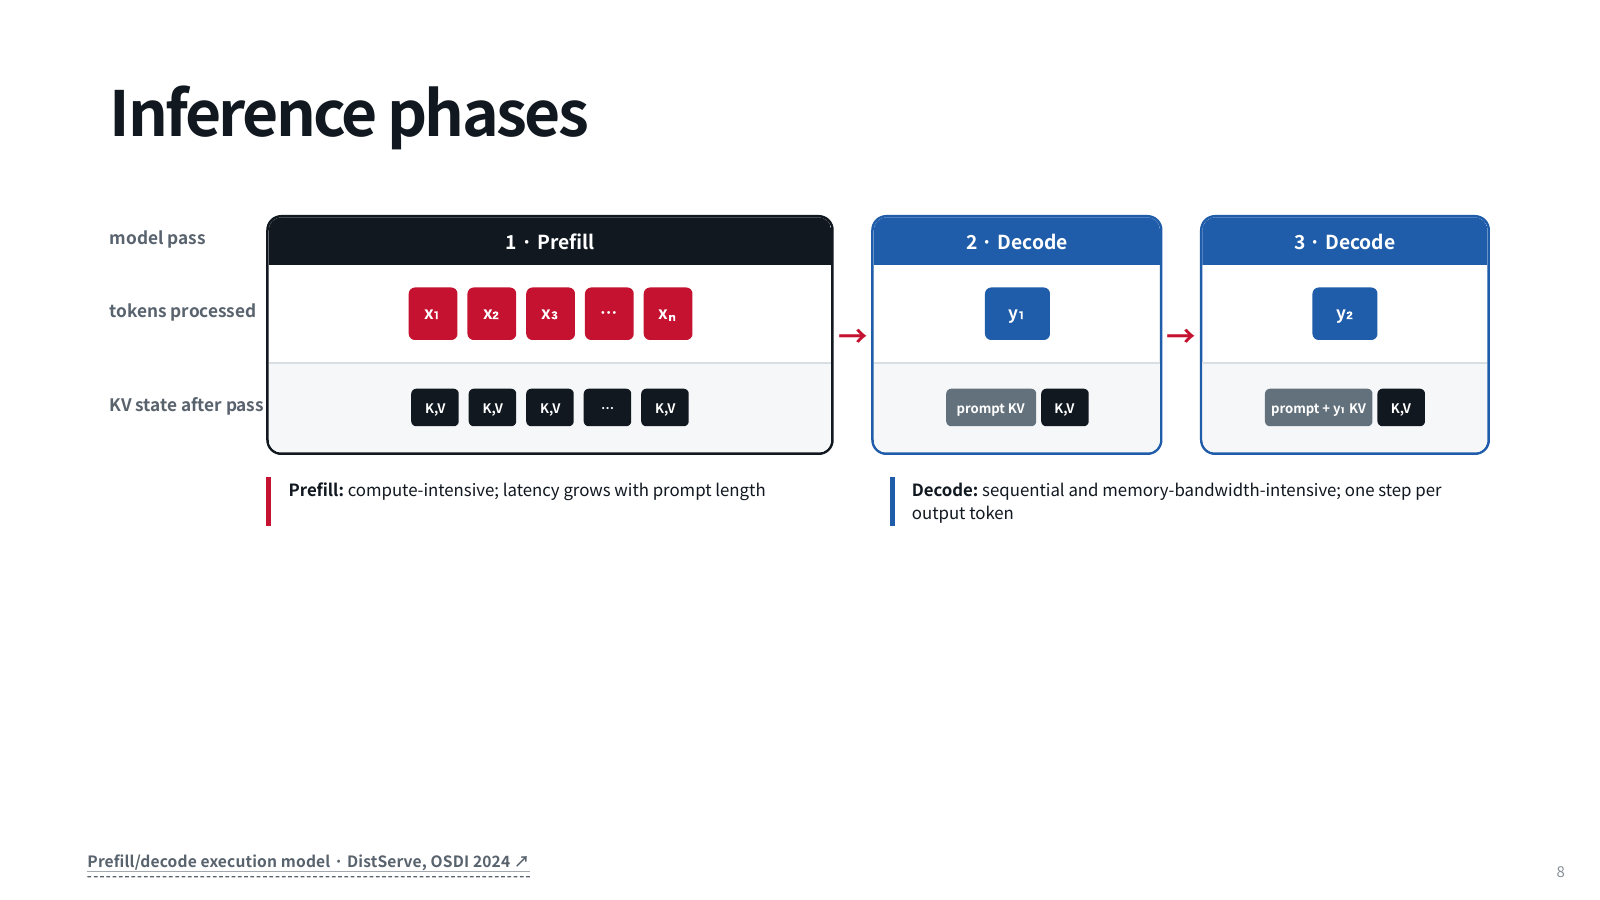
Prefill 可以理解为先处理整段输入,为各位置建立本次计算需要的表示与注意力键值状态。Decode 则是逐步生成输出 token:有了前面的输入与已生成内容,再预测下一个。这两段对硬件和长度的敏感性不同。输入很长,可能迟迟等不到第一个字;输出很长,则可能先很快出现首字、随后还要生成很久。
KV 缓存保留注意力所用的键和值,生成下一 token 时不必从头重算旧位置的全部状态。它不是把答案提前写好,也不是让后续 token 完全没有计算。下一位置仍要利用相关历史状态,缓存占用也随保存内容增长。把“用了缓存”理解成“后续输出免费”会误判延迟和内存。
把四轮输入摊开
第一轮只含前缀;第二轮增加上一轮的动作和结果;第三轮带回前两轮;第四轮再加第三轮。若没有跨请求复用,逻辑上反复出现的前缀与历史可能带来重复计算。若存在合适的前缀缓存,服务可复用一致前缀的状态,实际重新计算量可能减少,但请求的逻辑长度仍然是那些数。
数的是单轮长度,还是累计输入?
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
固定前缀 200,每轮后新增历史 100;考察前四次请求。
- 1. 前两轮
输入分别 200、300,累计 500。
- 2. 后两轮
输入分别 400、500,又增加 900。
- 3. 加总
200+300+400+500=1,400。
输入分别 200、300,累计 500。
先预测,再核对结果与原因
第四轮 500,累计 1,400同一个早期 token 可能存在于多次请求中。
条件不同,慢的原因也不同
保持输出只有十个 token,只把历史增加很多:优先看首 token 延迟和 prefill。保持输入很短,把输出从十个增加到一千个:优先看输出速度和总生成时长。这是两种不同的对照,不能凭总耗时一个数判断瓶颈。工具等待还在模型之外:一个查询等五秒,不能记成模型生成速度变慢。
再比较“重复完全一致的前缀”和“每轮改写前缀”。二者逻辑长度可能相同,缓存机会却不同。系统是否缓存、缓存是否仍驻留、是否满足服务的最小长度等条件,都影响实际结果。因此应同时记录输入长度、输出长度、缓存用量、首 token 延迟、生成耗时与工具耗时;单看账单无法还原计算全过程。
这里累计长度近似二次增长来自等差数列求和,并不表示每一秒的实际延迟必定按同一公式增长。硬件并行、批处理、缓存、队列都会影响时间。数学模型帮助定位重复在哪里,测量才告诉我们哪个部分真的值得优化。
理解检查
问题一:第四轮输入 500,为何累计不是 500? 因为前三轮也调用过模型。累计输入计算的是四次请求相加;第四轮长度只计算最后一次。二者用于回答不同问题。
问题二:开启缓存后,第四轮逻辑输入会自动变成 100 吗? 不会。模型要处理的上下文仍包括前缀和历史;服务可能复用其中一部分状态。应把逻辑 token 数、重新计算的 token 和计费类别分开看。
问题三:截断后更快,是否就应该只保留最后一轮? 不能这样推导。如果最早一轮规定“不要下单”,删除它可能让后续行为违背目标。优化先保留必要状态,再减少重复或无关内容。
下一问
能装下更多历史固然方便,但“允许输入这么长”和“每条约束都能有效取回”是一回事吗?下一节用同一条预算约束的位置变化来拆开这两个概念。