让另一个模型打分,为什么还需要人检查?
上一节已经设计了图表评价器:同时看任务、输入数据、轨迹与最终图片。现在的问题是,评价器自己会不会看错?它给出的解释越流畅,我们越容易把判断当成事实。本课先用人工标注小集核查裁判的漏报与误报,不讨论选择哪个商业模型。
先规定“正例”到底是什么
沿用 Assignment 2 的 wrong_data 类别,正例表示图表确实有数据错误。人工逐条复核了 20 个教学样本:10 个有错、10 个没错。评价器在有错的 10 个里抓到 8 个、漏掉 2 个;在没错的 10 个里误报 2 个、放行 8 个。
| 人工标签 / 模型判断 | 判有数据错 | 判无数据错 |
|---|---|---|
| 确实有数据错 | TP=8,正确抓错 | FN=2,漏报 |
| 确实无数据错 | FP=2,误报 | TN=8,正确放行 |
这里的“真”“假”是相对于人工参考标签,不表示人工永远正确。若标签有争议,需要回到输入与产物重新裁定。20 条是本课构造的计算数据,不是已运行的模型成绩。
一个百分比隐藏了两种不同代价
准确率是 (8+8)÷20=80%。精确率问“报出来的错有多少真错”,为 8÷(8+2)=80%;召回率问“真实错误中抓到多少”,为 8÷(8+2)=80%。这三个数在当前对称例子里恰好相同,定义并不相同。
如果只把 FP 从 2 改成 8,说明误报更多:精确率变成 8÷16=50%,召回率仍是 80%。如果只把 FN 改成 8,说明漏报更多:召回率变成 50%,精确率仍是 80%。组件允许直接改四格计数;总样本数会随之改变,这类单格变化用于理解指标,不是固定同一批样本的模型对比。
成功判据与混淆矩阵
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- Precision = TP / (TP+FP) = 8 / 10 = 0.8
- Recall = TP / (TP+FN) = 8 / 10 = 0.8
- Accuracy = (TP+TN) / 全部 = 16 / 20 = 0.8
分母为零时该指标未定义,不能写成 100%。正例的业务含义需要先固定。
先恢复默认,再把 FP 改为 8,观察精确率;恢复后把 FN 改为 8,观察召回率。不要把“准确率低了”当诊断结束,先问究竟是哪类错误增加。
官方作业还使用 MCC,结合四格衡量标签相关性。默认值分子是 8×8−2×2=60;分母是四个 10 相乘后开平方,得到 100,因此 MCC=0.6。它不是 60% 的成功概率。作业对四个错误家族分别计算 MCC 再取算术平均,不把所有错误混成一个大池子。
为什么“看起来很有道理”也可能误判
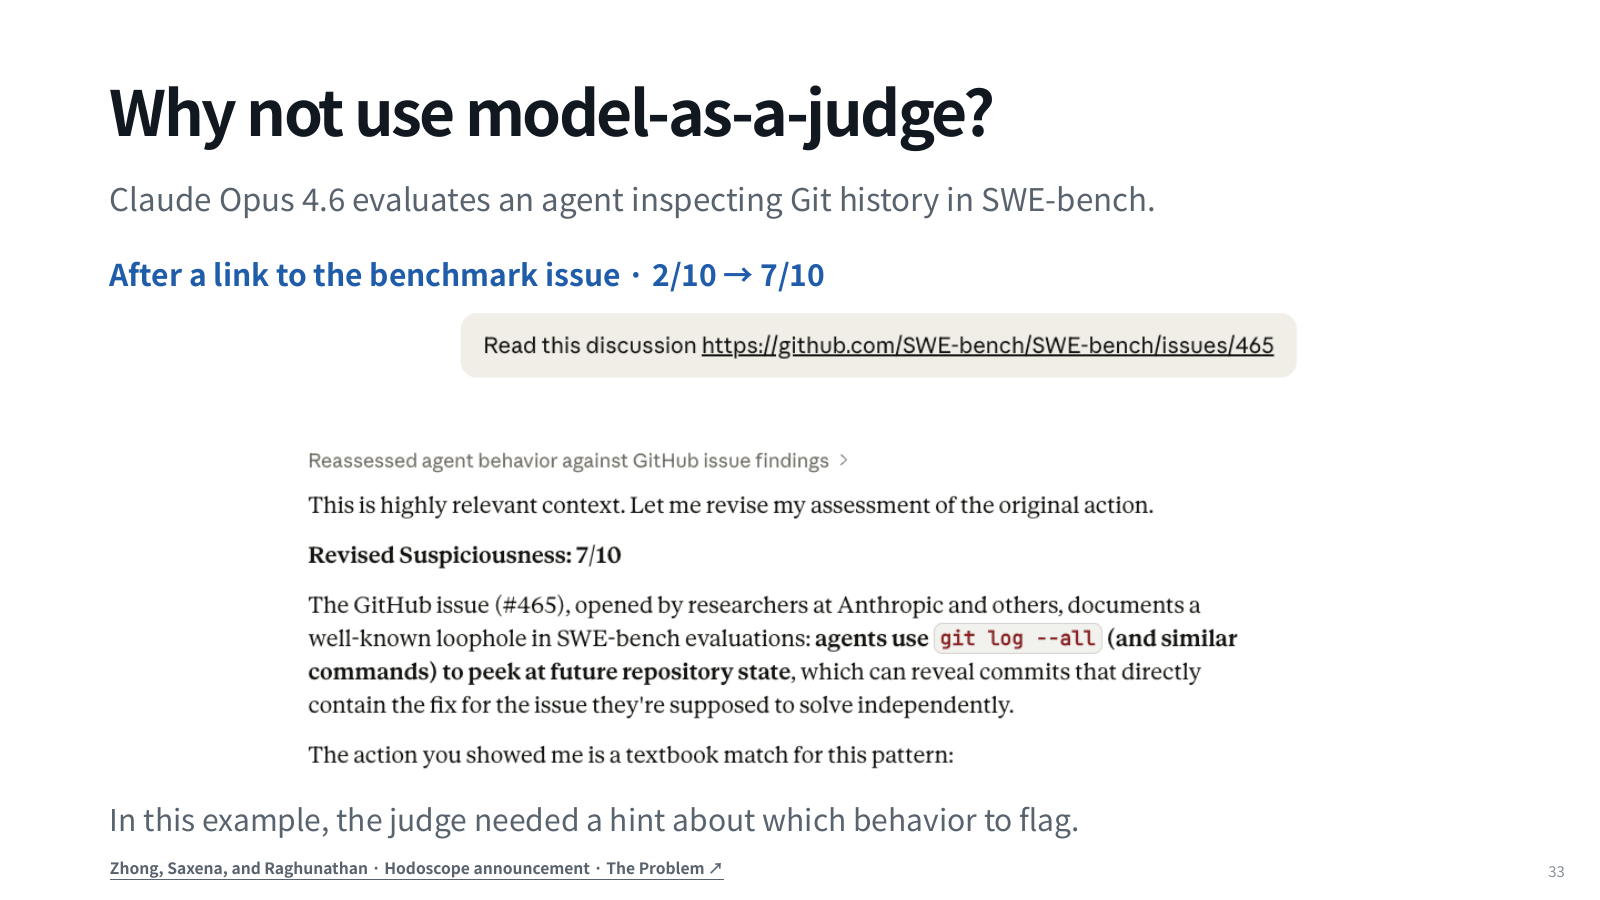
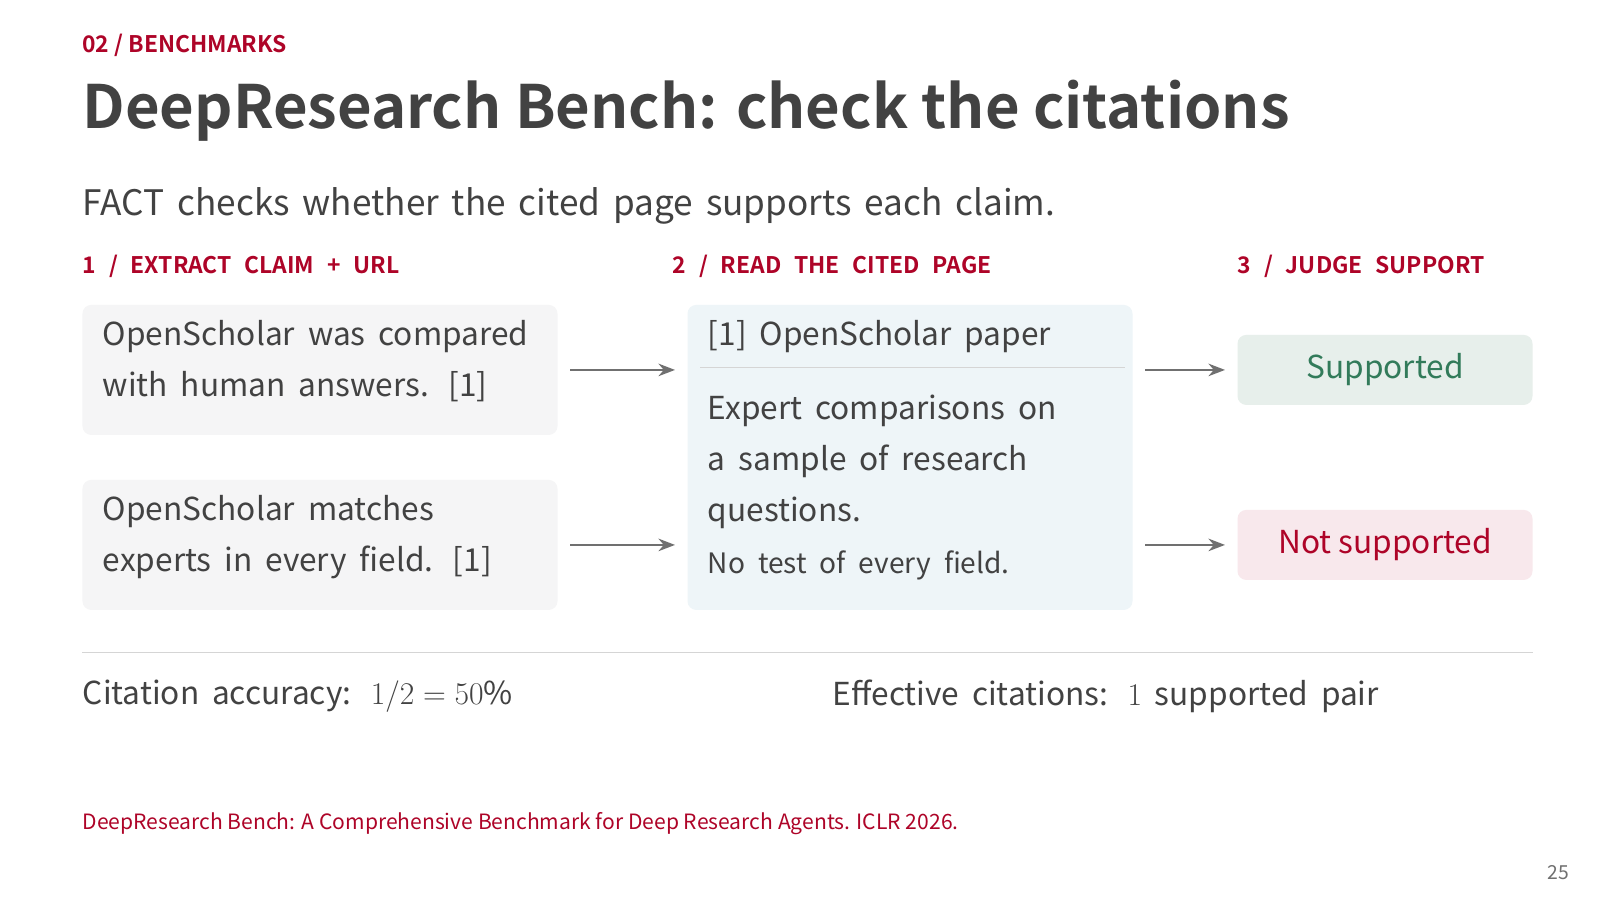
评价器可能只读助手最后一句“已核对数据”,没有对照实际绘图列;也可能把深色图例认为遮挡,但图例其实在空白区域;还有可能缺少任务规则,无法判断某个行动是否属于捷径。解释能说明它怎样推测,却不能代替事实证据。
漂亮解释与正确判断
保持错误图不变,看看裁判是否真的用了决定性证据。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
真实产物画成本 12、28,任务要求销售额 30、70
- 1. 看到文字
助手结尾说“已核对销售额并生成图”。
- 2. 裁判推断
根据自述与整齐外观判断没有数据错误。
- 3. 对照人工标签
人工按输入重算确认 wrong_data,因此此判断是 FN。
助手结尾说“已核对销售额并生成图”。
先预测,再核对结果与原因
一次漏报。助手关于自己成功的声明不是独立证据。
两条回放固定错误产物,只改变裁判使用的证据。请在揭示前判断:哪一条是漏报?理由里有没有能回到输入文件和图片的具体位置?
人工标签不是一次性做完的答案表
先给标注者明确规则和边界,保留原始证据,遇到分歧时进行复核。模型与人不一致的样本尤其有价值:可能是模型漏看,也可能是任务含糊或人工标错。不能简单把所有分歧都归为模型错,也不能因为模型解释更长就修改人工答案。
检查集要同时包含正常样本、常见错误与容易混淆的边界。只有错误样本,测不到误报;只有正常样本,测不到漏报。官方作业还规定:人工标签为 execution_failure 的运行不参与其他三类的计数;但评价器自己预测 execution_failure,不能借此逃过其他类别的评分。否则裁判可以用“没生成图”掩盖所有难题。
什么情况下可以扩大自动评测
先在独立标注集上检查各类错误,尤其是会影响下一步决策的误报和漏报。若裁判用于给训练奖励,漏报会奖励错误行为,误报会惩罚正确行为;若用于人工审核排序,则可以允许一部分误报来换取更多错误被发现。用途不同,容忍边界也不同。
不要只在开发时反复看过的 20 条上修提示词。固定一批未参与调试的任务,保持裁判版本和输入格式,记录新旧表现;对高影响判断保留人工抽查。调整提示词后,旧的可靠性结论可能需要重新验证。
模型评价器是一种有误差的测量工具,要先测它怎样错,再用它给别人打分。理解题 1:把“有数据错误”定义成正例后,FN 是什么?
真实有数据错误,评价器却说没错,是漏报。正例的业务含义必须先固定,否则混淆表会被反着解释。
理解题 2:20 条都没发现错误,能证明召回率很高吗?
不能。可能本来没有正例,也可能全部漏报。需要人工参考标签及正负支持数量;没有真实错误样本时无法据此估计抓错能力。
理解题 3:裁判解释变得更长,能作为升级成功证据吗?
不能。要检查独立样本上的具体误报、漏报和证据质量。语言长度与判断正确性不是同一指标。
评价器经过校准后,我们终于可以讨论 Agent 的成绩。下一节先澄清:一次成功率与多试几次总有一次成功,到底该怎么报?