检索器找到了相关网页,为什么 Agent 还是答不出当前问题?
上一节把研究拆成一组尚待验证的主张。Agent 每次搜索都在为其中一个缺口找证据。但检索器通常只看到这一次传入的查询,不自动拥有 Agent 前面读过的所有资料。本课从原课的 Simon 与 Turing Award 例子解释“相关”和“对当前一步有用”的差别,不展开大规模向量索引实现。
查名字与查关系,是不同的需求
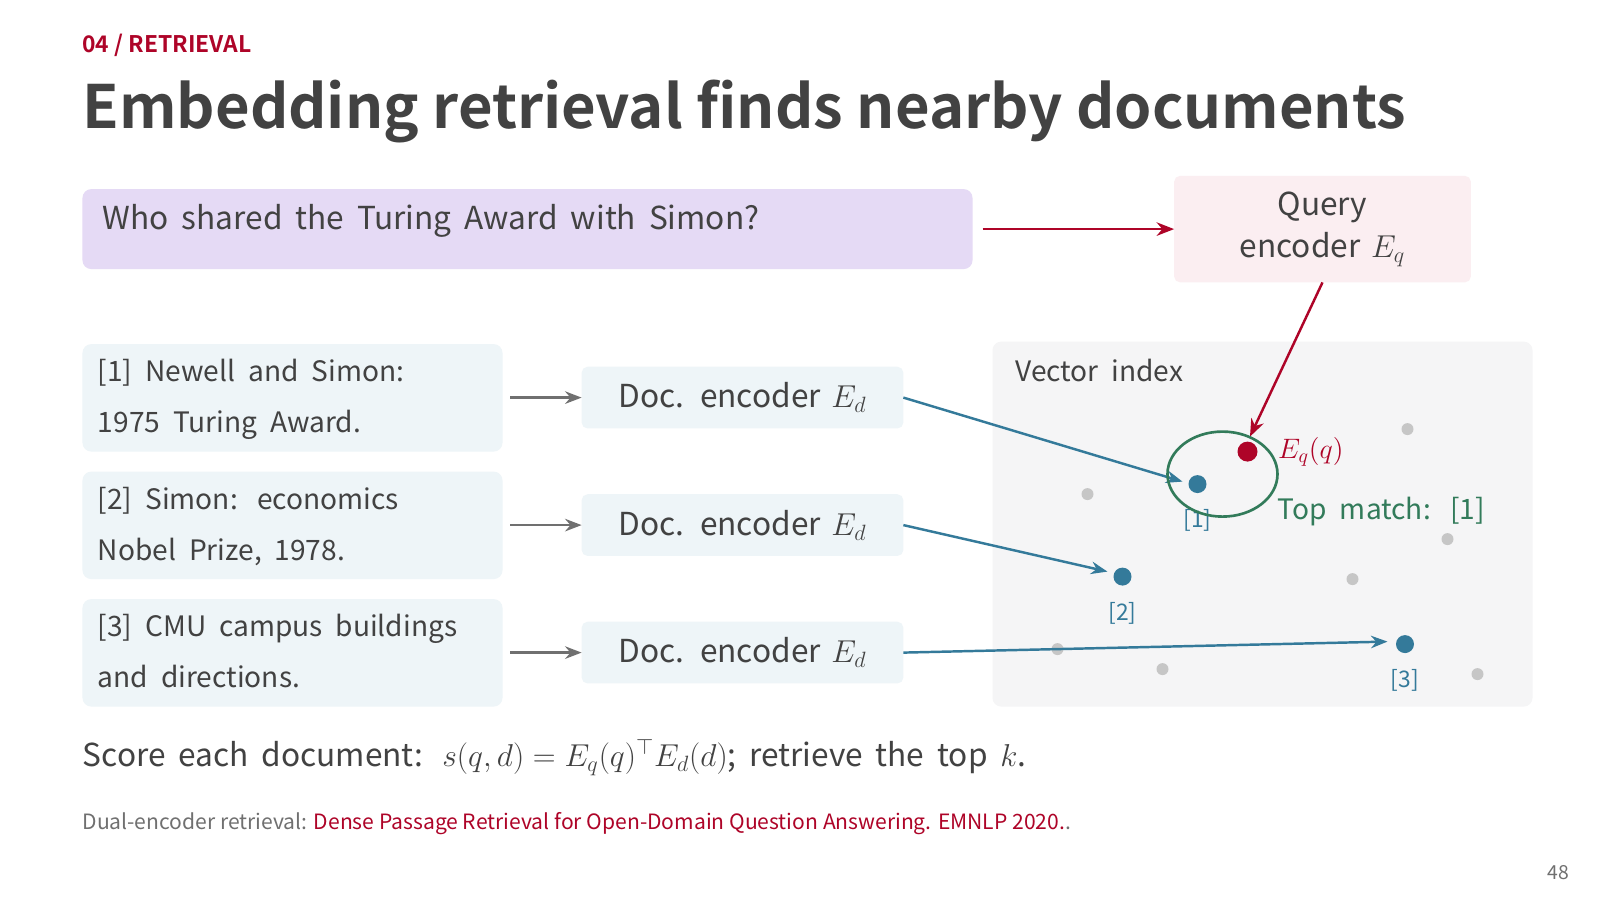
原课问题是“谁与 Simon 共同获得图灵奖?”资料库里有三条:Newell 与 Simon 于 1975 年获图灵奖;Simon 于 1978 年获得经济学诺贝尔奖;CMU 校园建筑与路线。第二条确实与 Simon 有关,却不能回答“和谁共同获图灵奖”。
如果 Agent 只发送 Simon award,它丢掉了任务中最关键的关系。一个检索器完全可能优先返回介绍 Simon 奖项的长传记。这里不是网页内容一定错误,而是本轮输入没有清晰表达缺口。
向量分数告诉我们什么
双编码器把查询与文档分别变成向量,用点积等相似度给候选排序。为了手算,取教学查询向量 (1,0);文档 A 向量 (0.8,0.1),B 为 (0.6,0.7)。点积分别为 1×0.8+0×0.1=0.8 与 1×0.6+0×0.7=0.6,所以 A 排在 B 前。
这两个维度只是用于演算点积的人工向量,不是某模型真实 embedding,也不能解释成“第一维是图灵奖”。0.8 同样不是事实有 80% 概率正确。编码器只根据训练得到一种排序函数,检索结果还要通过原文核对。
若查询向量改成 (0,1),同样文档分数变成 0.1 与 0.7,顺序反转。这个小算式说明,文档集合不变,查询表达的方向改变也能改变排序。真实系统里语义与向量的关系更复杂,但查询遗漏关键关系仍可能使检索目标偏移。
Agent 想得很清楚,为什么工具不知道
模型可能在上下文中已经记下“知道 Simon,缺共同获奖者,排除诺贝尔奖”。如果工具调用只传 Simon award,后面三个限制都不会穿过接口边界。把推理写在上一条助手消息里,不等于检索 API 收到了它。
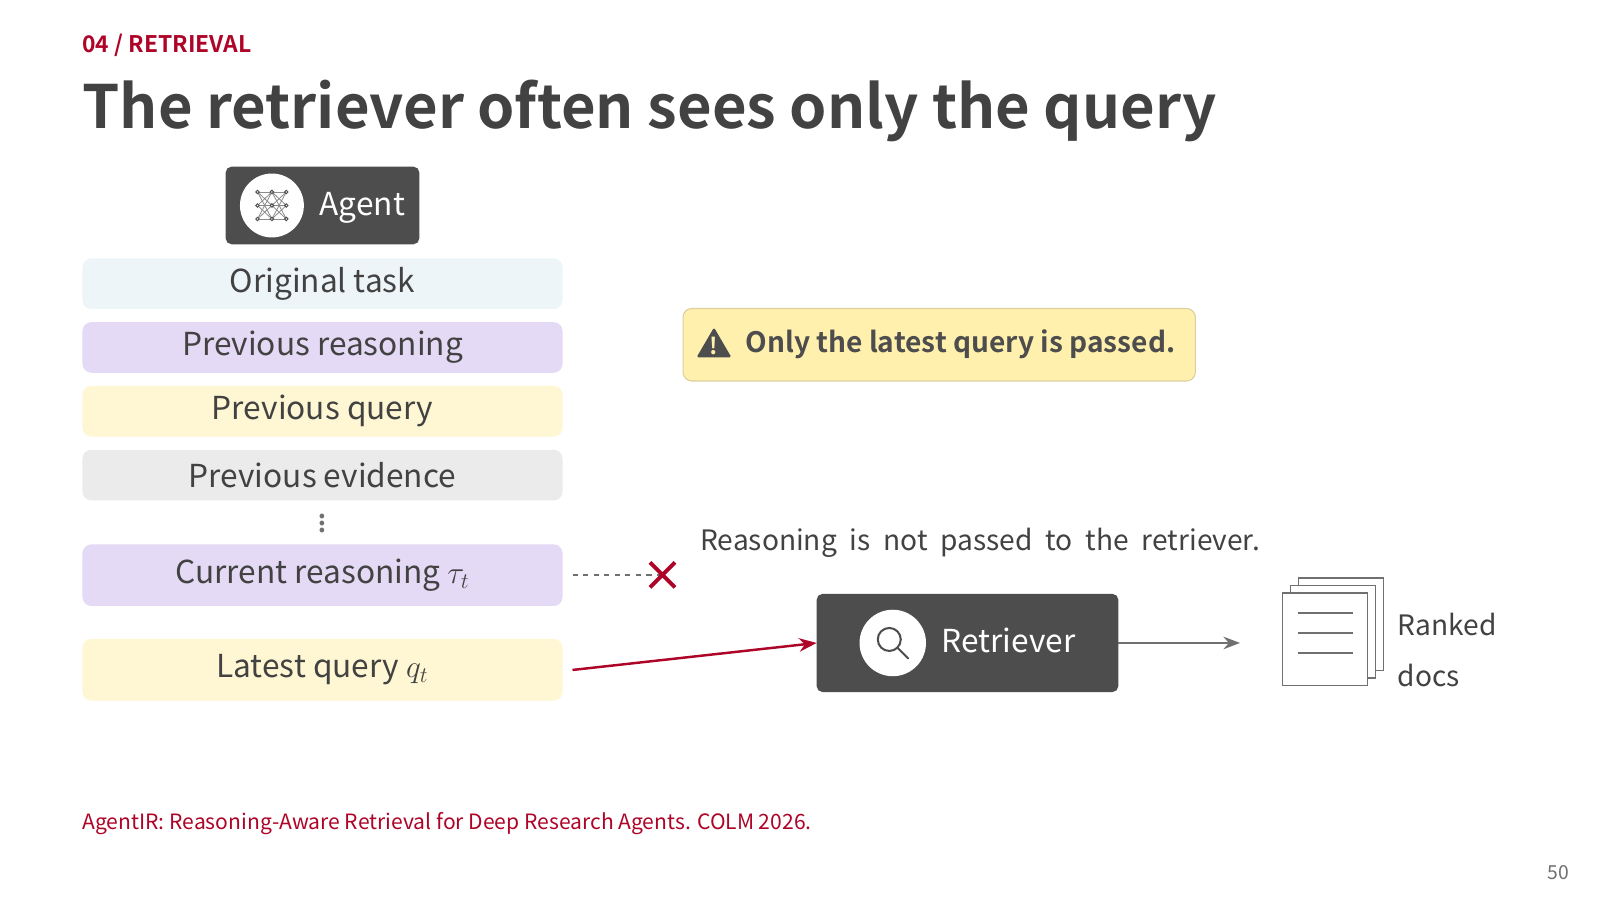
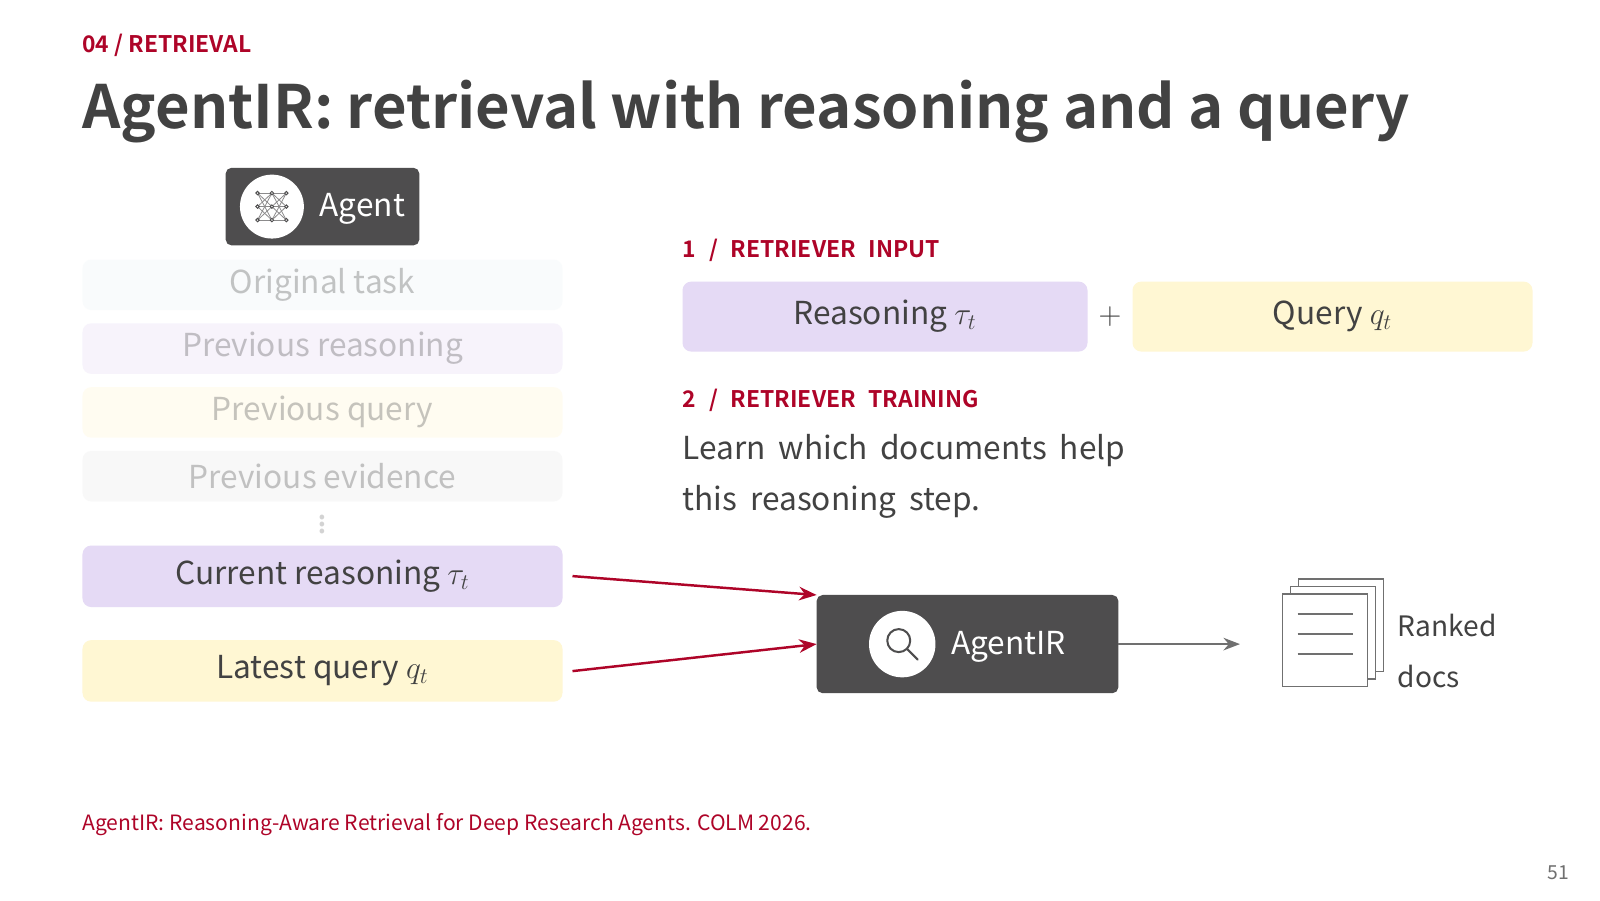
最直接的改善是把当前缺口写进可独立理解的查询,比如 Herbert Simon Turing Award shared with,随后核对原文实体与年份。更进一步,可以训练检索器同时接收当前推理状态和查询,让它学习什么资料对这一轮有用。原课介绍的 AgentIR 属于后一种路线。
让查询带着缺口出门
先读 Agent 已知事实,再检查工具输入实际保留了多少。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
资料库含共同图灵奖、诺贝尔奖、校园路线
- 1. 当前缺口
Agent 已知 Simon,真正缺的是共同获图灵奖的人。
- 2. 工具输入
只发送 Simon award,关系和奖项类型丢失。
- 3. 读回候选
假设返回诺贝尔奖介绍,实体相关但不能回答共同获奖者。
Agent 已知 Simon,真正缺的是共同获图灵奖的人。
先预测,再核对结果与原因
还需要澄清查询并检索。内部知道的约束没有穿过工具接口。
这组回放固定资料库,只改变查询是否带出缺失关系。返回顺序是教学场景设定,用于解释接口信息流,不宣称某搜索引擎实际会按此排序。
更多历史也会带来噪声
反过来,把整个研究过程都发给检索器未必最好。历史中可能有已解决的问题、错误猜测、过时资料。我们需要当前缺口和必要约束,而不是所有文字。若 Agent 最初猜错“是诺贝尔奖”,不断把猜测放进新查询,还会把检索推向错误方向。
应把已确认事实、待验证假设和查询目标分开记录。得到新证据后,允许推翻原假设;若同义改写总返回同一组资料,就考虑是否问错了关系、来源集合缺失或需要另一种工具。增加 top-k 可以扩展候选,但也会增加阅读成本,不能取代问题表达。
怎么决定下一次搜索值不值得
先列当前报告最重要的缺口,再估计这次搜索能补哪一个。给每次调用设一个可核对的问题,比如“找到共同获奖者原始记录”,而不是“了解更多”。读回结果时记录有无新增证据;连续得到重复资料时,应改变策略或明确未知,而不是把搜索次数当进展。
验收用保留的中间研究状态测试:同一个全局问题,在不同阶段需要的文档是否不同;查询中是否保留实体、关系、时间限制;排序靠前的文档是否实际支持当前主张。检索质量与最终报告质量相关,但不能用最终答案对错完全替代本轮文档有用性的判断。
检索器只能依据收到的信息排序,Agent 要把“现在缺什么”准确传出去。理解题 1:文档提到了 Simon,为什么仍可能无助于这次搜索?
它可能只介绍诺贝尔奖,没有共同获得图灵奖的关系。实体相关只是必要线索,不等于能补上当前缺口。
理解题 2:点积 0.8 是否意味着事实正确率 80%?
不是。它是相似度分数,数值含义取决于编码与归一化。事实支持关系还要读取原文判断。
理解题 3:把全部历史传进去一定胜过短查询吗?
不一定。多余或错误历史会引入噪声,检索器也未必训练过这种输入。应传与当前缺口有关的已知事实和限制,并通过对照评测选择接口。
现在研究过程已经能追踪证据。下一节问训练问题:怎样让模型学会这套过程,而不只是学会报告的文风?