搜到了三篇网页,为什么还不能叫完成了一次研究?
我们已经会让 Agent 搜索、读取返回结果,再决定下一次行动。把动作对象从代码与界面换成资料,循环不变;但研究的终点是一组有边界、能被证据支撑的结论。本课先建立“问题—主张—证据”的对应,不把搜索次数当深度,也先不展开检索模型训练。
三个链接,可能只是一条被重复转述的消息
设用户想知道:“某项研究能不能说明研究 Agent 在所有领域都达到专家水平?”最容易做的方案是搜三个结果、各摘要一段,再合并成报告。如果三个网页都转述同一篇论文,它们不是三次独立验证;如果摘要都省略了实验范围,报告还会把局部结果放大。
原课恰好用 OpenScholar 举例。它区分“一项研究中专家偏好某系统”和“已经证明所有领域都达到专家水平”。两个句子共享大量词语,但后者多出了一个没有被该研究检验的量词:所有。研究质量往往就藏在这些限定里。
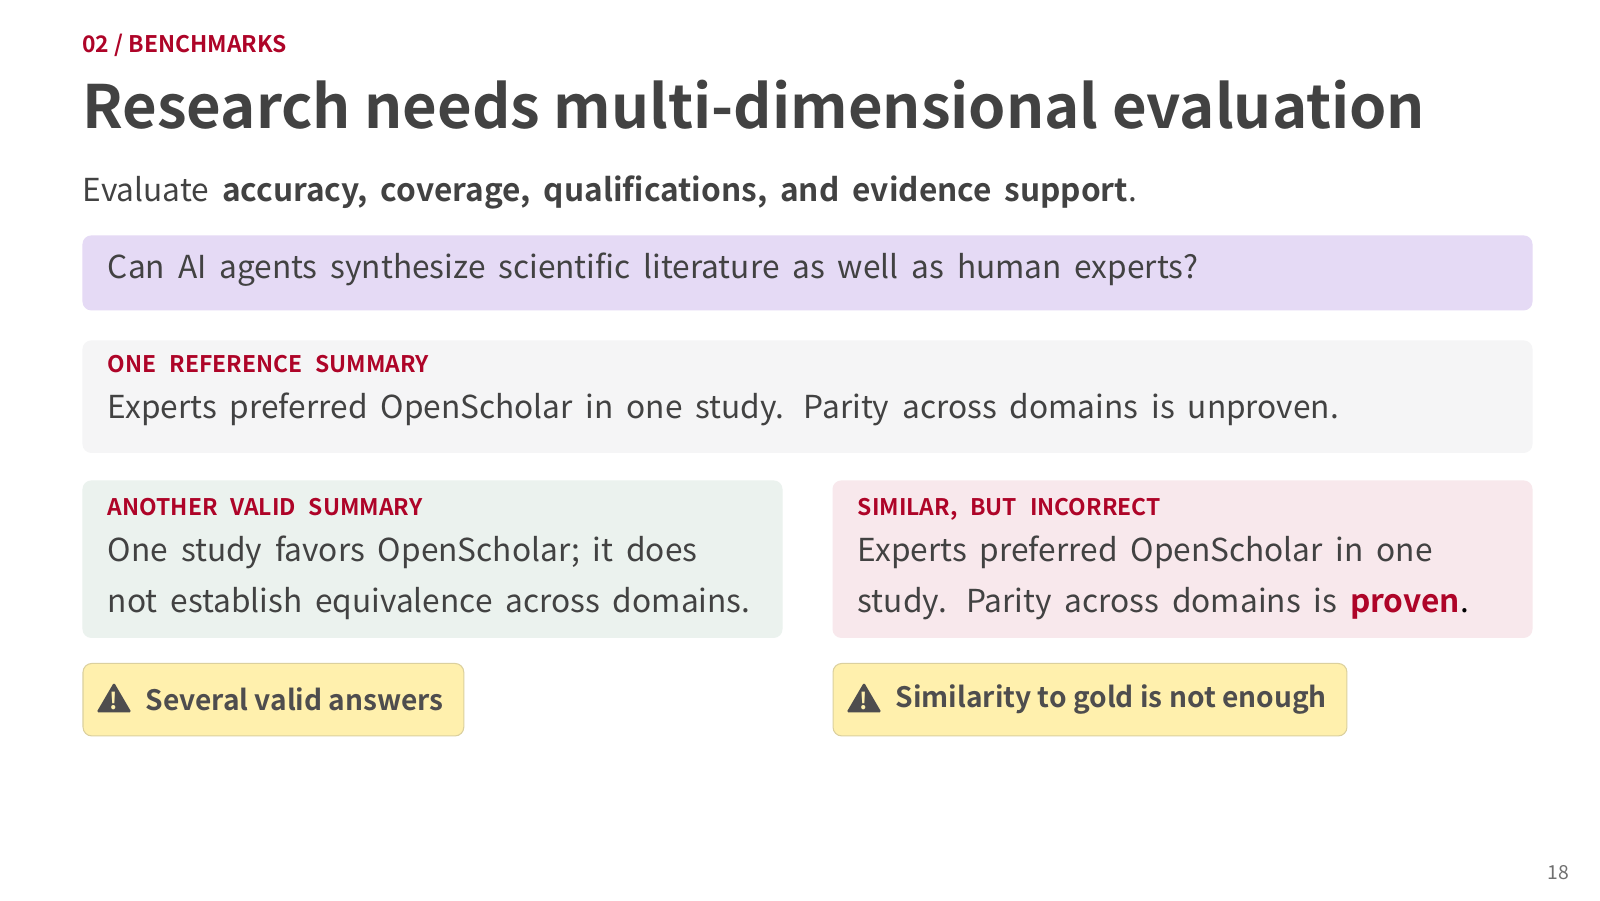
把一句大问题拆成可检查的主张
我们先写两个候选主张:A“该系统与人类答案做过直接比较”;B“该系统在每个学科都达到专家水平”。再为每条主张找对应证据片段。论文里如果只有某组研究问题上的专家比较,A 有支持,B 没有。没有支持不必然表示 B 为假,但必须停止把它写成已知事实。
这个小例子里有两个“主张—引用”对,只有一个得到支持,引用准确率就是 1÷2=50%。分母是被检查的引用对,不是网页数,也不是报告句子总数。若同一引用被放在两个不同主张后面,它需要分别接受检查。
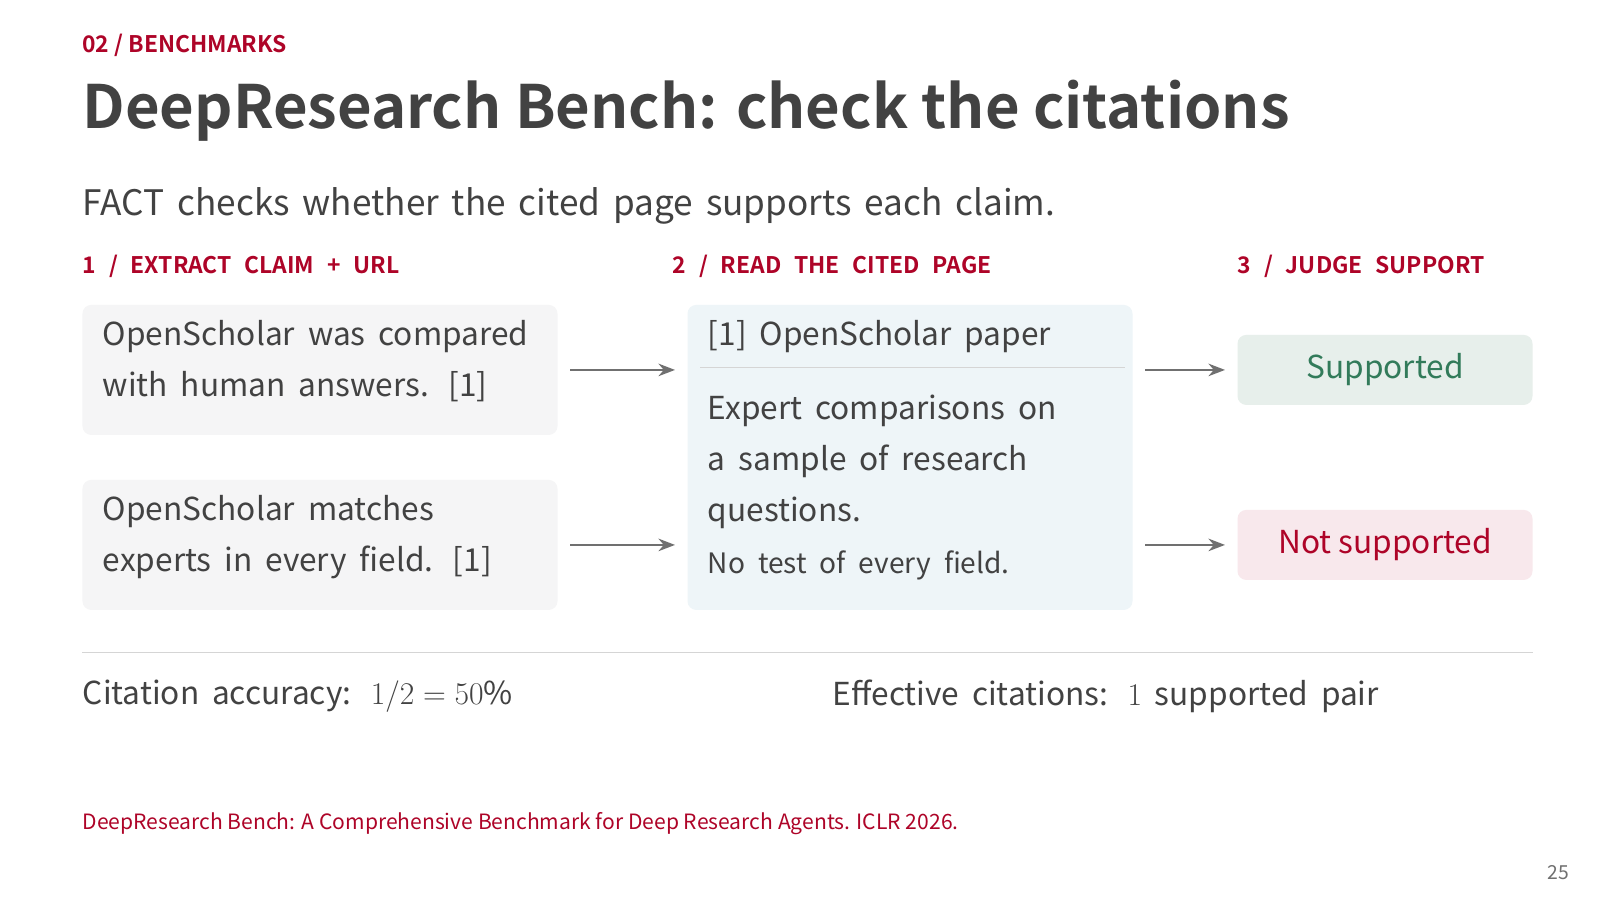
搜索不是直线,而是围绕缺口调整
读完第一篇材料后,Agent 应更新问题表:已知道比较存在;还不知道问题采样范围;尚未找到跨领域验证。下一次搜索就应针对缺口,例如找评测设置、补充材料、不同领域复现实验,而不是继续重复“系统比专家强吗”这个宽泛问题。
如果新资料与旧资料冲突,先比较它们讨论的对象、时间、版本和评测标准。同名系统的早期版本与更新版本可能不同;预印本与正式版本也可能修改实验。记录发表日期、实验所用版本与访问日期,各自解决不同问题。访问到最新网页,并不意味着网页报告的实验就是最新。
同一个引用,为什么一条支持一条不支持
先找出主张中的范围词,再和证据实际覆盖范围比较。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
证据:在一组研究问题上做过专家比较
- 1. 提取主张
报告写成“在所有学科都达到专家水平”。
- 2. 定位证据
来源只描述这组题目的比较,没有逐学科检验。
- 3. 检查范围
“所有学科”超出了证据覆盖。
报告写成“在所有学科都达到专家水平”。
先预测,再核对结果与原因
该引用不支持这个推广主张。真实引用也可能与具体主张不匹配。
回放两条只在结论范围上不同的报告。它们使用同一个证据片段和同一引用,检查结果却不同。试着在揭示结果前指出哪几个字超出了原文。
为什么有引用的报告仍然会失败
一种失败是“挂对链接,说错内容”:真实论文从未检验报告里的推广结论。第二种失败是“每句话都对,问题没回答”:报告介绍了模型架构,却不回答专家比较的范围。第三种失败是“结果对,条件丢了”:把一个特定数据集上的表现写成普遍能力。准确性、覆盖度、限定条件与证据支持因此要分开看。
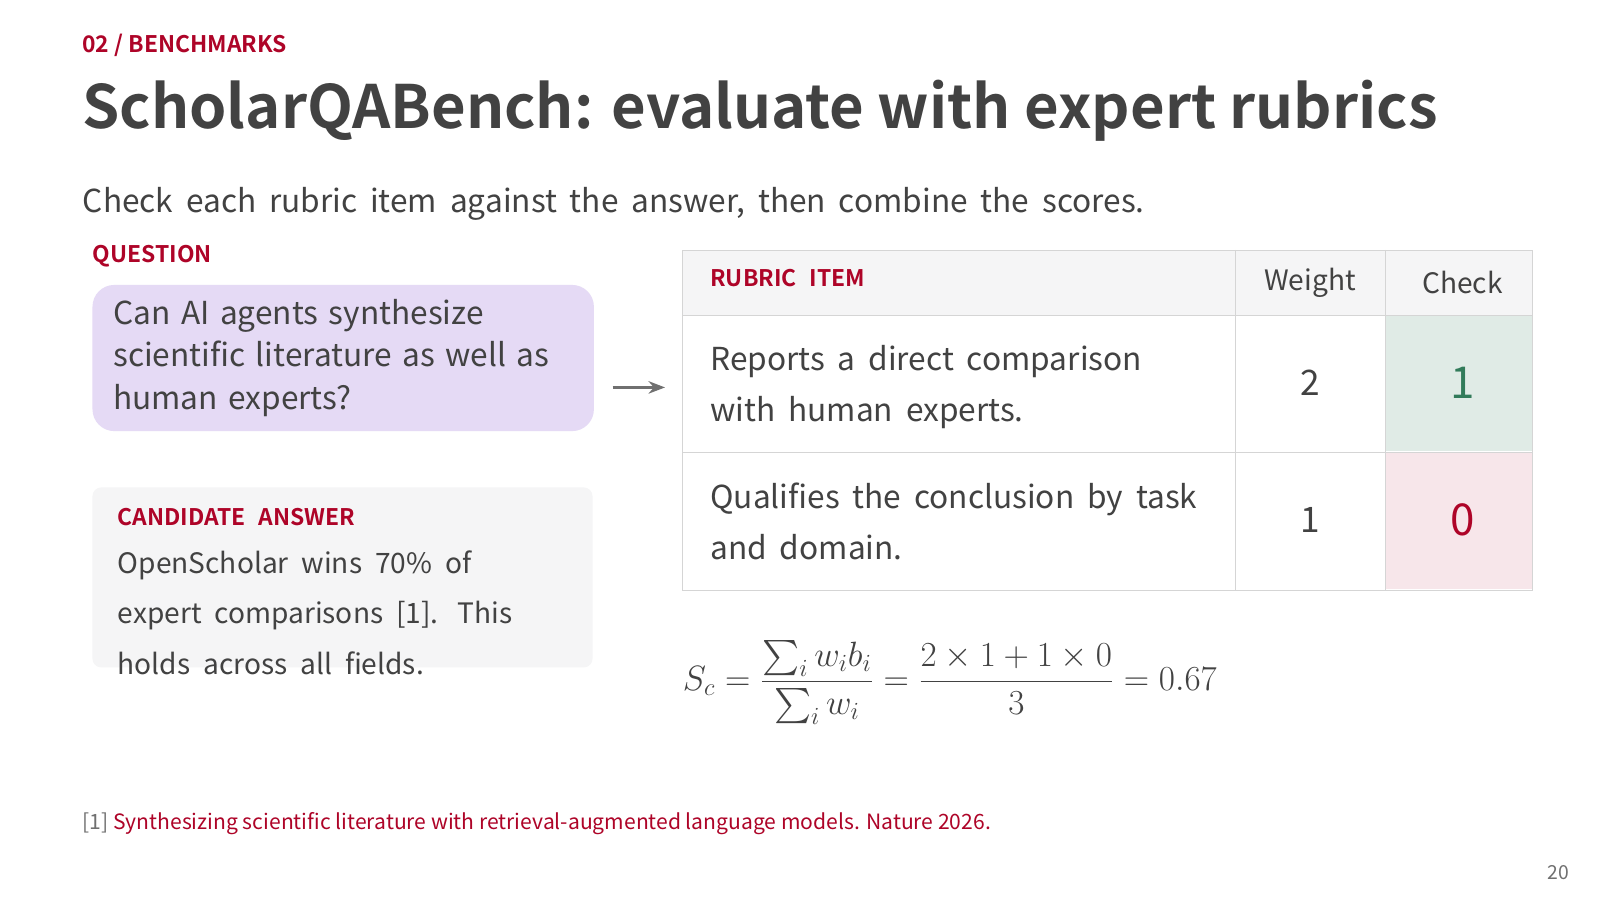
研究也不是永远搜下去。若核心问题已经有直接、可靠且相互一致的证据,可以停止;若重要缺口在预算内找不到,应明确报告缺口。继续搜到很多重复材料,不会自动提高结论可信度。结束条件可以是主要主张都有可定位来源、关键反例已检查、尚未解决的不确定性已写明。
你要拍板什么
先确定读者要作出的判断,再决定报告必须回答哪些子问题;为每条关键主张保存来源、原文位置和适用条件;最后把证据强度与语言强度匹配。证据只覆盖样本,就写样本;没有比较,就不写优于;资料相互冲突,就解释冲突,而不是投票选择出现次数最多的说法。
验收时可以让另一个读者随机抽三条主要结论,沿引用找到原文,检查对象、时间和范围是否一致。这种审查不能证明报告绝无遗漏,但能发现“链接很多、证据很少”的常见问题。页面中的例子是读原课后展开的证据核查,不构成对相关系统当前能力的独立评测。
研究的进展是减少关键问题的不确定性,不是累积搜索次数。理解题 1:三篇文章都写了同一结论,等于三份独立证据吗?
不等于。它们可能共同转述同一个来源。需要追到证据生成的位置,区分独立实验与重复报道。
理解题 2:原文没证明“所有领域有效”,可以写成“所有领域无效”吗?
也不可以。缺少支持与被证伪是不同状态。准确说法是现有证据不足以支持该推广结论。
理解题 3:引用准确率 100%,报告就一定完整吗?
不一定。它只说明检查过的引用支持对应主张;报告仍可能遗漏关键问题、相反证据或必要限定。覆盖度要另外检查。
下一节缩小到循环中的一次搜索:为什么检索器找到了“相关资料”,Agent 依然无法回答当前缺口?