用一百篇漂亮报告训练,为什么不一定能训练出会研究的 Agent?
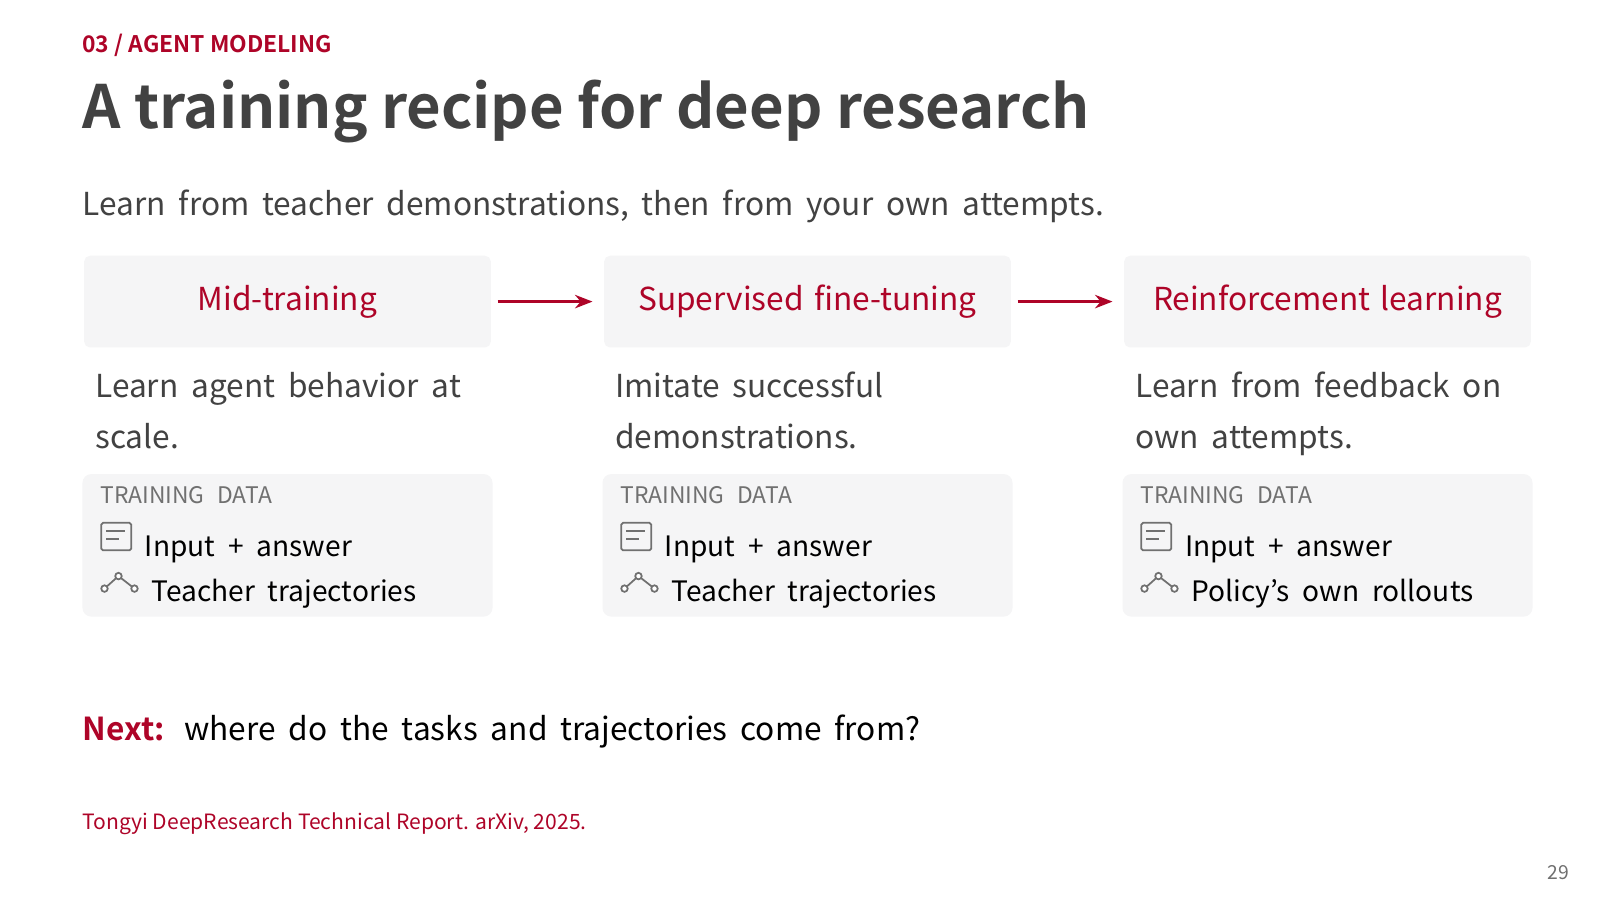
上一节解释了搜索输入如何表达当前缺口。现在希望模型自己学会提出查询、读证据、修改判断、写出有边界的报告。只收集最终成文,模型看不到中间哪些信息是后来查到的,也看不到错误假设何时被推翻。本课区分模仿研究过程与根据结果改进过程,先不推导完整强化学习优化公式。
报告能告诉模型结果,未必告诉它怎样得到结果
把问题“谁与 Simon 共同获图灵奖?”和答案“Allen Newell”组成样本,能训练模型回答这个配对。把它扩成一篇语言流畅的说明,仍不保证模型学会在陌生任务里选择查询。真正的研究示范还应记录:先查共同获奖关系;发现诺贝尔奖页面不回答问题;改写查询;读到包含两人姓名的记录;最后引用这条证据。
这里不是说最终答案没有价值,而是它监督的信息有限。同一个答案可以来自查证、记忆、猜测甚至碰巧命中。我们要训练需要工具的行为,就必须让数据包含工具调用前后的上下文与选择。
示范先筛选,再模仿
原课的过滤条件包括答案正确、格式有效、轨迹连贯。三个条件并不互相替代。答案正确但工具调用格式损坏,训练后可能无法执行;调用都有效但最后答案错误,也不能当成功示范;最终答案正确而引用与过程无关,则有可能只是在猜。
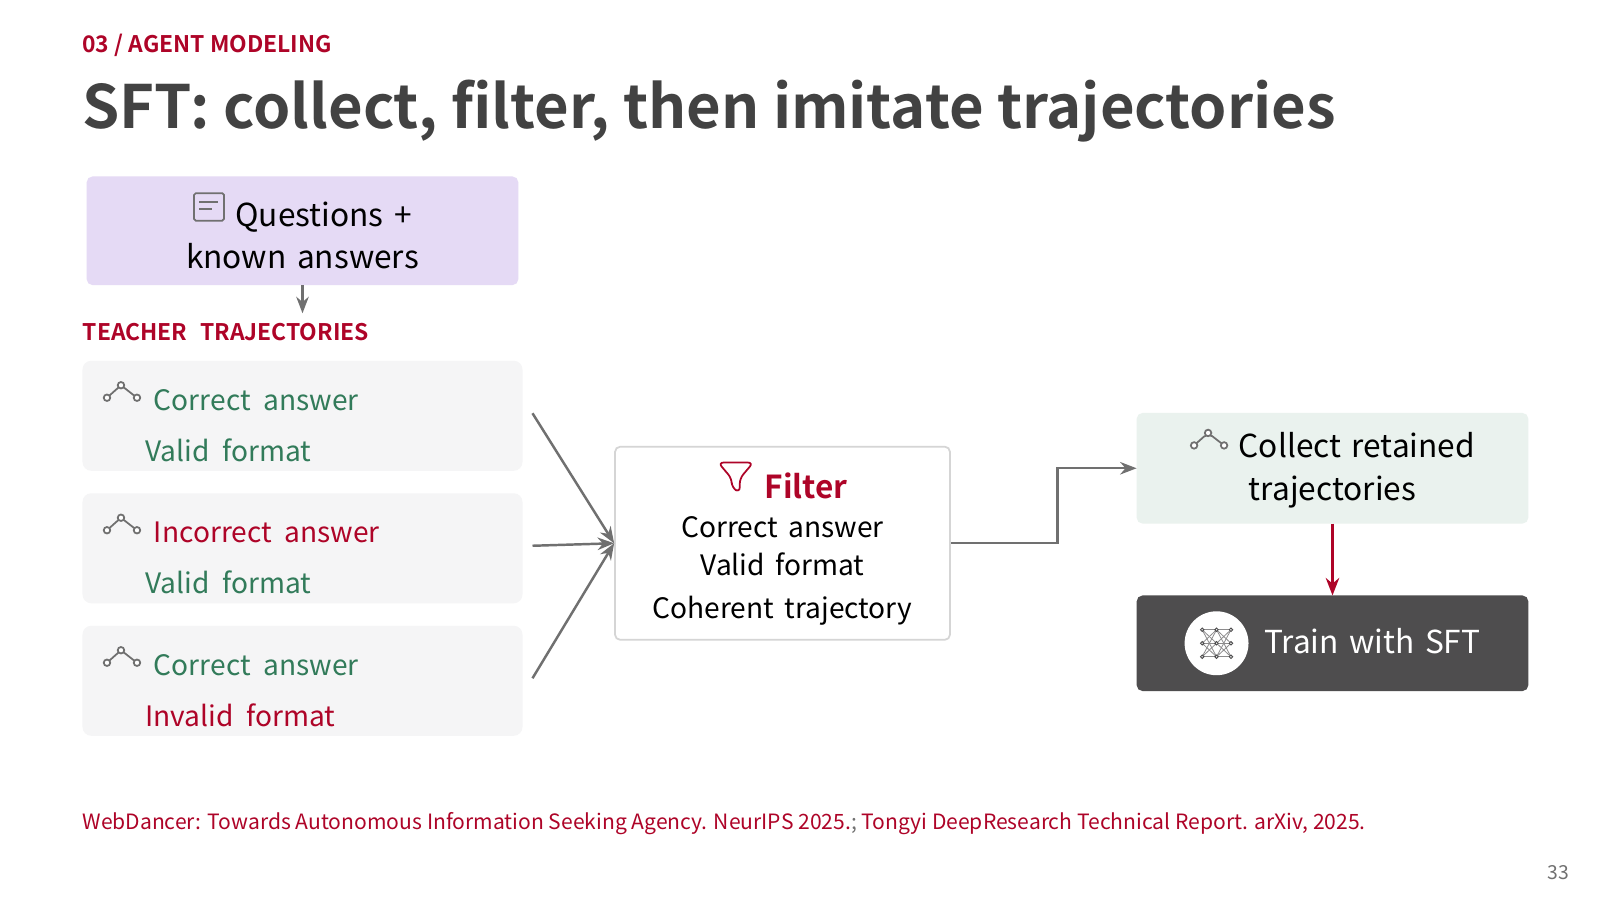
为了看清区别,设教学数据有三条轨迹:甲查到原文并正确作答;乙调用格式正确但答成 Herbert Simon;丙答案是 Allen Newell,却引用校园路线页。只按最终答案保留会留下甲、丙两条,其中一条没有支持结论的证据。加上引用核查后只保留甲。这个 2→1 是对这三条构造样本的筛选计数,不是某论文的真实数据淘汰比例。
简短答案容易验,开放报告为什么难
如果标准答案是一个姓名,可以做实体规范化后的匹配,再给 0 或 1。原课演示三次尝试的奖励为 0、1、1;均值是 2÷3。相对于组均值,第一个低 2/3,另外两个各高 1/3。这说明组内比较的方向;实际 GRPO 还涉及标准化、概率比裁剪和可能的参考策略约束,不能把这几个差值当作完整梯度。
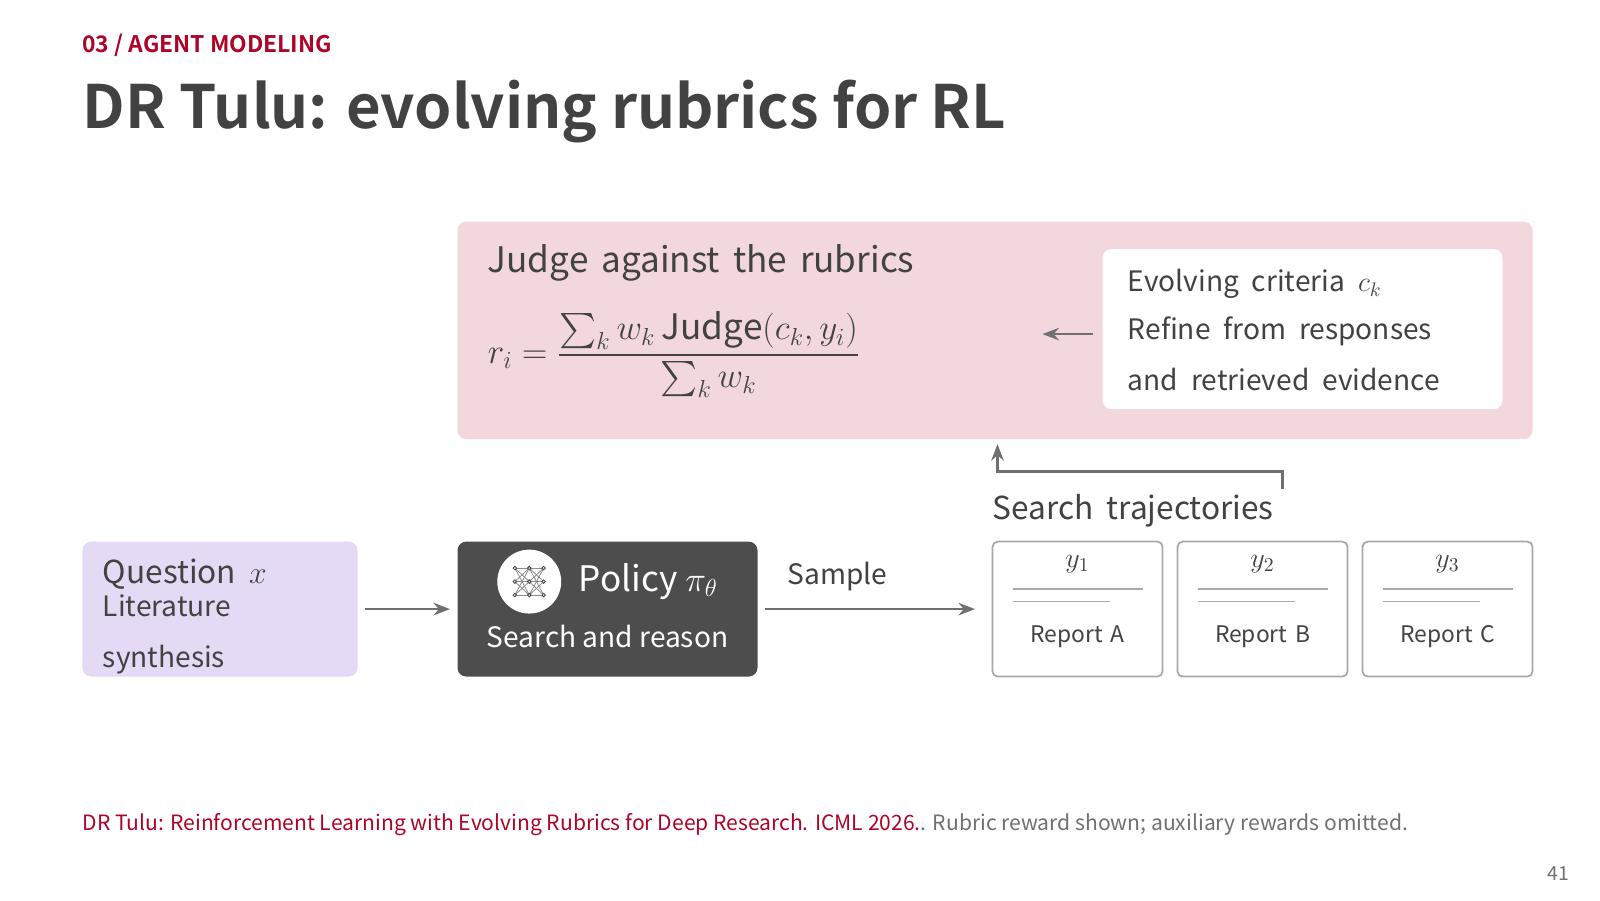
开放研究报告没有唯一文本答案。两个报告措辞完全不同,可能都准确;一个只替换“未证明”为“已证明”的报告却可能改变整个结论。于是奖励要检查覆盖度、相关性、事实正确性、引用支持等具体维度。
用两条规则算一次奖励
沿用原课的简化评分:直接报告人类比较,权重 2;限定任务与领域范围,权重 1。报告 A 提到了比较,却宣称适用于所有领域,得分 (2×1+1×0)÷3=2/3。报告 B 两项都满足,得分 1。差异来自结论边界,不来自篇幅或术语数量。
报告奖励到底奖励了什么
只改变结论范围,观察加权评分及错误类型的变化。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
评分规则:直接比较权重 2;范围限定权重 1
- 1. 检查比较
报告明确说明与人类答案有直接比较,获得 2 分。
- 2. 检查限定
报告把样本结果推广为所有领域,获得 0 分。
- 3. 归一
总分 2,满分 3,所以 2/3≈0.667。
报告明确说明与人类答案有直接比较,获得 2 分。
先预测,再核对结果与原因
得分约 0.667,仍有范围错误。不能用第一项得分替第二项作保证。
这两条报告保留相同研究事实,只改变是否把局部结论推广到所有领域。先对第二项作判断,再查看加权结果。组件演算固定 rubric,不调用真实裁判模型。
奖励设计错了,模型会认真学错目标
如果奖励只数引用个数,模型可以在每句后面重复链接;如果奖励只看报告长度,它可以补很多无关背景;如果只查答案姓名,它可能在正文列出所有候选。这些都能提高形式指标,却没有改善研究。
因此奖励中的每项必须对应用户真正需要的行为,并用反例检查。对引用,要问是否支持主张;对覆盖,要问是否回答必须解决的子问题;对限定,要问是否忠实于证据范围。不同维度冲突时,可以设置不能被平均分掩盖的底线,例如关键事实错误需要单独标记,而不是靠文风高分抵消。
也要警惕评分标准从候选报告中更新时的自我迎合:若所有候选都漏掉同一个重要问题,自动生成的标准可能一起漏掉。保留专家定义的核心要求、人工抽查和未参与奖励开发的评测任务,才能检查这种偏差。
人该决定什么
先明确训练要改善哪个环节:查询、证据读取、综合还是停止;然后选择能观察该环节的轨迹与反馈。验收时让模型面对新问题,检查工具过程是否有效、主张能否回溯来源、遗漏是否减少,同时记录预算。更长的搜索过程不天然更好,省掉关键查证也不能被低成本掩盖。
训练研究能力,要让奖励对准证据与判断,让示范包含获得证据的过程。 监督与强化学习提供机制,究竟改善多少要通过独立任务评测。
理解题 1:答案姓名正确,能证明轨迹适合做成功示范吗?
不能。还要检查工具格式与证据链。正确答案可能来自猜测或与引用无关的记忆,不能直接监督需要查证的过程。
理解题 2:为什么 2/3 的报告仍可能有严重问题?
加权平均把多个维度压成一个数。它可能只在高权重比较项得分,却在范围限定上过度推广。应保留分项和关键错误标记。
理解题 3:自动生成评分条目后,还需要人检查什么?
检查条目是否覆盖真实问题、是否有来源依据、是否偏爱某种表达,以及能否识别故意构造的错误报告。自动化不消除评价目标本身的风险。
接下来把研究与代码、界面串起来:Agent 产出一张图,为什么运行成功、数值正确和最终可用仍是三件事?