让 Agent 在真实网站反复练习,为什么很难得到可信的训练结果?
上一节判断一次操作是否完成。现在想比较两个 Agent,或让一个 Agent 练习一千次“把一只蓝杯加入购物车”。如果第一轮结束后购物车里还留着一件,第二轮就不是同一道题了。本课关注环境初始状态、任务和验证器如何配套,不展开大规模强化学习调度。
第二次比第一次快,可能只是起点变了
设任务是“购物车最终有一只蓝杯”。第一次从 0 开始,需要加一件;第二次若沿用上一轮结果,起点已经是 1,直接停止也能得分。若任务实际要求“在原有数量上再加一只”,最终数量则应该是 2。文字看起来接近,但状态目标完全不同。
比较 Agent A 与 B 时,A 从空购物车开始,B 从已有一件开始,看到 B 少一次点击就说它更聪明是没有根据的。教学例子中 A 做一次加购、B 不做动作,两者都达到数量 1;这只能说明它们面对不同起点。要比较策略,需要固定起点、任务含义、可用工具与时间预算。
重置要恢复业务世界
清空聊天记录,只会让模型忘记,不会把数据库中的购物车清空。刷新浏览器,也可能只是重新显示已经改变的服务端状态。可重置环境必须明确恢复哪些内容:商品库存、用户账户、购物车、登录状态、历史订单,以及可能影响结果的时间或随机种子。
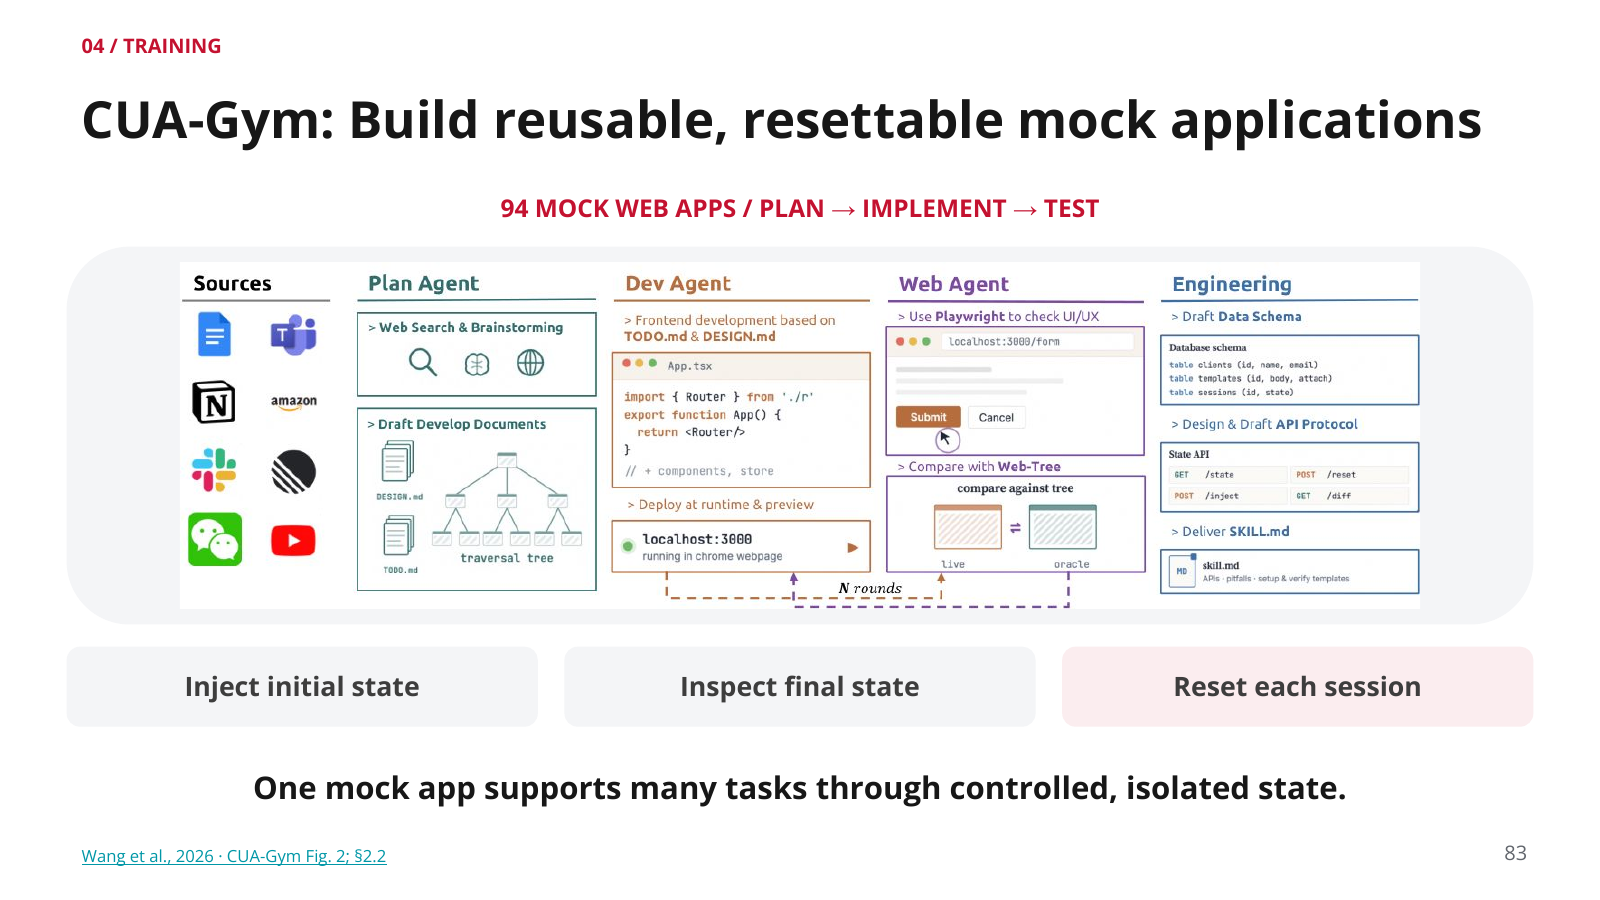
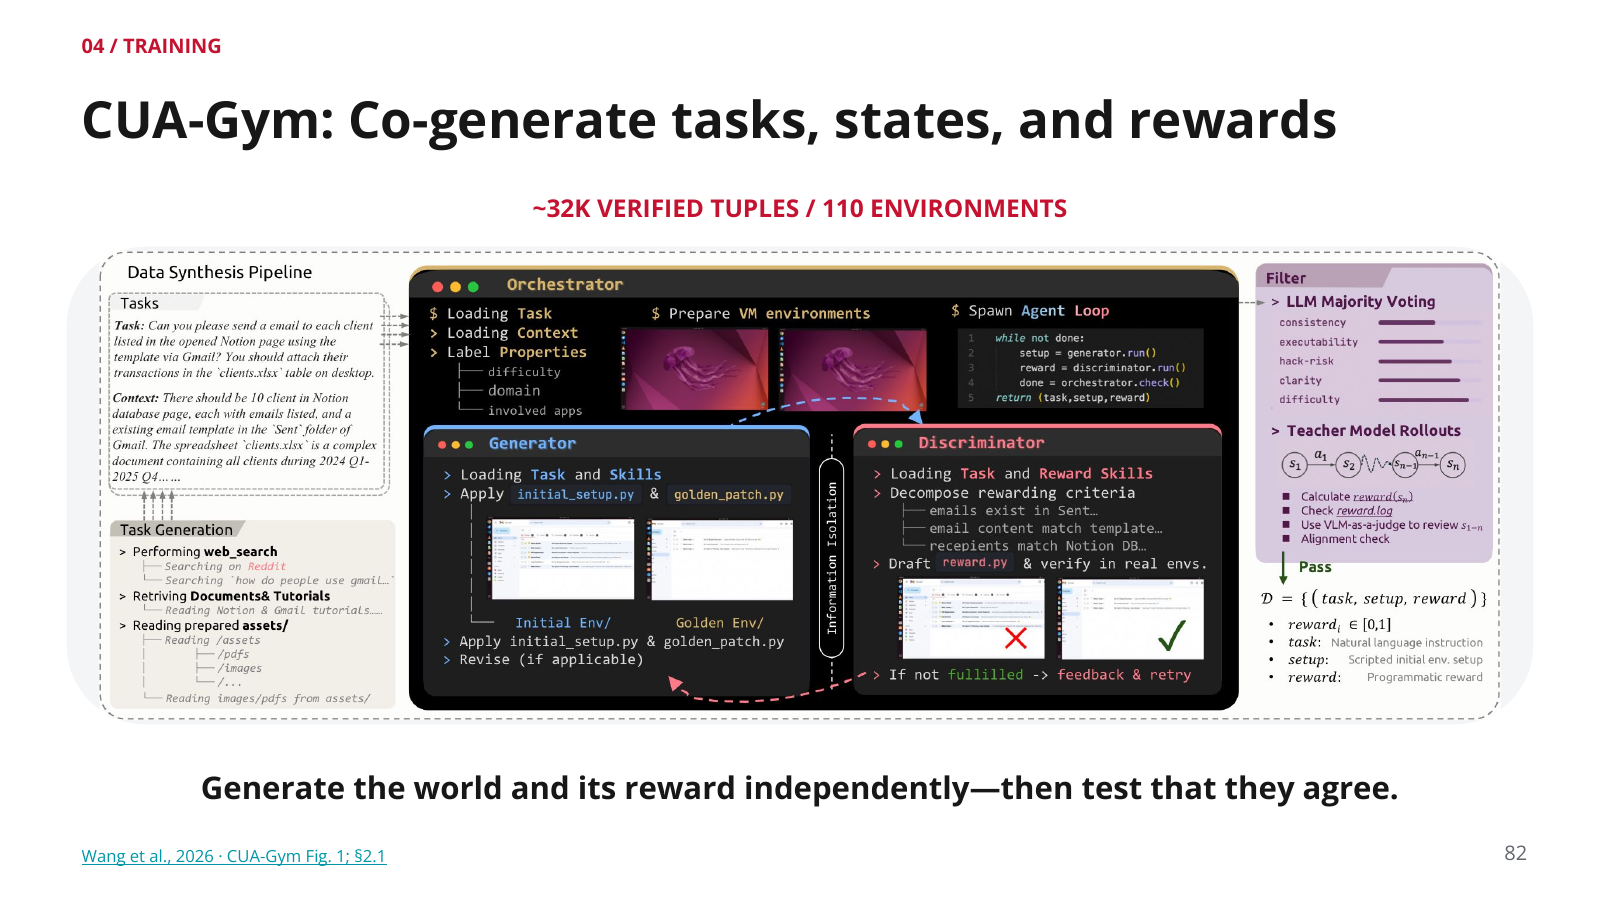
可以把一个训练实例写成三件套:任务指令、初始状态、结果判定函数。我们的例子是“购物车最终一只蓝杯”;初始状态为空;验证器检查商品标识、数量 1,并确保没有额外商品。另一个实例是“再加一只蓝杯”;初始数量为 1;验证器目标数量应为 2。任务生成器与判定器必须对同一个词义达成一致。
验证器自己也需要测试
一个只检查“购物车非空”的验证器,会把红杯、两只蓝杯都判成功。一个检查“出现成功提示”的验证器,可能被旧提示或无关操作欺骗。应为验证器准备正例和故意破坏一个条件的反例:正确蓝杯 1 件应通过;蓝杯 2 件、红杯 1 件、空车都应失败。
重复题目,还是重复了答案
先观察第二轮起点,再判断两轮得分能不能直接比较。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
连续两轮目标都是最终蓝杯数量 1
- 1. 第一轮
空车加一件,数量 1,通过。
- 2. 第二轮起点
沿用数量 1,Agent 没有做动作。
- 3. 结果判定
数量仍为 1,验证器再次通过。
空车加一件,数量 1,通过。
先预测,再核对结果与原因
第二次通过不能证明它会从空车完成任务。环境残留替代了策略的工作。
对照只改变是否重置起始购物车。先判断第二次直接停止的 1 分有多少能说明策略能力,再查看为什么固定起点后它会失败。这里的得分由明确状态规则计算,不是任何模型的实测成绩。
为什么不直接在真实网站练
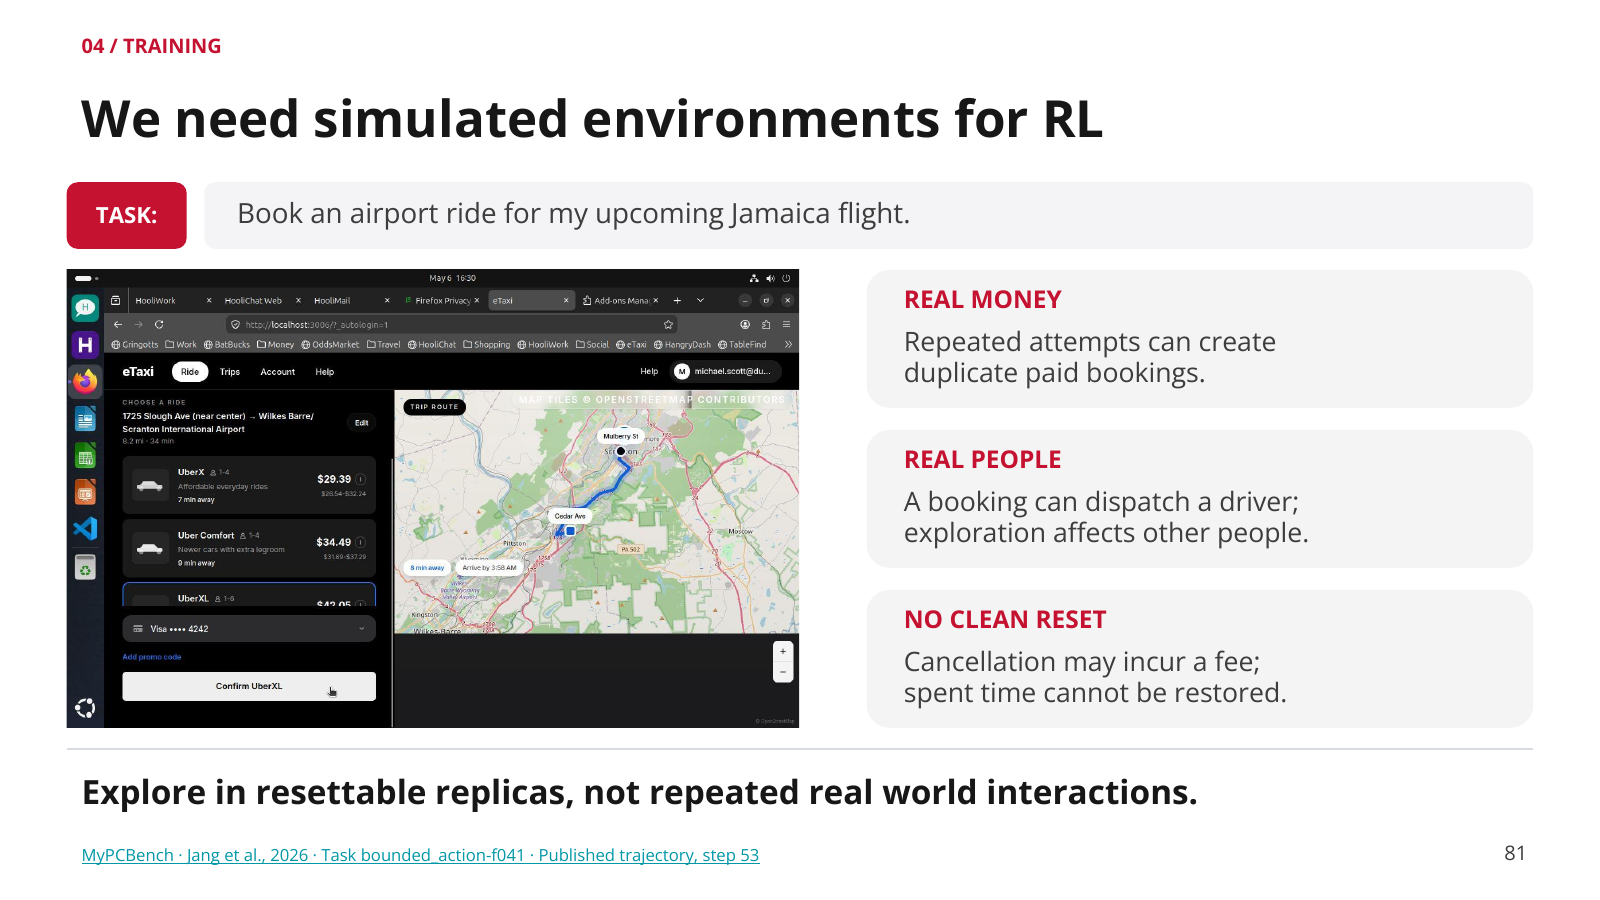
真实网站可能发生库存变化、用户数据积累、接口限流和不可恢复动作。原课的机场接送例子更明确:反复下单会花真钱、影响司机,取消也不能恢复已经消耗的时间。无法重置不仅有实际成本,也使不同训练轮次无法比较。
但模拟器也可能太简单。若模拟网站所有按钮都立即响应,而真实网站存在延迟,训练出来的策略可能错误重试;若模拟验证器直接泄露目标字段,模型可能走捷径。需要引入与目标部署场景有关的变化,并在隔离的测试任务中检查迁移能力。不要把模拟任务通过率直接当作真实网站成功率。
什么该固定,什么该随机
用于公平对比的一组运行,要固定同一任务与初始状态,让 A、B 对应比较;用于训练泛化的任务集合,则应该有不同布局、不同起点与不同目标。二者不矛盾:集合内可以多样,每对比较仍应面对同一个实例。变化要记录下来,才知道失败来自模型还是题目难度。
决策时先定义最小可重置边界,再决定是否需要模拟整个应用。验收要求重复恢复初始状态后得到相同关键字段,成功与反例验证器均能正确判断,并且不同会话状态隔离。环境故障要单独记账,不能直接算成模型不会做;但也不能只删掉新版本失败的运行。
可重复训练需要的不只是重复指令,而是重复同一个起点和成功规则。 这是实验设计的要求;模拟到真实的差距有多大仍需实测。
理解题 1:清空消息历史后,能假定购物车也空了吗?
不能。模型上下文与环境业务状态是两个对象。必须通过环境重置或状态注入恢复购物车,再验证起点。
理解题 2:“最终一只”与“再加一只”能共用同一个固定数量验证器吗?
不能一概共用。前者目标固定为 1,后者目标依赖初始数量。初始为 1 时,后者应检查最终为 2。
理解题 3:训练任务都固定同一初始状态,是否更容易保证公平?
单次比较更可控,但训练覆盖太窄。应区分比较配对与任务多样性:对每个实例固定起点,跨实例保留需要泛化的变化。
代码和界面任务能检查最终状态;研究任务要产出一篇有依据的结论。下一节开始问:搜到几篇网页,为什么还不等于完成研究?