会补全一段函数的模型,为什么还不会修一个仓库?
上一课已经走完“找到错误—修改代码—检查新旧行为”。现在把这条过程交给一个刚学会代码补全的模型:它可能准确写出 return 3 if value is None else value,却不知道先去哪个文件找 value。本课关心训练目标怎样从一段代码扩展到一串行动;先不展开优化器和训练集群。
同一句正确代码,放错位置仍然没用
继续使用原课的重试次数任务。仓库有入口 cli.py、配置解析 config.py、测试 test_config.py。补全题给模型一个几乎写完的函数,它只需补空缺;仓库任务只给用户现象“设置 0 后仍重试三次”,模型还要获得缺失信息。
把答案代码直接接在入口文件末尾,可能没有任何调用者执行它。假设我们把教学验收拆成三个必须满足的条件:修改实际调用的配置函数、保留显式 0、通过默认值回归。仅在一个未使用文件写出正确函数,只满足“文字里出现了正确表达式”,三个行为条件都没有被证明。代码看起来正确与任务真的修好之间,缺的是行动与环境之间的对应关系。
补全先教什么,为什么还不够
普通自回归训练预测下一个 token,能从大量代码里学到语法、常见 API 和局部模式。填空训练进一步把后缀也放进上下文:模型要补的函数体既接得上前缀,也兼容后面的调用。原课的 [M0] 是缺口标记,不能把它误当业务代码。
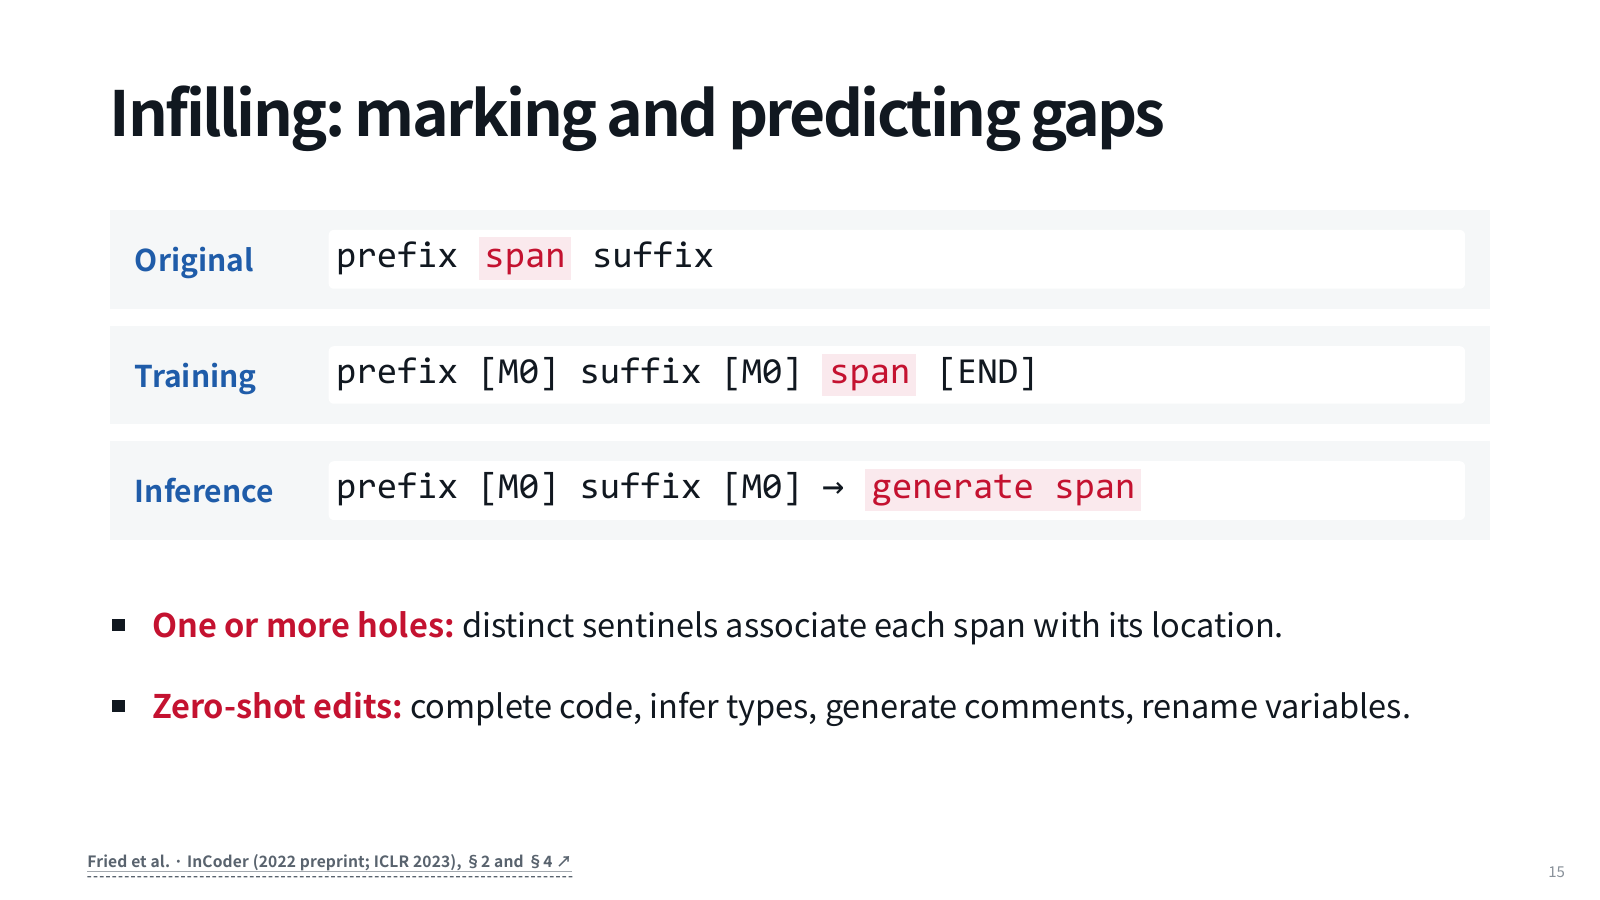
例如前缀是 def retry_count(config):,后缀是“调用者要求结果为整数”。补全模型可以借助两侧限制写函数体。但文件路径、调用关系、环境依赖不自动出现在上下文里。增加代码语料可能提高推测质量,不能保证把仓库状态实时传给模型。运行时仍须有读文件、搜索、编辑、测试接口。
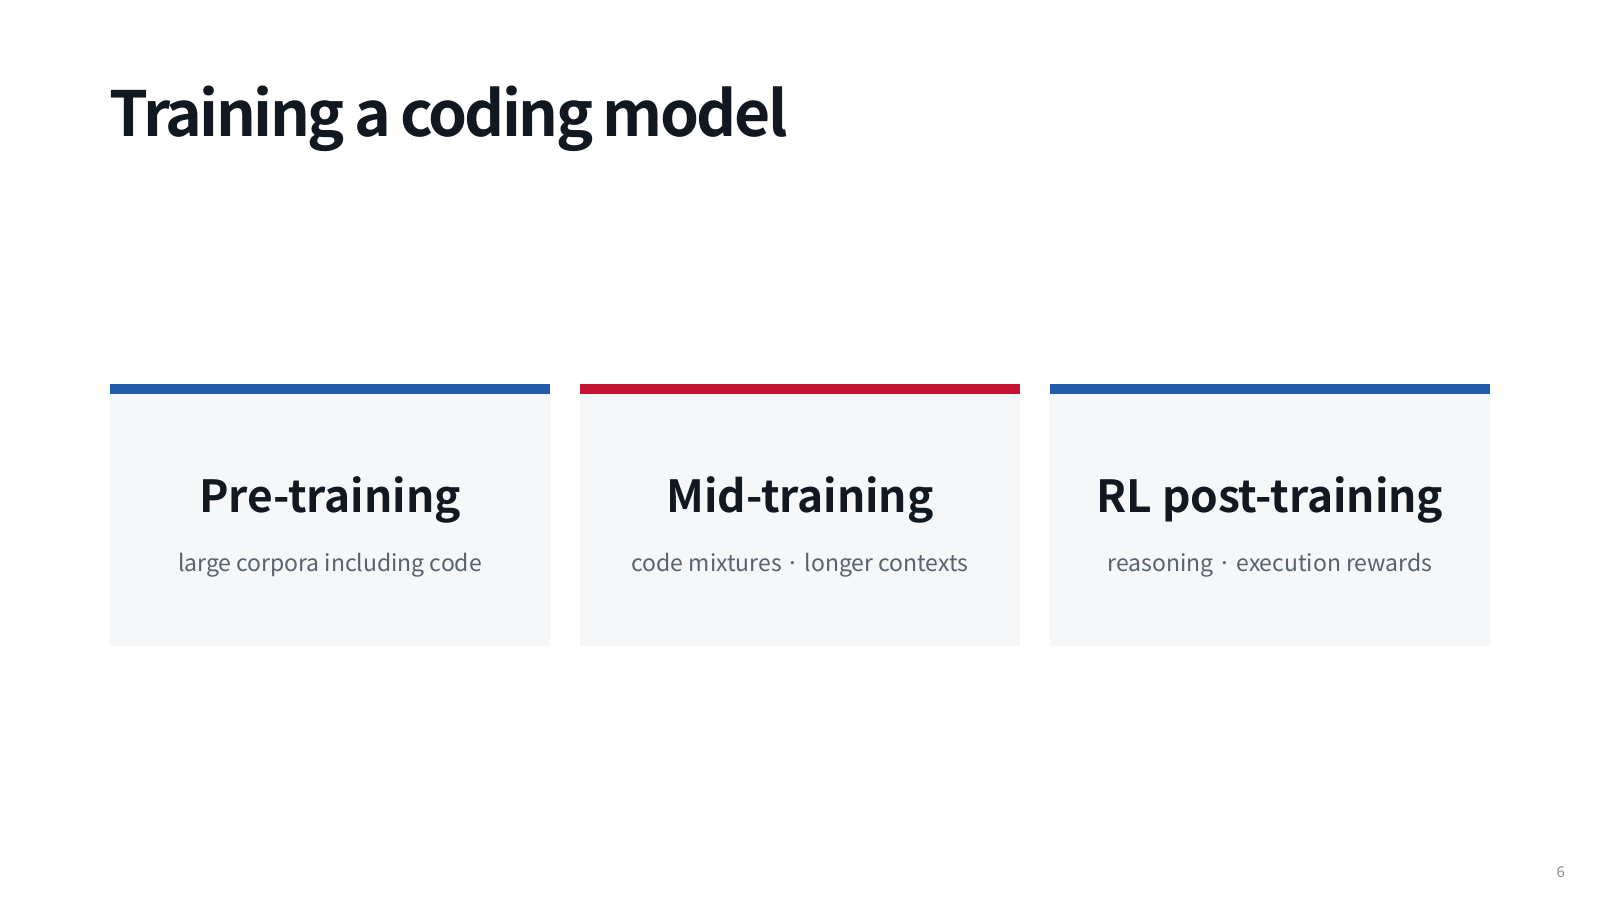
原课把代码模型训练分为预训练、中期训练和强化学习后训练。这个分类描述不同阶段常见的数据与目标,不意味着每个模型都严格执行相同配方;也不能从阶段名称推算其修复成功率。
多步示范教模型在何时做什么
一个仓库修复示范不是只有最终补丁。它包含用户问题、助手搜索动作、工具返回的路径、助手读取代码、环境给出的文件内容、助手编辑、执行结果、助手测试与结论。模型每次选择动作时所见的输入,都由之前这条轨迹决定。
监督微调可以让模型模仿示范中的助手行动:看到错误描述时先搜索;看到 or 3 与失败测试时改判断条件;看到补丁应用成功时继续测试。工具返回内容通常作为上下文,不应被当成模型必须编造的输出。我们将在第 39 节把这个区别落实到 loss mask。
补全答案与修复过程差在哪里
保持用户目标不变,比较模型拥有的信息和最终证据。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
同一用户任务:显式 0 必须保留
- 1. 输入不足
模型只得到函数名,没有仓库路径和调用链。
- 2. 生成表达式
写出正确 None 判断,但未应用到实际配置函数。
- 3. 检查证据
没有编辑结果,也没有测试输出。
模型只得到函数名,没有仓库路径和调用链。
先预测,再核对结果与原因
得到一个候选答案,尚未完成仓库任务。局部代码正确不证明程序会执行它。
先预测再回放:三个方案都可能生成同一句修复代码,为什么只有最后一个展示了完整的修复依据?组件中的步骤是固定教学案例,不是模型训练或性能实测。
强化学习增加反馈,但不会消除归因难题
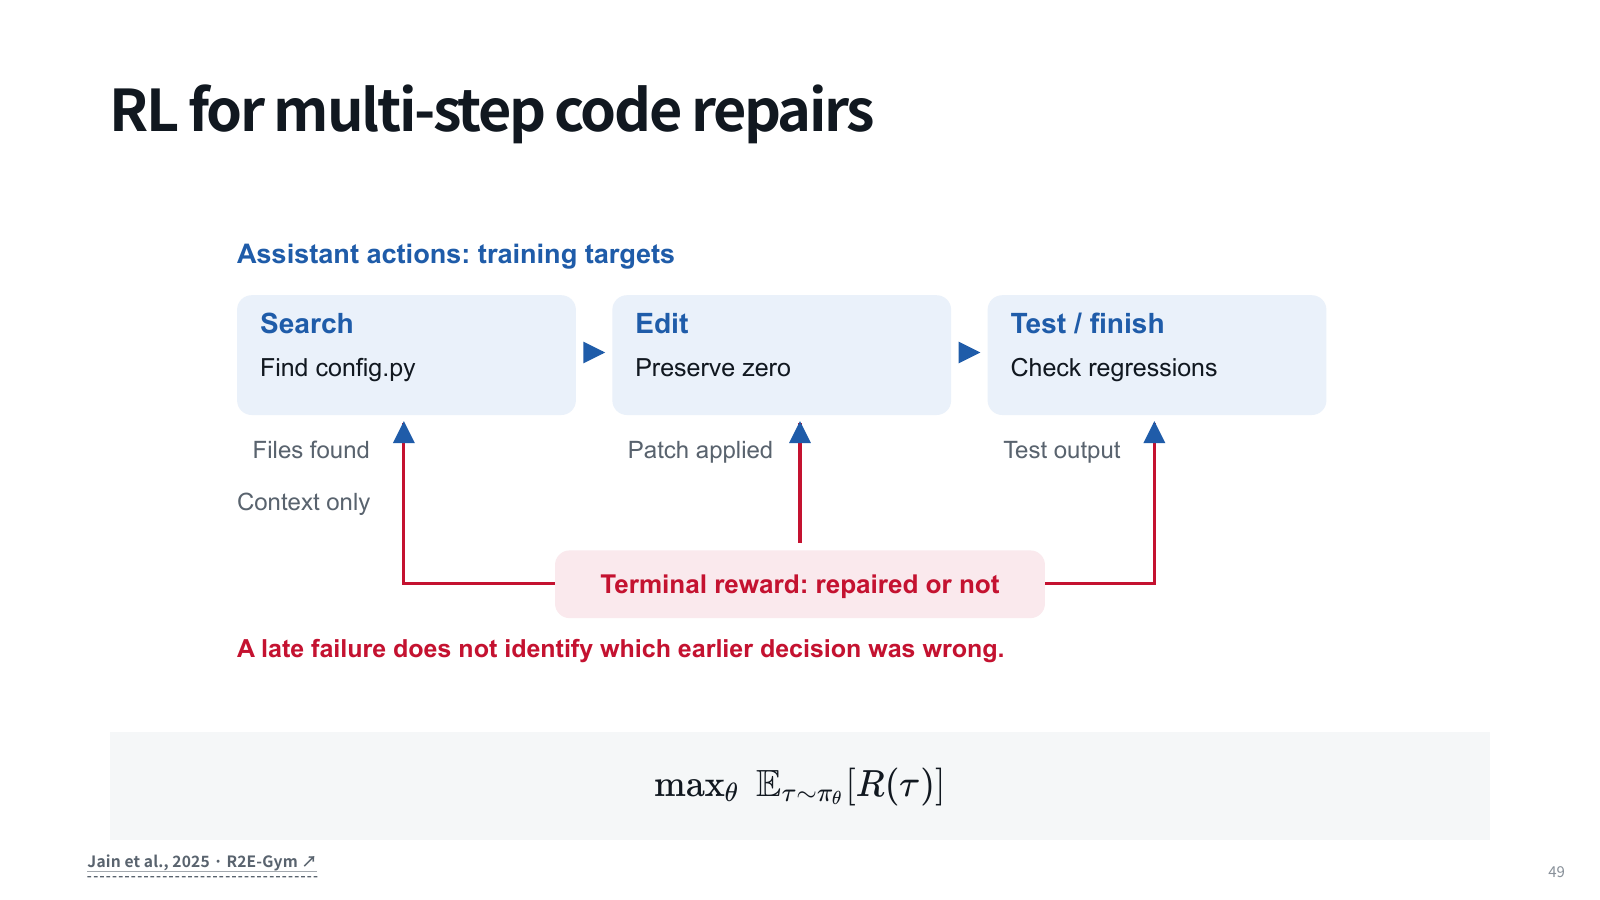
监督示范告诉模型“这个上下文里,老师做了什么”。强化学习让模型在环境中尝试,再依据任务结果调整行动倾向。对我们的任务,可以在隔离仓库里运行测试,把修复成功且回归通过作为结果信号。
难点是奖励到得晚。路径找错了,后面可能写出漂亮补丁却仍失败;路径正确但只返回 0,也失败。如果两条轨迹最后都是 0 分,单看终值分不清错误发生在哪里。需要多次尝试、足够多样的任务,以及保留中间轨迹用于分析。把每个动作都设置为“越少越好”也会制造另一种错误:模型可能为了节省一步而跳过测试。
反过来,任务若明确给出唯一文件和精确缺口,补全就可能足够。我们不应为一个静态填空题强行引入十次工具调用。行动训练解决的是需要与环境交互的信息缺口,不是为了让输出显得复杂。
怎样判断训练方案对不对
要拍板的是训练样本中的“工作单位”:一段答案,还是从问题到验收的完整过程;奖励依据是可执行行为,还是回答形式。验收时保留没在训练中见过的仓库与错误类型,并分别统计定位失败、编辑失败、执行环境失败,防止同一个仓库中的近似题泄漏到测试集。
补全训练教怎样续写代码,Agent 训练还要教怎样取得证据、改变环境、判断结束。 这个区分是机制解释,具体训练配比和收益须由实验决定,原课没有给所有模型通用的最佳比例。
理解题 1:给模型更长上下文,是否就不需要搜索训练?
不一定。上下文窗口只是容量;哪些文件被放进去仍要选择。小仓库可以整体提供,大仓库还需要有效定位,否则相关代码可能从未进入输入。
理解题 2:工具说“补丁应用成功”,能给修复成功奖励吗?
不能直接等同。它只证明编辑操作执行成功,行为是否修好要运行适当测试。把两种成功混用会奖励写入动作而不是解决问题。
理解题 3:终端奖励是 0,能断言最后一步测试动作错了吗?
不能。测试可能正确揭示了更早的错误。末端信号与造成失败的行动不是同一个位置,保留整条轨迹才能继续诊断。
代码任务里的观察通常是文本文件。下一节换成浏览器:当观察变成截图,模型怎样知道该点哪个位置?