新测试通过了,为什么还不能说 bug 修好了?
上一课确认补丁只改变了目标范围。现在新增的“零次重试”测试变绿,Agent 准备宣布成功。先停一下:我们的约定不只有零这个输入,还包括缺省、None 和正数。本课把验收拆成可观察的几层,解释每层能排除什么,以及为什么它们不能互相替代。
一个通过测试的错误修复
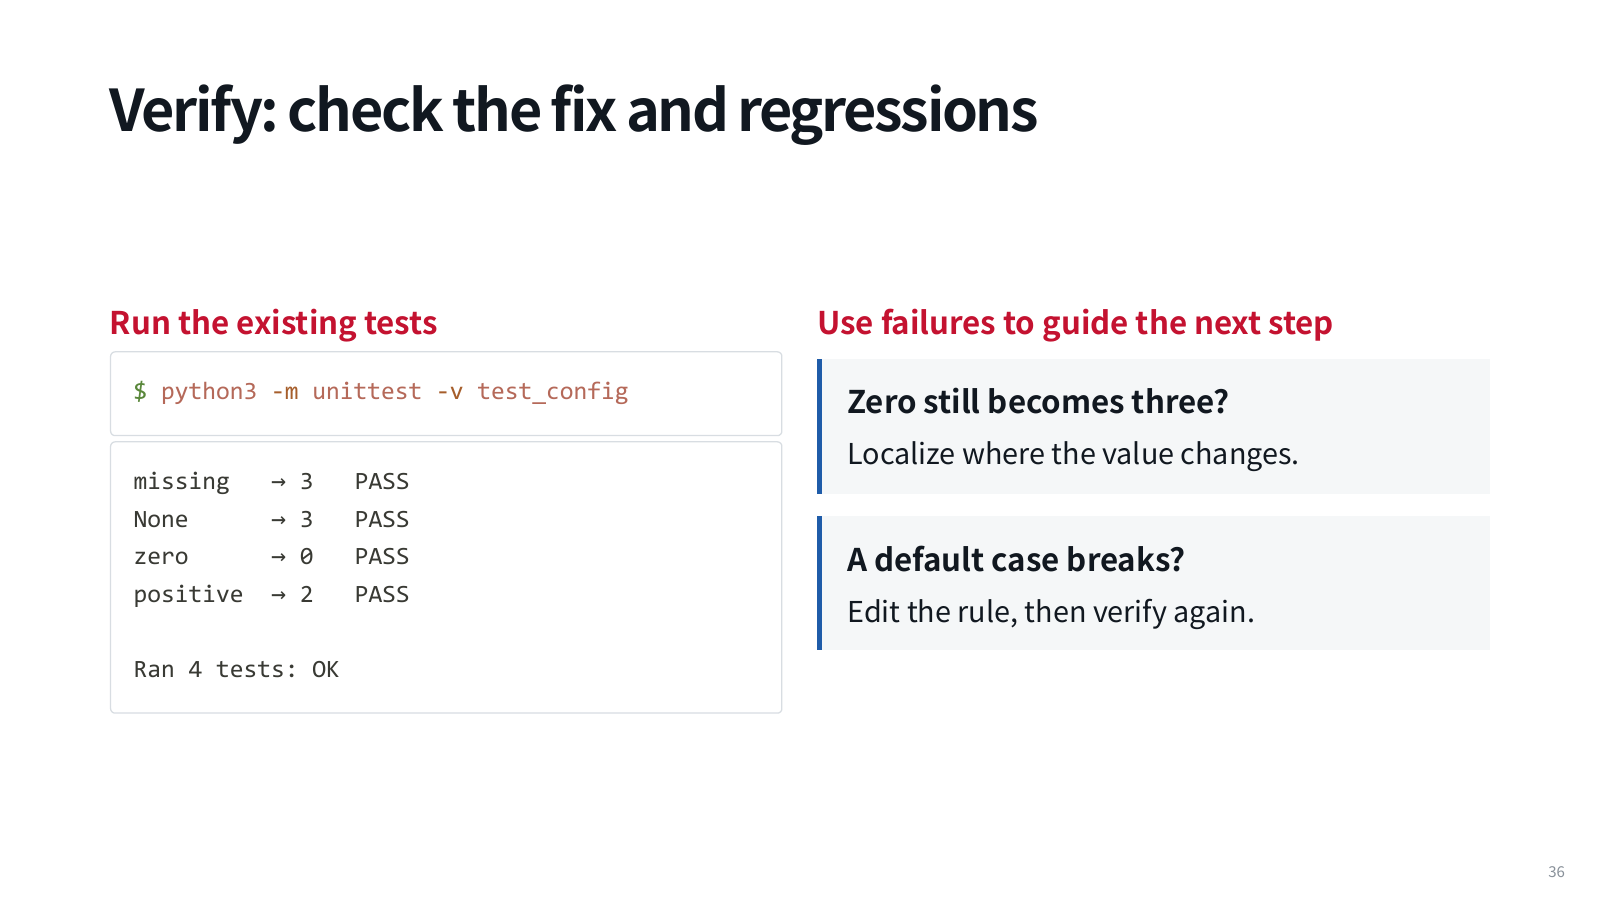
设修复前函数错误地把 0 当成缺失,返回 3。新增测试要求输入 0 时输出 0。Agent 把函数改成 return 0,新测试当然通过。但输入 2 也输出 0,缺少配置也输出 0。一个绿勾只证明当前被检查的断言成立;它不会自动证明没有写进断言的行为。
把四项要求列成账本:缺少配置应为 3,None 应为 3,0 应为 0,2 应为 2。恒定返回零只有一项正确,比例为 1/4;针对 None 的默认规则四项都正确。这里的 25% 和 100% 只是这个四例教学集合的通过比例,不是模型总体能力,更不是现实系统可靠性的概率。
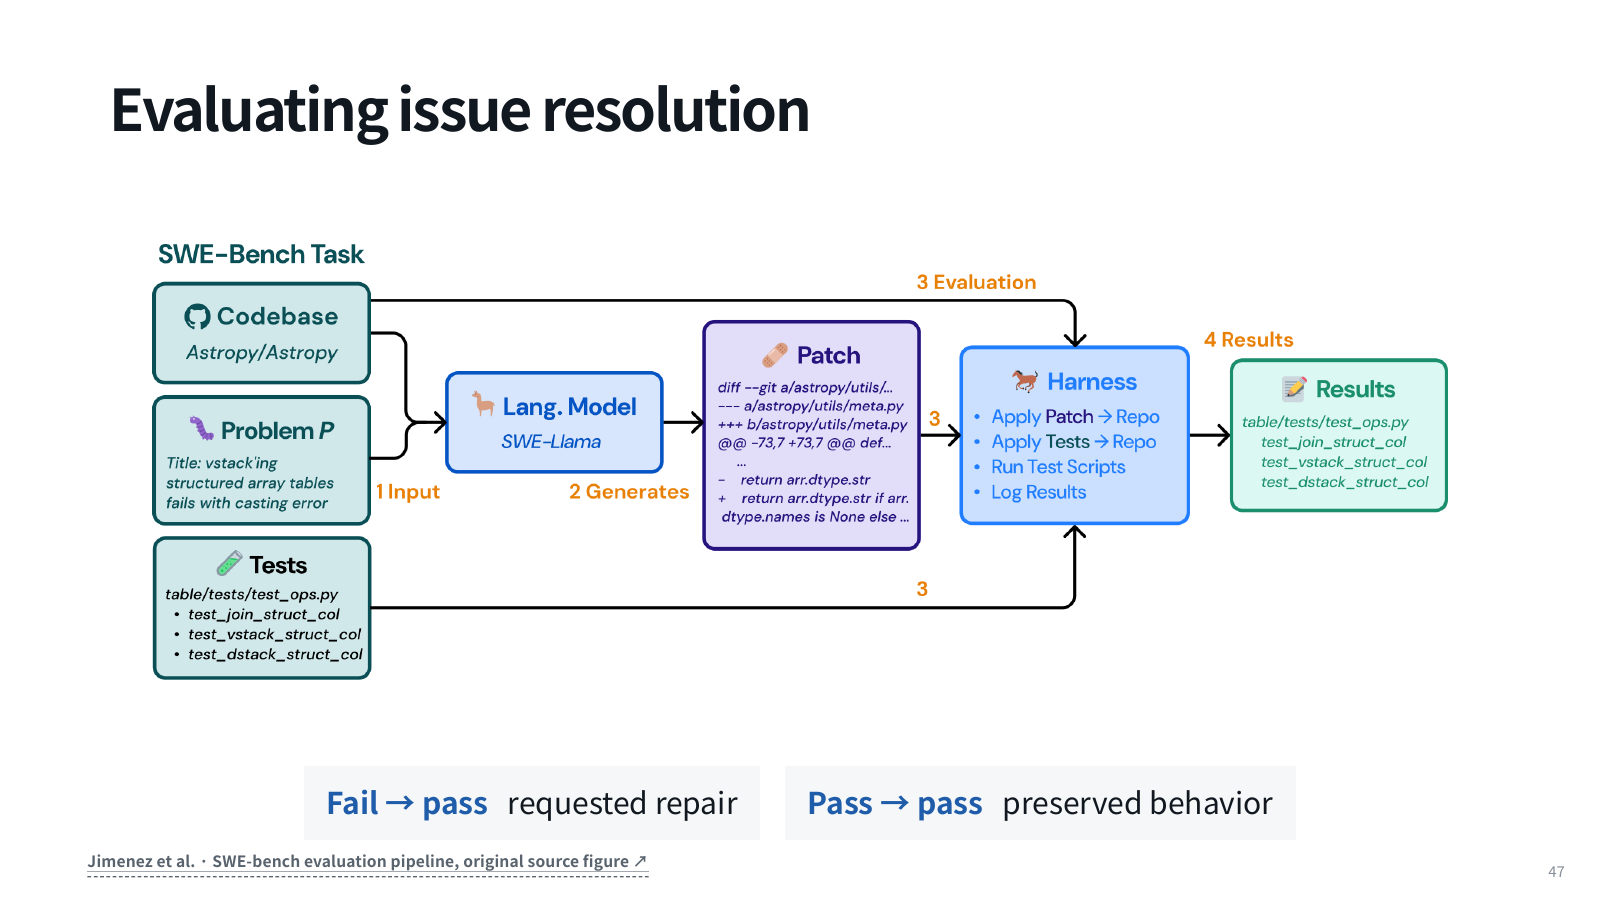
Fail-to-pass 与 pass-to-pass 检查不同事情
Fail-to-pass 指原来因目标缺陷失败、现在应通过的检查。它回答“请求修的行为改变了吗”。Pass-to-pass 指原来已经正确、现在仍应正确的检查。它回答“修复是否破坏了已知行为”。这两类名字是对测试在修复前后状态的描述,不是两套互斥的测试框架。
如果新测试在未修改实现时已经通过,就不能证明它复现了本次缺陷。先观察失败,再应用修复,最后观察通过,才能把证据与改动联系起来。同时,原有测试应在相同依赖和环境下重新运行;只引用昨天的绿灯,不能证明今天的新代码没有回归。
把三种候选修复放到同一组检查里
下面按固定规则计算四项输出,不执行真实测试框架。先预测“只返回零”会丢掉哪三项,再看正确的默认规则。第三个场景只改变测试范围,展示为什么同一个错误实现可以得到完全不同的验收印象。
同一修复,四项行为分别怎样?
不要只看通过率,先看被检查的输入集合。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
四项期望:缺失3、None3、零0、正数2
- 1. 定位判断
默认只适用于None。
- 2. 执行四个小输入
分别得到3、3、0、2。
- 3. 比较前后
零值Fail→pass,其余三个Pass→pass。
默认只适用于None。
先预测,再核对结果与原因
4/4通过。目标修复和已知行为保持同时成立。
代码正确之外,界面也有验收对象
如果修的是表单,单元测试可能证明空白姓名被拒绝,但用户仍看不到错误提示。再假设提示文字白色、背景也白色,DOM 中虽然存在“姓名不能为空”,屏幕上的使用者却无从得知如何继续。这不是装饰问题,而是交互结果没有传达给用户。需要在浏览器里真实操作,并查看提示位置、对比和布局。
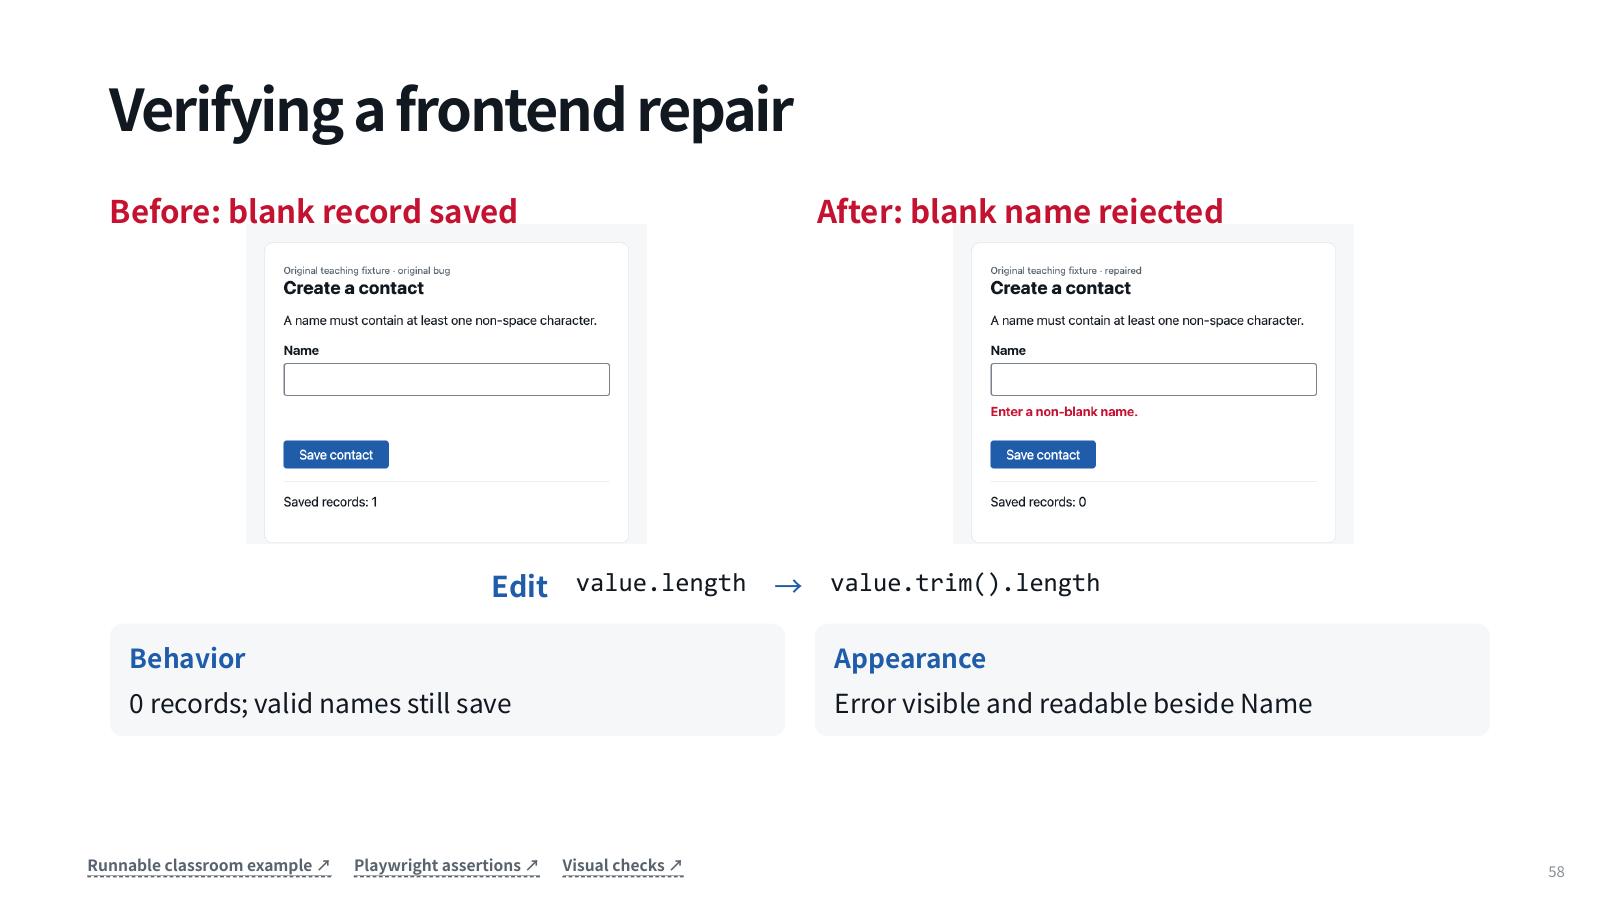
再改变一个条件:为了拒绝空格,把所有含空格的姓名都拒绝。纯空格测试通过,但“Li Ming”也不能保存。这个反例提醒我们,边界测试既要覆盖无效输入,也要覆盖紧邻边界的合法输入。性能、安全、兼容性等要求同样需要独立判据,不能因为功能测试绿了就默认为满足。
一个适度的验收范围应由改动影响面决定。修改一个默认值,无需无理由重跑所有昂贵任务;但修改共享解析器,就应该检查主要调用者。先做最小复现,再做相关回归与必要的端到端观察,证据充分后停止。无限增加测试也会消耗时间,重点是每项检查是否回应一个具体风险或未确定的行为。
你会接受哪份修复报告?
“新增测试通过”能支持什么结论?
支持新增断言在当前环境和代码下成立。若未证明修复前失败,连目标缺陷是否被测试捕获都还不确定;它也不支持未检查的旧行为、外观和性能结论。
四项测试全过,能否说任何输入都正确?
不能。有限样本排除的是这些样本暴露的问题。仍需按函数契约考虑负数、错误类型等是否属于合法输入或应被拒绝,不能把四例通过外推成完整证明。
截图里错误提示可见,为什么还要点一次提交?
截图可能只是静态样式,也可能未反映保存行为。实际提交后观察记录数量、网络或应用状态,才能验证错误路径真的阻止保存,且合法路径仍可完成。
修复可信度来自相互补充的证据,而不是绿勾的数量。下一课从运行过程转向训练:模型怎样从会补一段代码,变成会走完这种修复闭环?