截图里看得见按钮,为什么模型仍可能点错?
前面代码 Agent 用路径找到文件,用行文定位表达式。浏览器 Agent 也必须把“用户想做什么”落到可执行目标上,只是目标变成页面元素。这个对应过程叫 grounding:把语言中的对象和界面中的具体对象对齐。本课先讲截图、结构与动作的关系,不讨论视觉模型内部的像素编码。
先认出目标,再决定动作
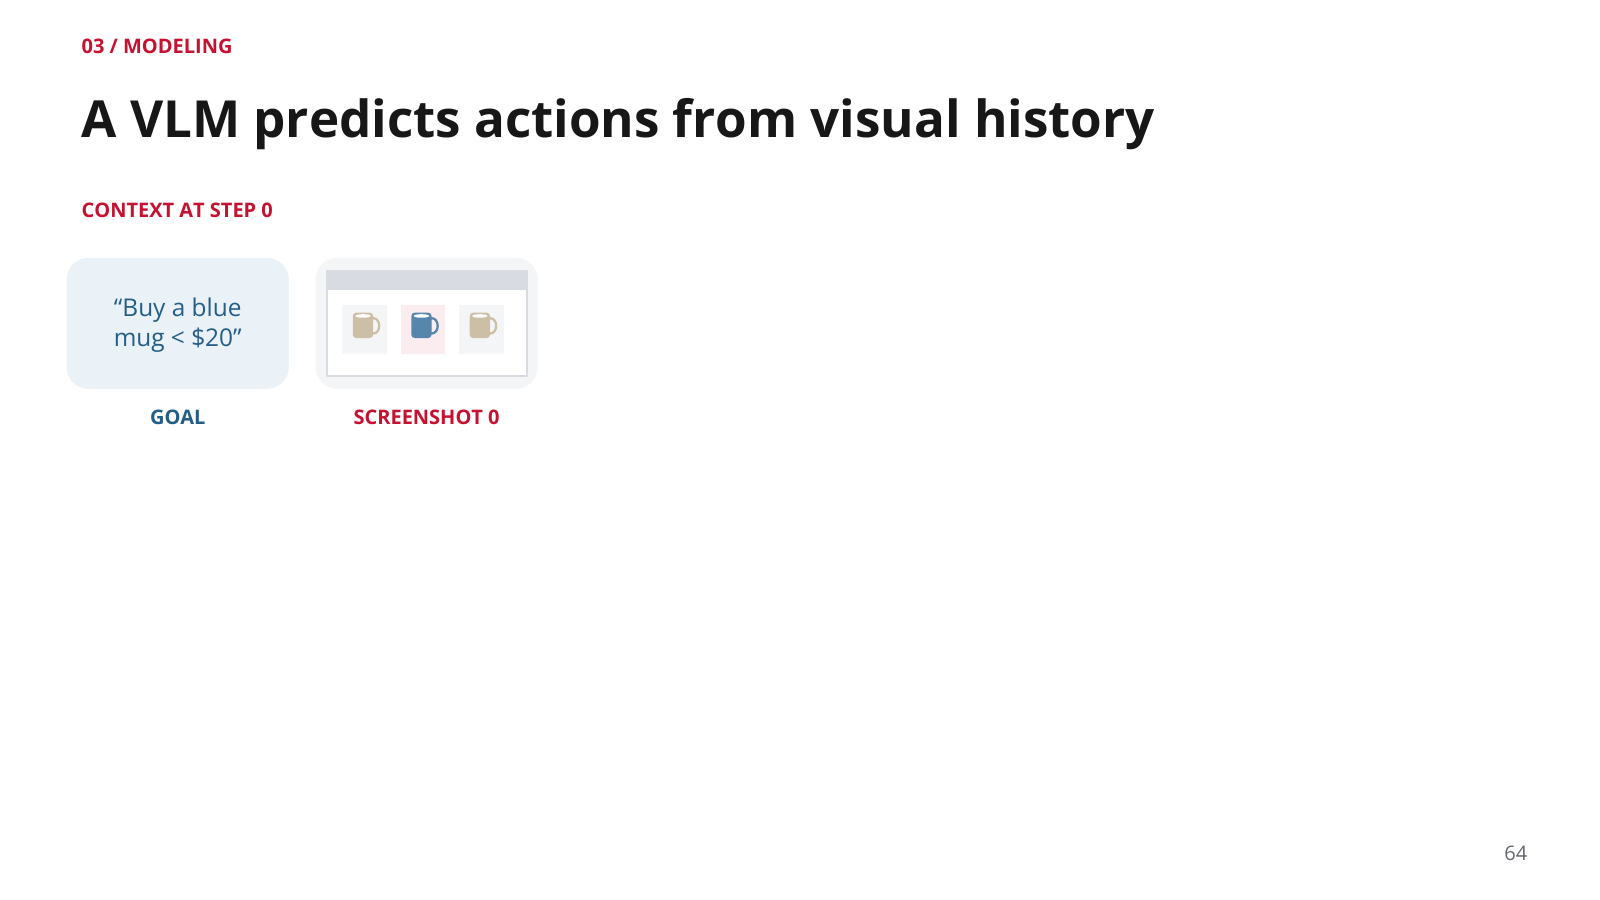
原课给的购物目标是购买低于 20 美元的蓝色杯子。画面里有奶油色杯 16 美元、蓝色杯 18 美元、蓝色套装 28 美元。“蓝色”只能排除奶油色;“低于 20 美元”才能排除蓝色套装。正确对象必须同时满足颜色、品类和价格,不能看到 blue 就点。
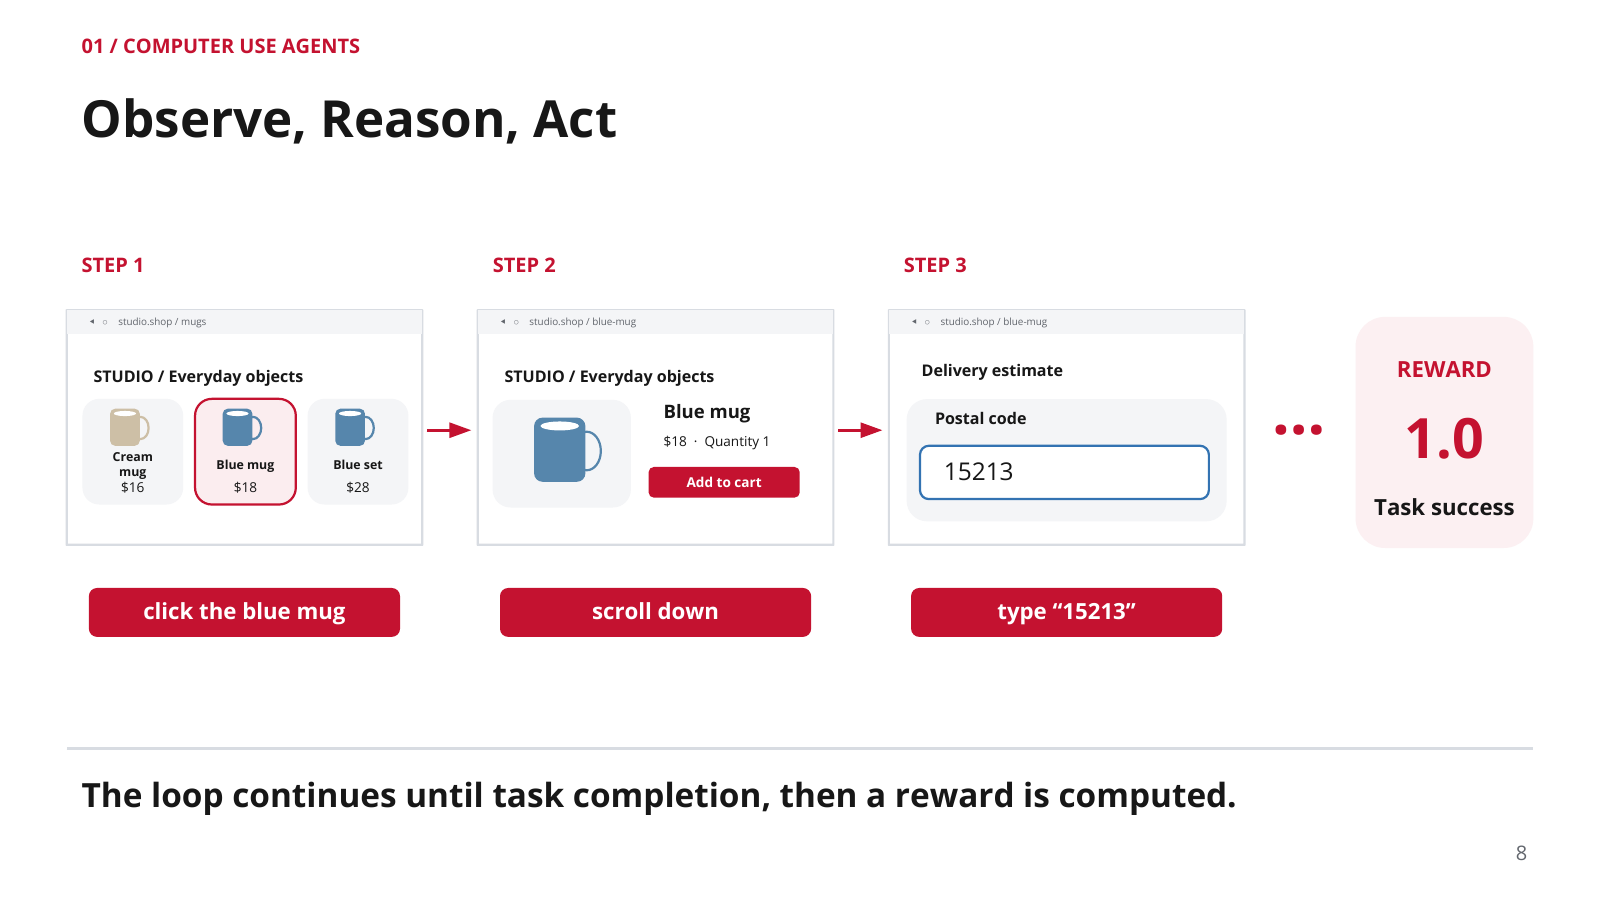
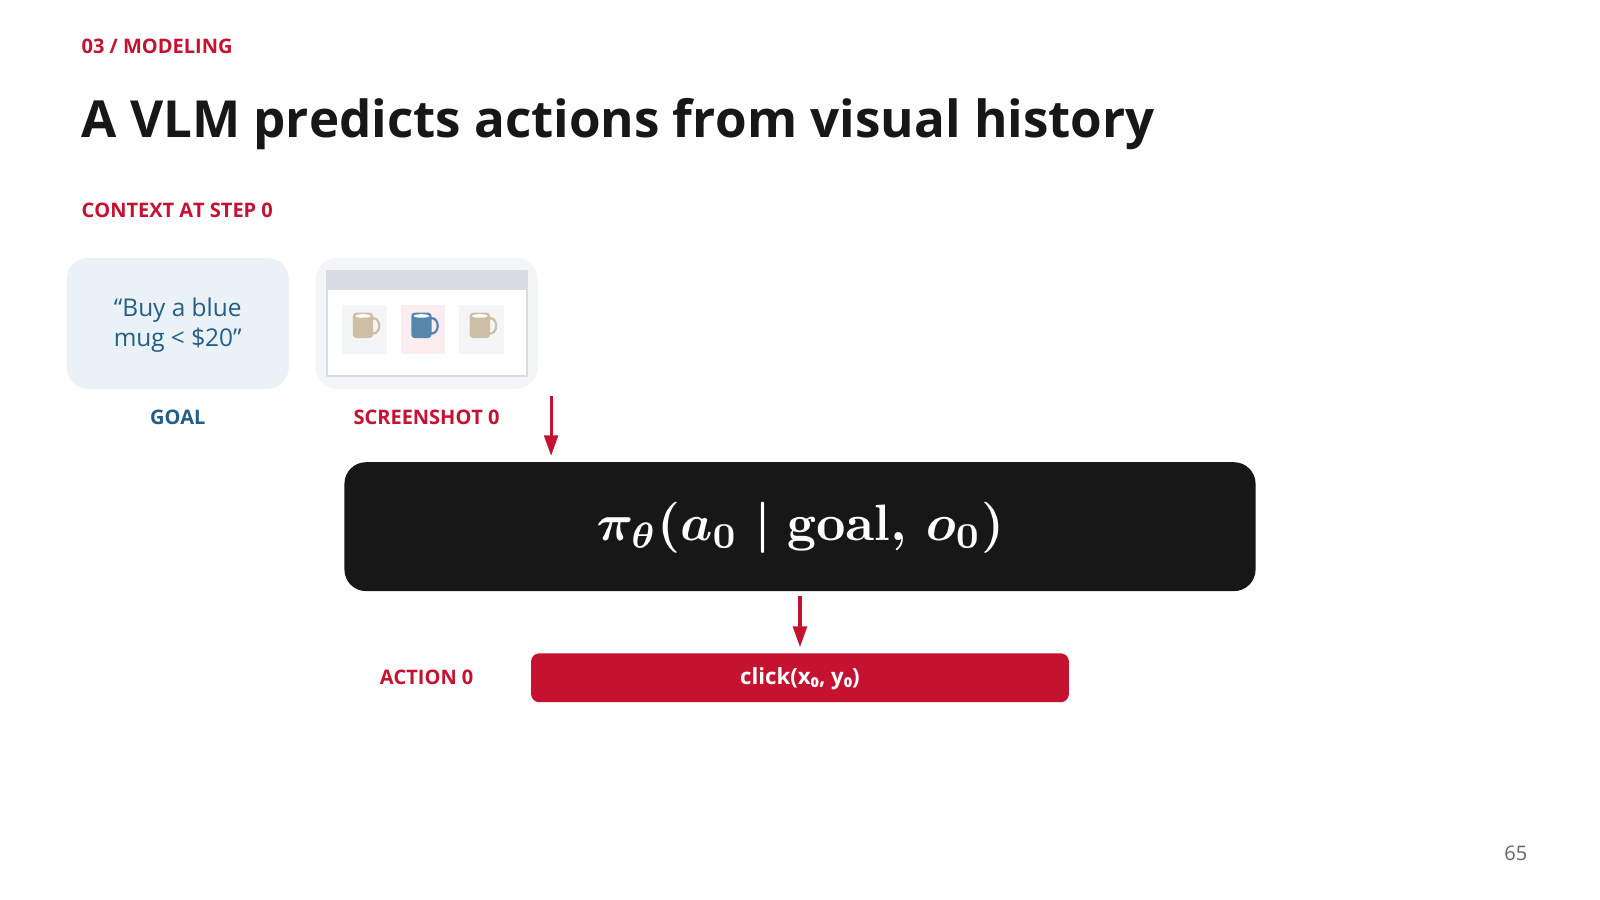
假设一个教学页面把蓝杯按钮画在矩形左上角 (400, 200)、右下角 (600, 280)。选中心得到 x=(400+600)/2=500、y=(200+280)/2=240。坐标计算没错,不代表对象选择就对:如果这个矩形属于套装,精确点击仍会执行错误选择。
为什么旧坐标失效
坐标只对一个具体画面、视口、滚动状态有意义。若页面向上滚动 100 像素,同一个按钮的新矩形变成 (400,100) 到 (600,180),中心是 (500,140)。继续点旧坐标 (500,240),可能落到另一个商品上。这里的数字是按矩形中心与滚动位移手算的教学几何,不是截图实测坐标。
模型不该把目标永久记成一个点。它要保留“蓝色单杯、18 美元”这个语义目标,根据最新观察重新定位,并让执行器知道坐标属于哪个视口或图像尺寸。如果截图缩放到原尺寸一半,图中 250 像素可能对应屏幕 500 像素;混用坐标系会产生系统性偏移。
结构信息为什么有用,又为什么不万能
如果页面提供 DOM 或无障碍树,Agent 可能通过角色、名称、文本和层级找到按钮。比如“商品卡片文本为 Blue mug、价格 18,其内部名为 Add to cart 的按钮”。这种目标能在布局变化时重新定位,通常比持久保存绝对坐标稳健。
但结构中可能有隐藏元素,按钮名字可能都叫“加入购物车”,画布应用可能根本没有丰富的结构。只用可访问名称会命中多个对象;只用 CSS 路径也会被布局重构破坏。截图提供视觉关系,结构提供语义与层级,两者都需要与当前界面核对。原课这里直接展示的是截图驱动动作;DOM 与无障碍树是我们补充的工程对照,不把它冒充成这两页课件的实验结论。
滚动之后还点旧位置吗
先算出新中心,再逐步查看点击是否仍在按钮范围内。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
按钮原中心 (500,240),页面向上滚动 100
- 1. 确定目标
目标仍是同一个蓝色单杯按钮。
- 2. 保留旧点
动作继续使用 (500,240)。
- 3. 核对新位置
新按钮范围 y=100 到 180,240 已在范围外。
目标仍是同一个蓝色单杯按钮。
先预测,再核对结果与原因
点位落在目标之外。对象没变,但坐标依赖的画面变了。
先选择“保持旧坐标”,再换成“重新定位”。两条回放只改变是否更新坐标,目标、滚动距离与按钮尺寸都相同。由此可以定位失败原因是状态过时,而不是算术不会做。
反例:名称正确,仍然不是可执行目标
页面出现两个“确认”按钮,一个在未打开的弹窗模板里,另一个在可见购买对话框里。文本匹配拿到了两个候选,就应继续使用可见性、所在弹窗和当前焦点缩小范围。盲选第一个会把不确定性藏在代码里。
另一个反例是页面尚在加载。截图上有按钮,但被加载遮罩覆盖,坐标落点正确也不会触发目标动作。这时改成点击十次只会增加不确定性。合理的下一步是观察遮罩是否消失、元素是否可交互,并在一次动作后验证状态变化。
选择接口时应看任务与环境:有可靠结构时优先用能表达目标的定位方式;只能看到远程桌面或画布时必须依赖视觉定位;两者都存在时可相互校验。验收要包括缩放、滚动、同名元素和异步加载场景,不能只在固定桌面截图上通过一次。
目标是“哪个对象”,坐标只是它在当前画面上的临时地址。 这个结论来自界面几何与状态关系;某种定位方式的实际成功率仍要在具体环境中测量。
理解题 1:把按钮中心算到小数点后两位,能解决点错商品吗?
不能。目标选错与坐标精度是不同问题。必须先把颜色、品类、价格约束同时映射到同一商品,再求这个对象的位置。
理解题 2:向上滚动 100 像素,旧中心 y=240 应改为多少?
在没有其他布局变化的假设下是 140。若页面同时插入横幅或发生重排,单纯减 100 不再可靠,应重新观察定位。
理解题 3:DOM 中找到了唯一按钮,就能断言它可点击吗?
还不够。它可能隐藏、禁用或被遮挡,需要结合当前可见状态与动作反馈判断。结构定位减少歧义,但不取消环境验证。
找到并点中按钮后,任务为什么还不能算完成?下一节继续追踪点击之后真正发生的状态改变。