本节要解决的事:不必先争论系统是否“足够 Agent”。先指出哪些分支由程序规定,哪些选择由模型根据新观察作出。
一封账单邮件经过五个位置
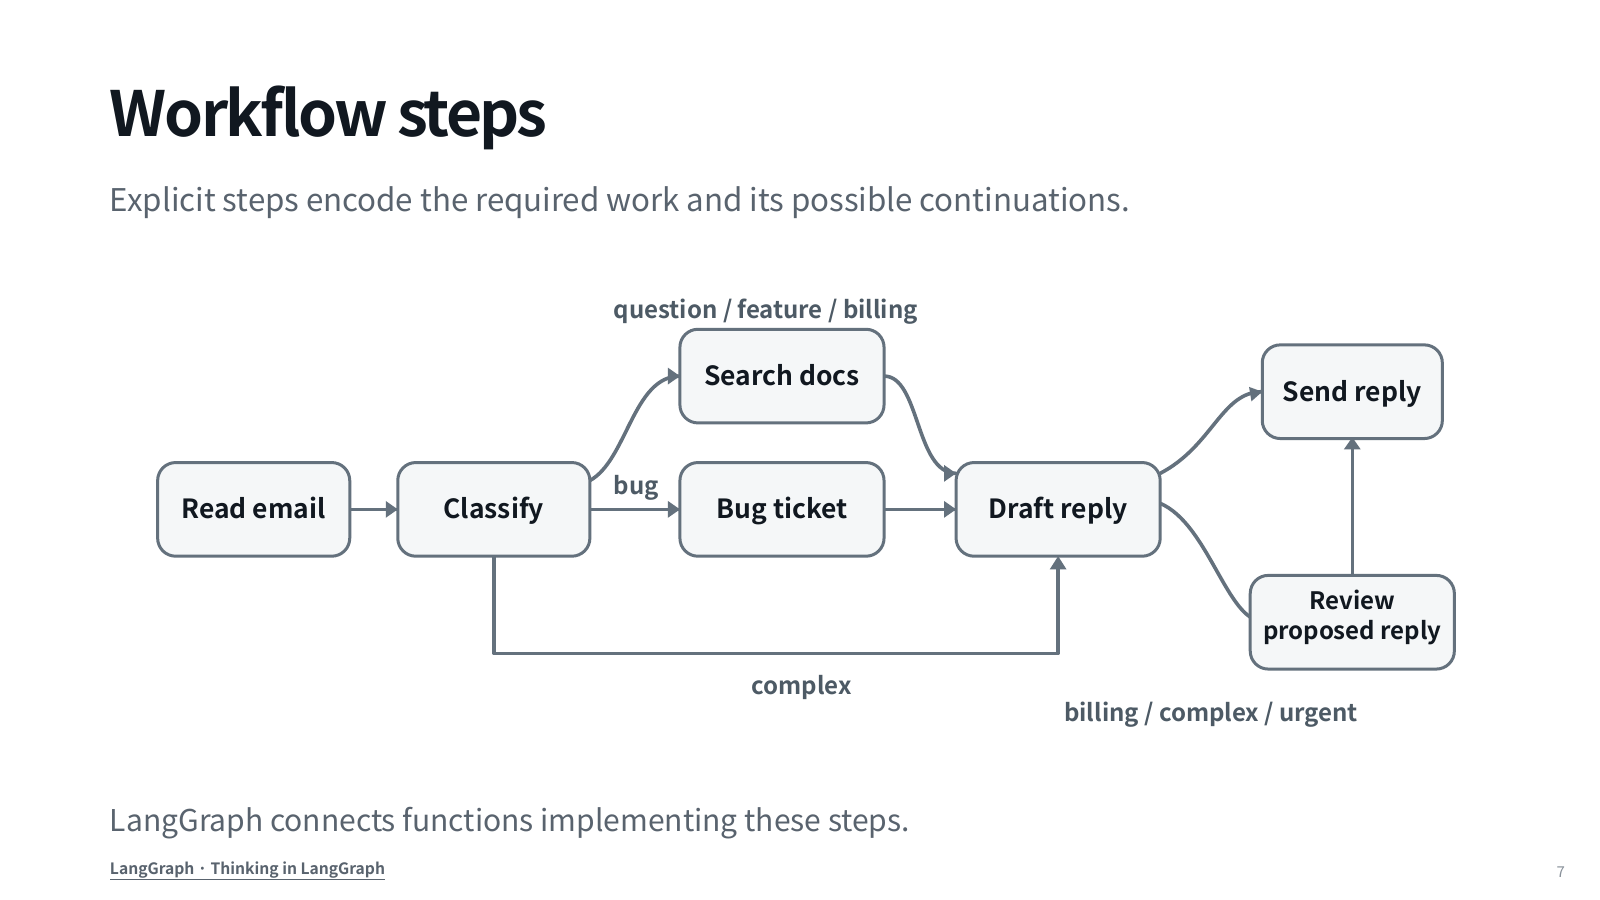
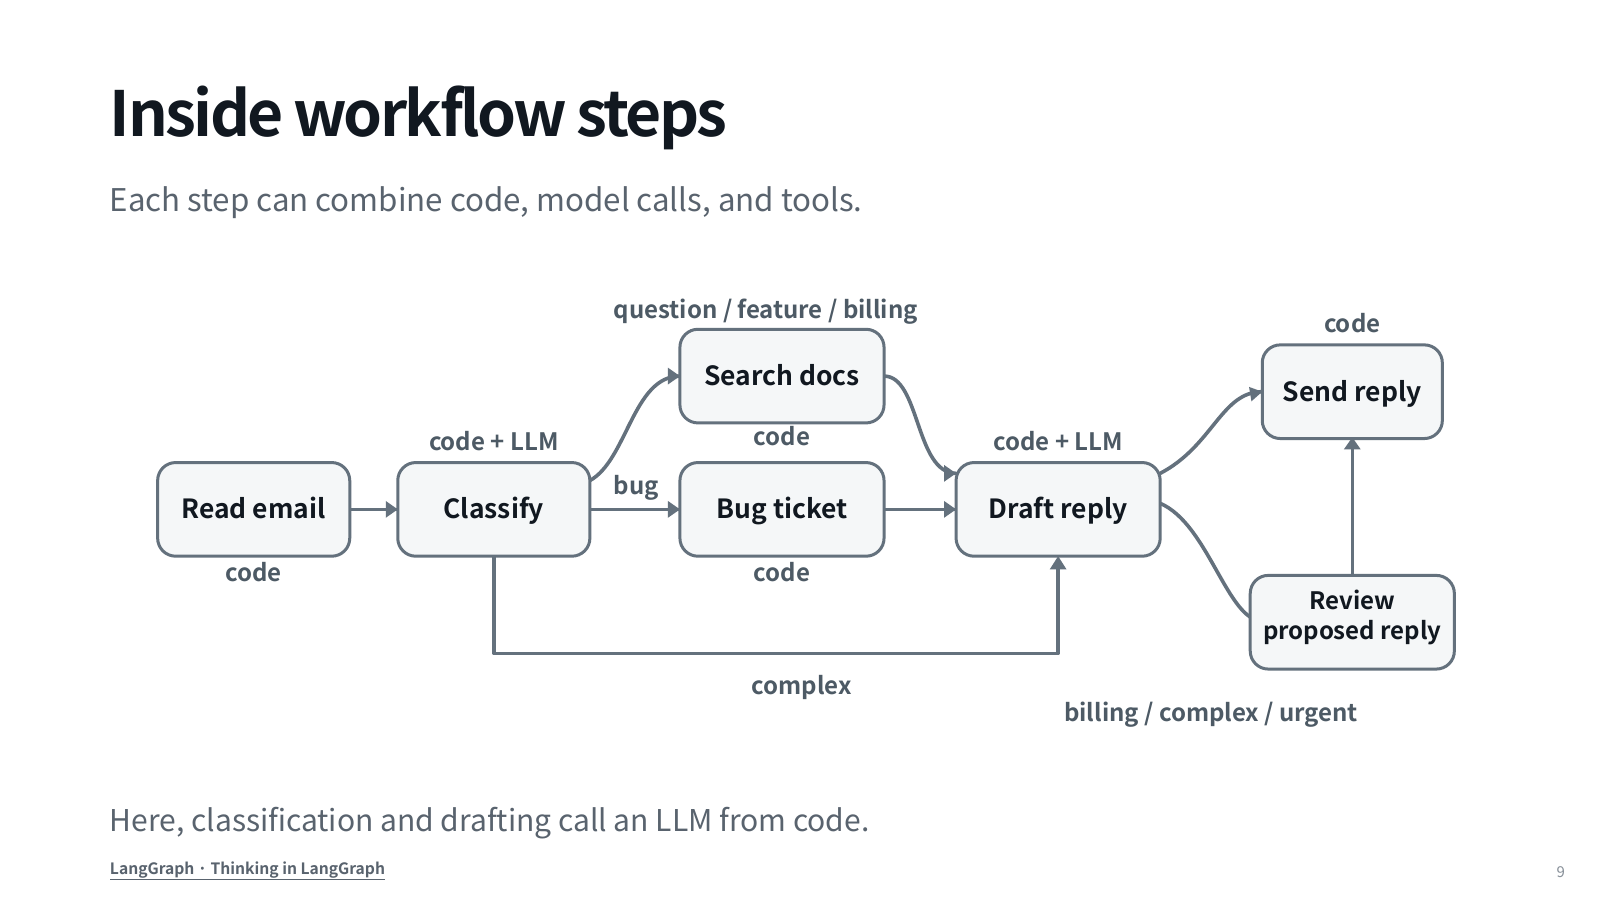
用户写“我被重复扣费,请处理”。客服流程先读邮件,再分类,检索政策,生成回复草稿,进入复核。分类和起草可以由模型完成;检索接口、状态记录、复核关口由程序约束。整个图有固定结构,不代表内部完全没有模型判断。
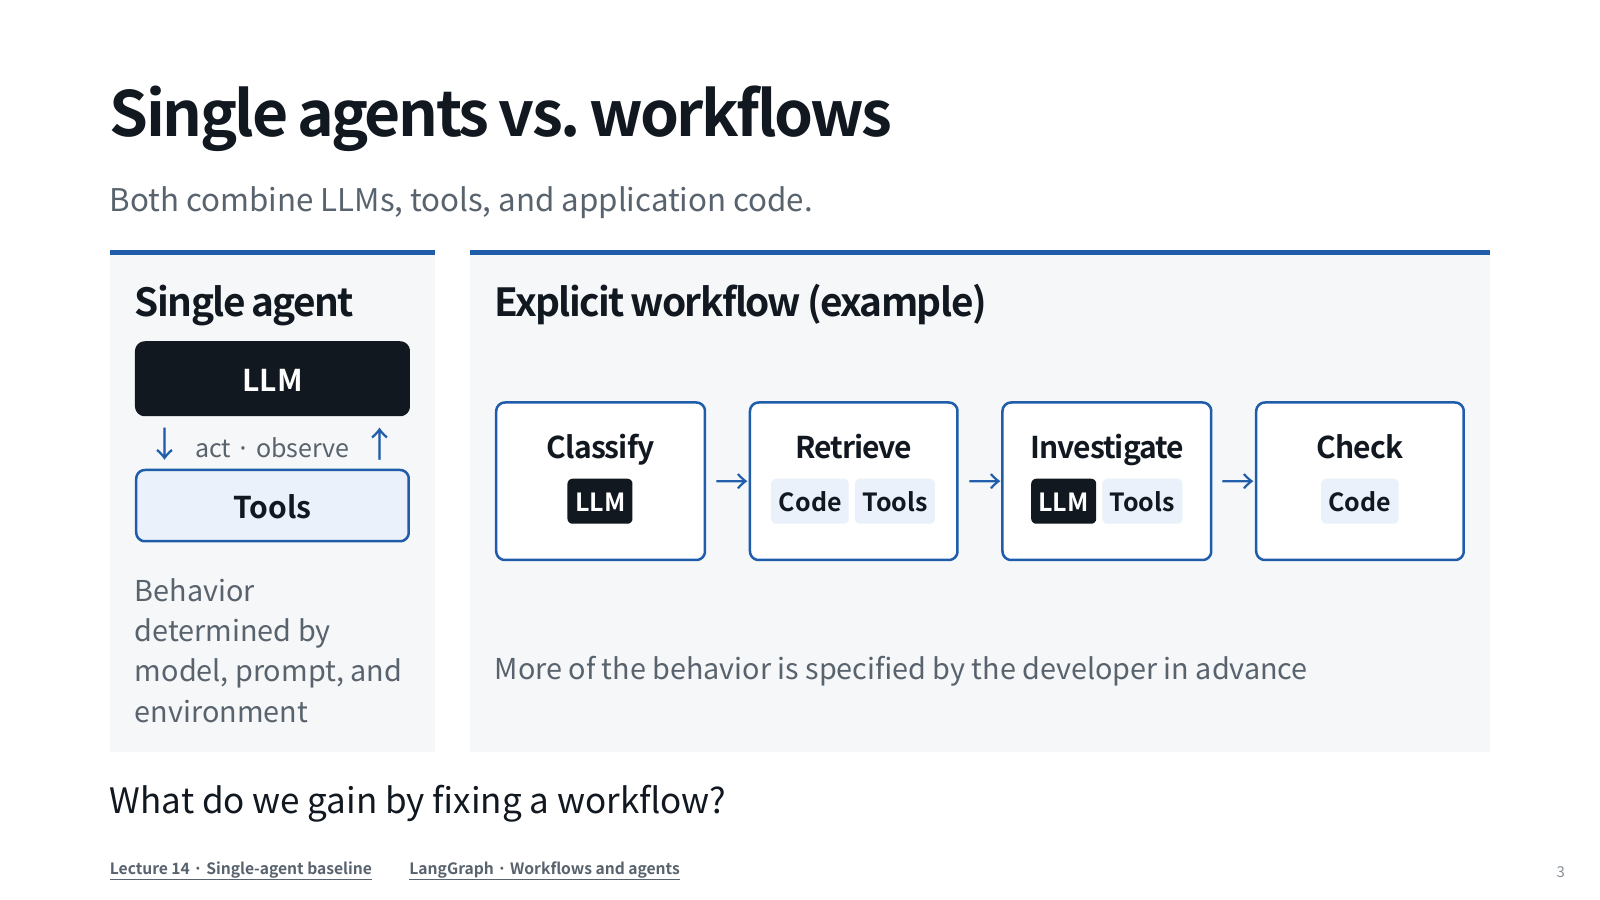
朴素的二分法是“流程固定就不是 Agent,所有东西自由决定才是 Agent”。这种争论容易遮住实际问题:谁决定下一步、哪里允许调用工具、哪里强制检查、失败时回到哪里?课程把单 Agent 与显式工作流放在一起比较,因为二者都组合语言模型、工具和应用代码,只是提前规定的行为比例不同。
从分类开始,逐步看控制权
读取邮件是确定的输入操作。分类模型给出 category 和 urgency,但输出需经过格式与允许值检查;不认识的分类不能随意落入自动发送路径。分支程序根据分类决定查知识库、建缺陷记录或转复杂处理。草稿节点根据原邮件和证据生成建议文字。最后复核节点决定是否可发送,账单和紧急事项可以按既定策略要求人工或其他明确检查。
这里给模型的自由是理解自然语言和形成草稿;不给它的自由是跳过流程规定的复核。即使模型在草稿里写“已获批准”,也不会改变程序保存的批准字段。这正是把建议和授权分开的价值。
同样的草稿,分类改变后走哪条路?
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
邮件询问导出按钮位置;分类 question,非紧急。教学规则允许经检查后自动发送。
- 1. 读取与分类
保留原邮件,模型输出 question,格式校验通过。
- 2. 检索与起草
找到文档证据,形成操作步骤草稿。
- 3. 检查路由
证据与内容检查通过,按本例规则进入发送节点。
保留原邮件,模型输出 question,格式校验通过。
先预测,再核对结果与原因
到达可发送节点这是教学工作流的明确规则,不是模型自行宣布获得权限。
节点里还可以再放一个小循环
“调查问题”可能需要多次查单、读日志和核对事实。外层图规定进入调查、获得结构化结果后再检查;内层 Agent 根据观察选择下一工具,直到满足调查结束条件或预算用尽。这样外部交付标准稳定,内部仍可以适应具体问题。
固定得更多,得到什么,又失去什么
对于字段完整、规则稳定的流程,固定节点便于单独测试:分类格式是否正确、检索是否返回证据、账单邮件是否进入复核。失败能定位到节点,还可以保存状态后恢复。相比把所有判断放进一个巨大循环,这通常更容易检查关键关口。
但遇到没有预先设计的情形,固定图可能没有正确路径。比如邮件同时涉及账单和安全事件,单一分类可能丢掉一半问题。应设计明确的未知、冲突与人工处理分支,或允许受限调查节点继续收集信息,而不是为了保持流程简单就强行塞入最近类别。
另一组对照是稳定任务与探索任务。批量处理同结构请求,固定流程很有用;寻找未知故障原因,提前列完全部工具顺序可能不现实。可组合的方法是固定输入、权限、预算和验收,开放中间调查。在设计上,适应性和可预测性是可以分布在不同位置的。
理解检查
问题一:工作流有五个固定节点,是否代表模型不能自主选择工具? 不代表。某个调查节点内部可以有行动观察循环;需要查看内部控制权,而不是只看外层节点数量。
问题二:模型把账单问题分类错了,固定工作流会自动保证安全路由吗? 不会。固定边只按得到的状态运行。需要分类验证、对敏感触发条件的额外检查、未知分支和回归样本,不能把图的确定性误当成输入判断的正确性。
问题三:为什么检查节点不直接相信草稿中的“已批准”? 因为草稿是待审查内容,批准是独立状态。若允许输出文字改写授权,复核关口就失去作用;发送必须依据实际批准与流程条件。
回扣与下一单元
我们已经把工具循环扩展为有状态、有记忆、能重规划且可组合的系统。接下来进入真实环境:同样的读取、行动和验证,放进代码仓库时为什么要先定位报错、理解依赖,再修改具体文件?