本节要解决的事:技能不是越早全部展开越好。先让模型知道有哪些入口,再按任务读步骤和细节。
三本手册,只需要其中一本
桌上有采购、代码审查、发布说明三份技能,各有一千行正文。当前任务是“检查这段 Python 代码有没有明显问题”。朴素做法把三千行全部放进每轮输入,既增加长度,也把不相关的采购确认和发布步骤带进当前任务。模型可能在正确任务里执行错误流程。
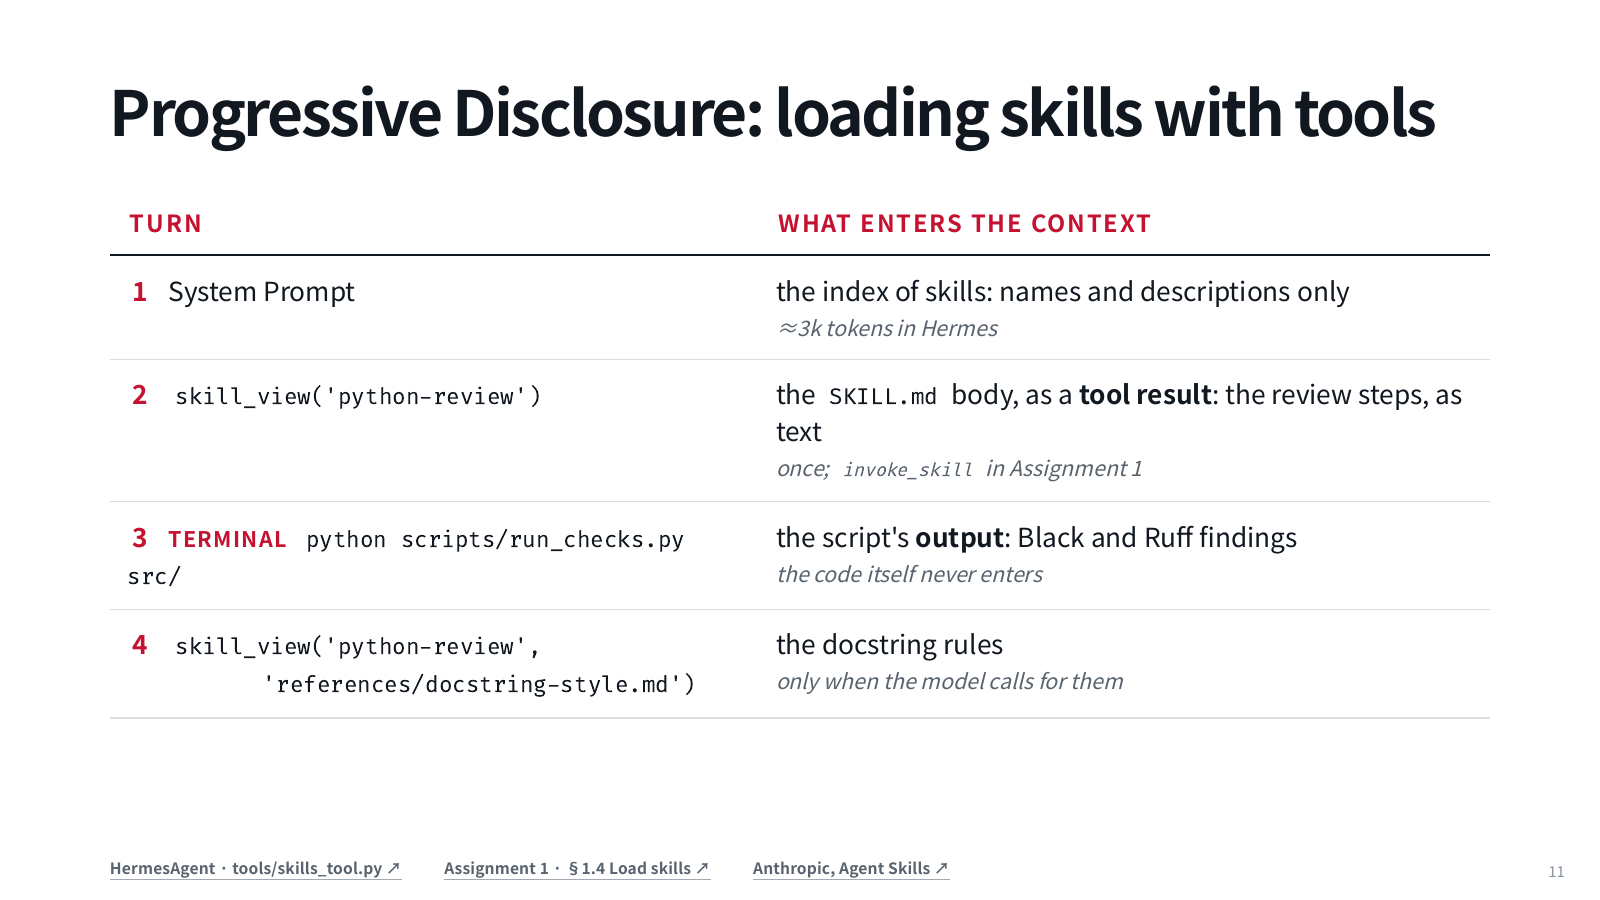
渐进加载先给三张索引卡:名称、适用场景和入口位置。模型识别代码审查适用,调用读取工具取得正文;需要文档字符串规范时再读引用文件;需要运行检查时调用脚本,并观察脚本输出。关键内容在需要时进入上下文,而不是永远不可见。
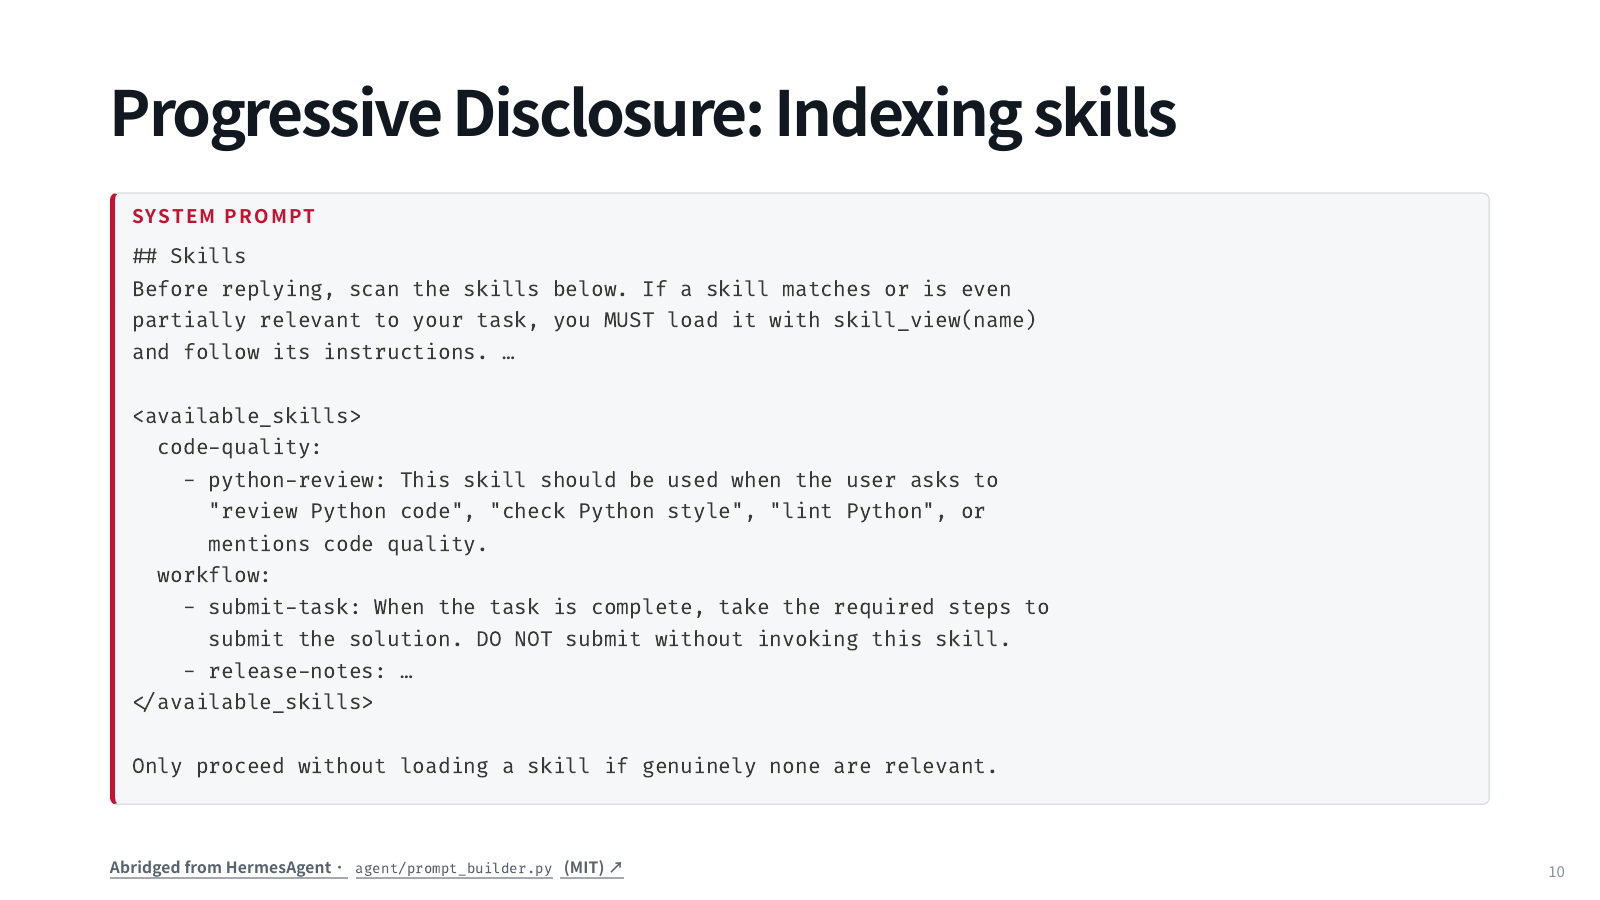
四次交互分别增加什么
第一步读取索引,知道可选技能;第二步通过工具读取选中技能的正文,正文作为工具结果回到模型;第三步按正文运行脚本,回填执行结果;第四步按需读取参考文件。每一步都有不同信息来源。脚本运行成功不代表其源代码自动被模型读过;只有把源代码或摘要作为输入返回,模型才直接看到那些内容。
用行数做一次清楚的账
为便于观察,假设索引共 12 行,三份正文各 1,000 行,额外参考文件 40 行。全量加载正文是 3,000 行;渐进方案先读 12 行,再读需要的 1,000 行,必要时另加 40 行,共 1,052 行。这是教学行数账,不是 token、成本或速度的精确测量。真实文本应经过目标分词器统计,调用工具本身也有额外开销。
如果一次任务确实同时需要三份技能,渐进加载最后仍可能读完三千行。它的好处是按相关性安排信息,不是保证任何任务都减少固定比例。若索引描述不清,省下的上下文可能以选错技能的形式付出更大代价。
只改变任务,跟着加载路径走
先做预测,再逐步展开。这里是固定规则的教学回放,不是真实模型测评。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
索引 12 行;三份正文各 1,000 行;文档规范参考 40 行。
- 1. 选入口
任务涉及 Python 审查,选 python-review。
- 2. 读正文
载入该技能的 1,000 行,累计 1,012 行。
- 3. 读细节
遇到文档规范问题再加 40 行。
任务涉及 Python 审查,选 python-review。
先预测,再核对结果与原因
本例累计读取 1,052 行其他两份不相关正文没有进入当前输入。
省上下文之前,先保证加载正确
一份好索引应该说明适用条件与边界。“用于代码”太宽,“审查 Python 风格、可维护性和静态检查结果”更可判断。正文还应说明输入、输出、可用工具、检查标准和异常处理。索引只是导航,不能用它代替正文中的关键限制。
比较两个变化:技能名字相同但正文从 v1 升为 v2,执行行为可能变化;正文不变但索引适用条件改了,任务可能根本不再加载它。回归时需要同时记录选择结果与加载版本,不能只看最终答案。对常用脚本,也要把脚本版本和输出关联起来,避免正文已经更新、执行器仍旧。
渐进加载不会自动消除不可信内容。读取外部参考文件时仍要判断它是证据、示例还是可执行规则;不能因为文件被某份技能引用,就把其中任意字符串当作更高优先级指令。技能可以指导任务,但不能凭自身文字扩大用户授权。
理解检查
问题一:索引说明“代码审查”,能否不看正文直接猜步骤? 不能把这种猜测当作遵循技能。索引用于选择,正文才给出具体流程与限制;若加载失败,应明确处理缺失,而不是假装读过。
问题二:运行脚本后,模型是否自动知道脚本每一行实现? 不会。通常进入上下文的是运行结果。需要理解实现时必须显式读取;运行结果也不能证明脚本没有任何错误。
问题三:渐进加载必定更快、更便宜吗? 不必定。小任务可能被额外加载调用增加延迟,跨多技能任务可能最终读取全部内容。应衡量实际选择准确率、总输入、工具耗时与任务成功。
下一问
人可以手写技能,Agent 也可以从一次经历归纳。下一节检验“重试后成功”这条经验:哪些部分能迁移,哪些只是碰巧奏效?