01 / 文件读完了,但用户的问题还没回答
接着上一课。用户问:“我需要 3 盒红笔。库存够吗?如果够,一共多少钱?”程序执行读取,拿到了下面这份数据:
{"item":"红笔","stock":5,"unit_price":12,"currency":"CNY"}现在暂停。这个返回值告诉你有 5 盒、每盒 12 元,却没有说用户要几盒,也没有说本次要付多少钱。因为工具的工作是查库存和单价,它不负责理解用户的整段任务。
要得到“够,3 盒共 36 元”,还需要把两处信息合起来:用户任务里的 3,加上工具结果里的 5 和 12。在本课的 Agent 中,这一步交给模型完成,所以程序要带着新证据再请求模型一次。
工具执行:查到库存和单价 → 返回数据
第二次:原任务 + 新数据 → 生成回答
这里容易误会成“模型一直在线等文件读完,再接着想”。我们先采用一个更容易检查的视角:第一次生成已经返回,程序接手;第二次是带着更多输入发起的一次新生成。 模型可以还是同一个,权重也没有因为读了文件而改变。
如果第二次只发送库存 JSON,删掉用户原话,模型还能知道应该算 2 盒还是 3 盒吗?
展开解释
不能仅凭这份 JSON 确定用户需求。stock: 5 表示现有库存,不表示用户想买 5 盒。用户任务和环境数据是两个不同来源,不能拿一个替代另一个。
02 / 第一次请求里,到底装了什么?
先把“提示词”这个大词拆开。程序向模型提交的输入通常不止用户一句话。在这个例子中,有三种内容:规则、任务、可用工具说明。
system:根据工具证据回答;未知时说明缺少什么。这里只查询,不下单。
user:我需要 3 盒红笔。库存够吗?如果够,一共多少钱?
名称:read_inventory
用途:读取指定商品的库存与单价。
参数:item,商品名称,字符串。
这里没有 stock: 5,也没有 unit_price: 12。
工具说明像一张“可以向谁问什么”的说明卡。它让模型知道有一个查询入口、该填什么参数;提供工具说明不等于已经执行工具,更不等于把数据库内容发给了模型。
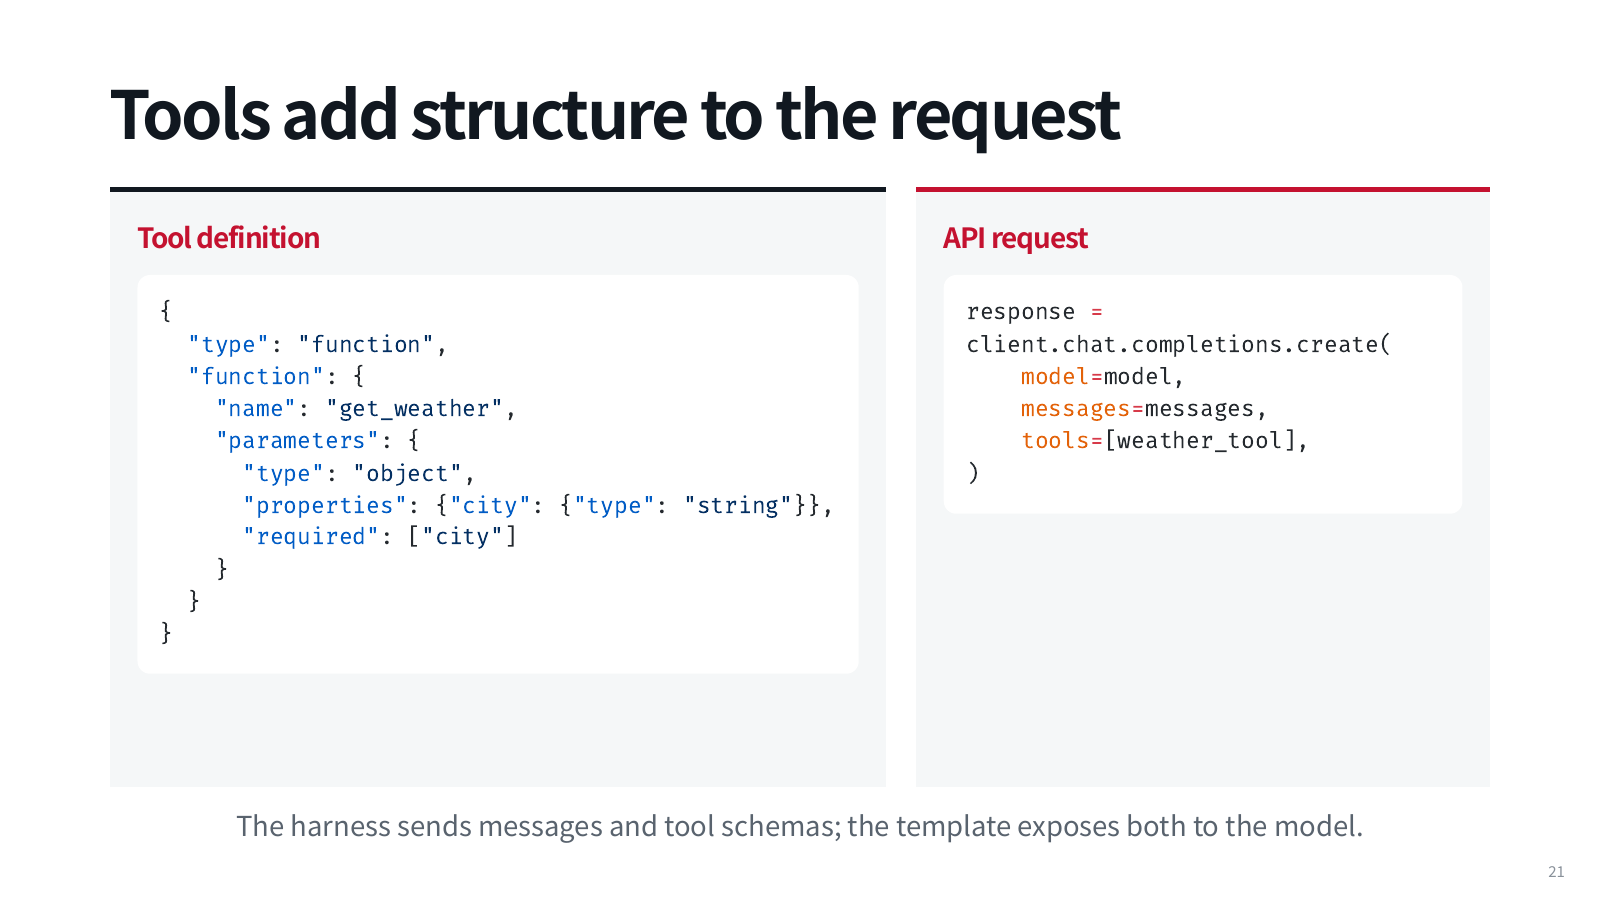
system、user 这些角色,模型真的能直接“看见”吗?
在程序里,它们是带角色的消息对象。送进模型前,聊天模板会把这些对象组织成模型可处理的 token 序列。角色标记帮助区分规则、用户要求和先前输出。你现在不用记具体特殊符号,先理解:一组结构化消息最终会成为一次模型生成所依据的输入。
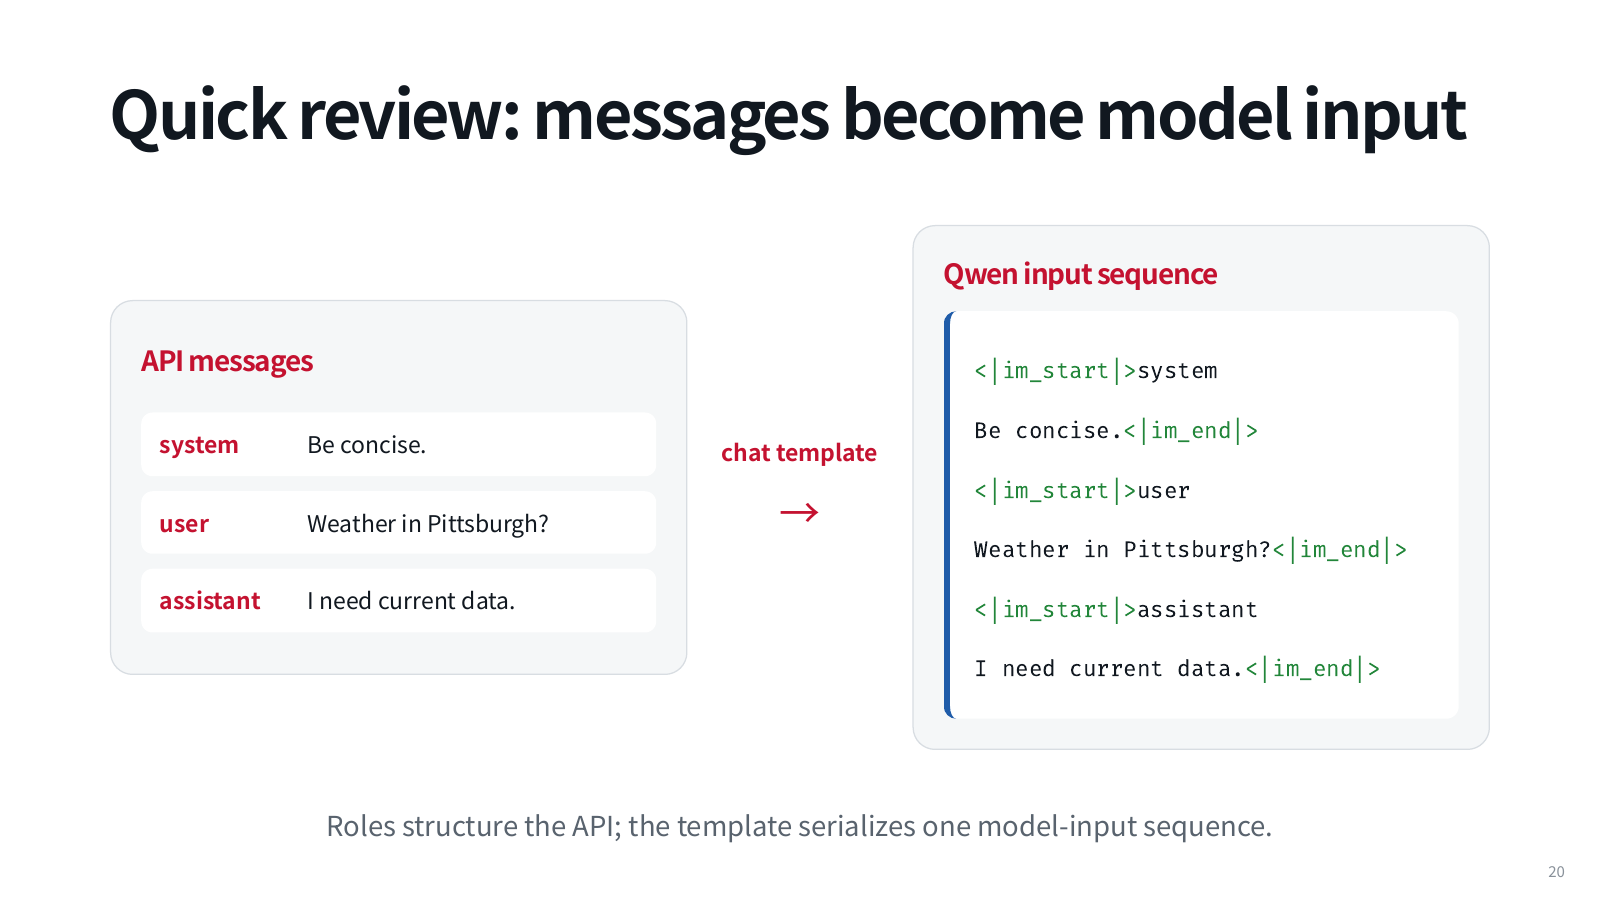
因此,第一次输入的清单可以写成:
messages₁ = [system 规则, user 原任务]
tools     = [read_inventory 的说明与参数约束]
这两行里没有实时库存,模型此时合理的下一步是请求查询,而不是把一个猜测当作查到的数据。
03 / 第一次输出是“请去查”,不是“查到了”
第一次生成返回后,程序收到一条 assistant 消息。它携带一个工具调用请求。下面采用与原课相近的 Chat Completions 风格展示,省略外层响应元数据;这是一份教学消息,不是可直接运行的完整 API 示例。
{
  "role": "assistant",
  "content": null,
  "tool_calls": [{
    "id": "call_stock_1",
    "type": "function",
    "function": {
      "name": "read_inventory",
      "arguments": "{\"item\":\"红笔\"}"
    }
  }]
}
这段可以从外到内读:
role: assistant:这是模型这一轮产生的消息,不是用户又说了一句话。name: read_inventory:它请求调用哪个工具。arguments:这一次想查“红笔”。在这个表示法中,参数是一个 JSON 字符串,程序需要解析后再校验。id: call_stock_1:这次请求的配对标识。之后返回的结果要指向它。不要把 ID 当成权限凭据。
content: null 只表示这个例子没有同时输出普通回答文字。它不表示“什么都没输出”:有意义的输出在 tool_calls 中。
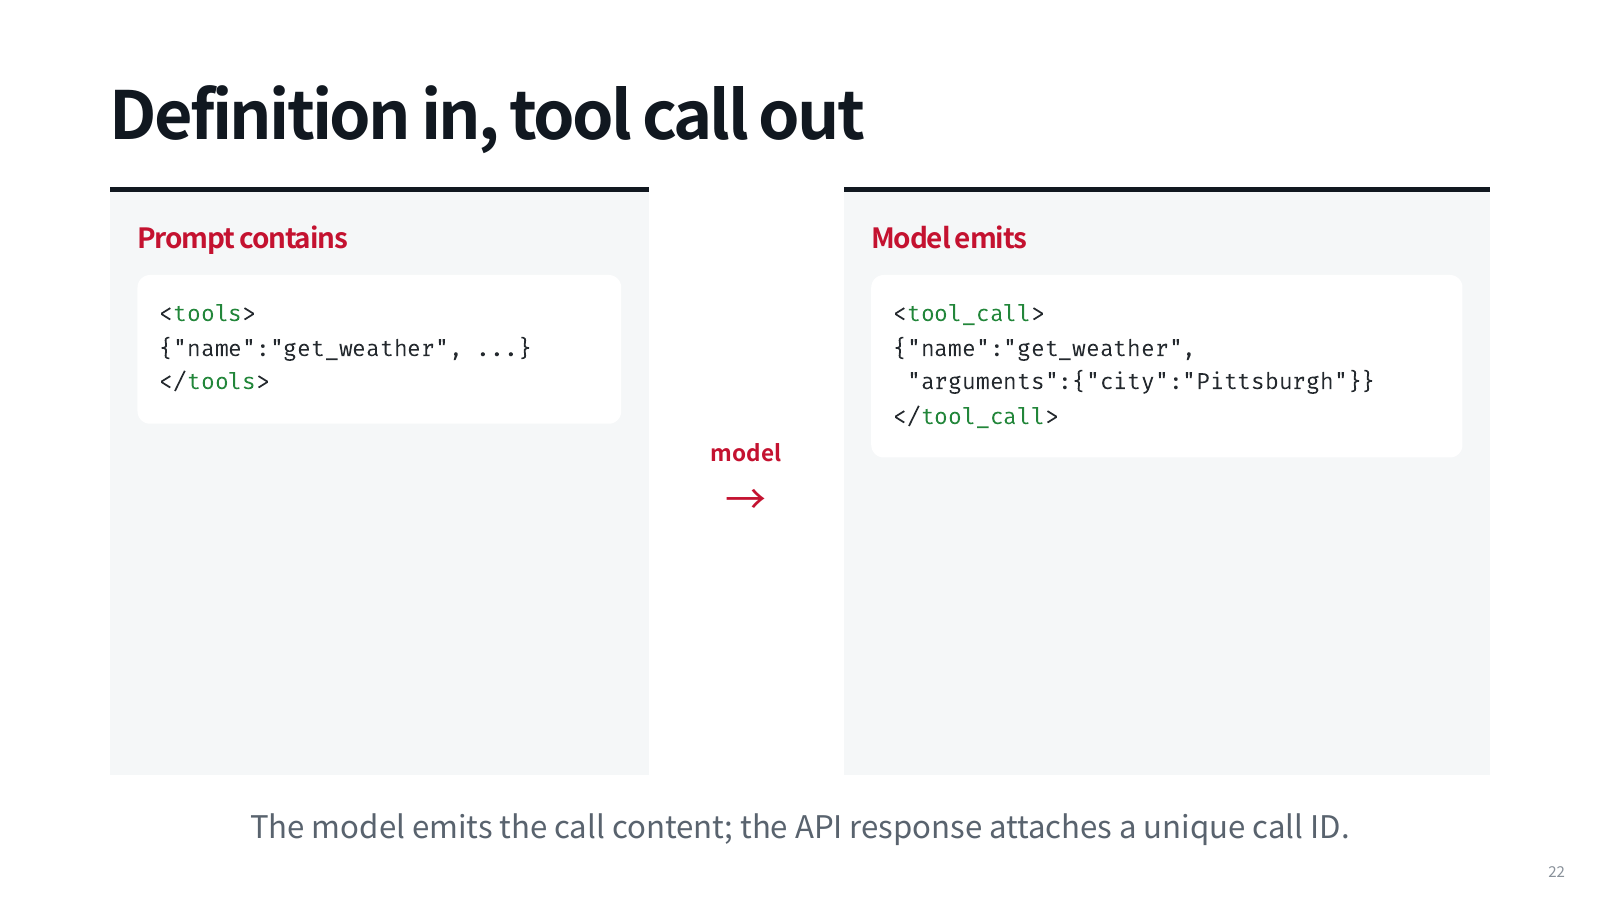
接下来轮到程序,而不是第三个模型
宿主程序识别请求、查找工具、解析与校验参数,再执行读取。工具返回库存记录。宿主将结果包成一条新的消息:
{
  "role": "tool",
  "tool_call_id": "call_stock_1",
  "content": "{\"item\":\"红笔\",\"stock\":5,\"unit_price\":12,\"currency\":\"CNY\"}"
}这不是一次模型生成。role: tool 表明内容来自工具执行路径;程序把返回值放进了 content。本例读文件这一步只增加工具执行次数,不增加模型调用次数。 其他系统的工具内部也可能调用模型,那就需要分开统计,本课没有这种嵌套。
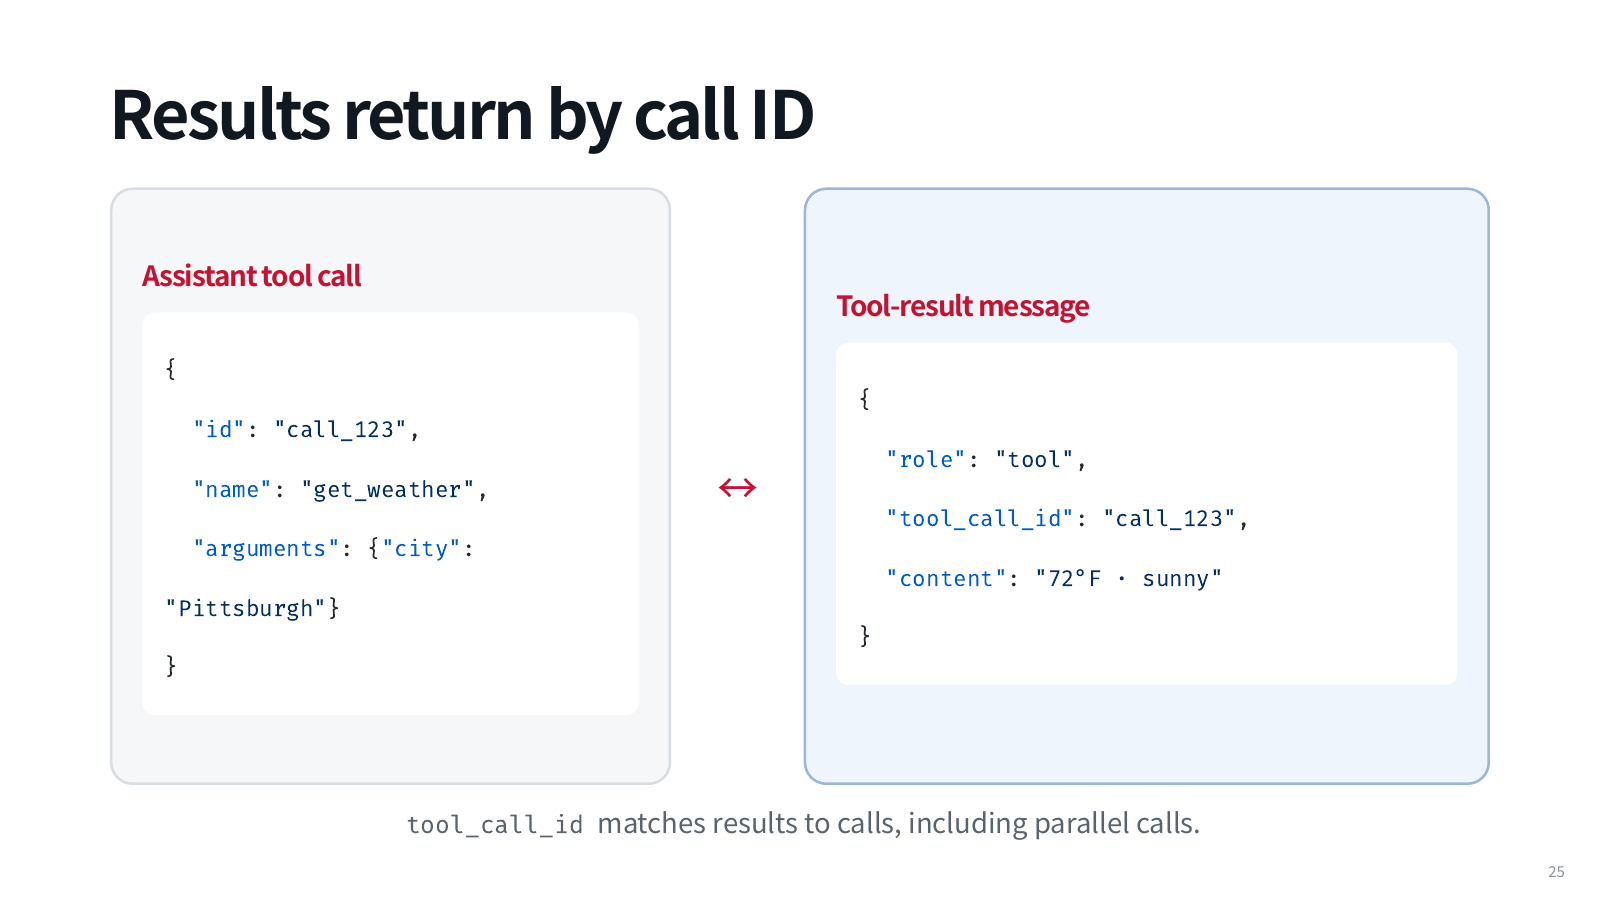
04 / 第二次输入,不是把第一次扔掉重来
现在宿主手里有了四条消息。最小的拼接动作是:保留第一次输入,追加第一次输出,再追加工具结果。
- system · 保留规则
继续按证据回答。这里仍然只是查询,没有授权下单。
- user · 保留原任务
用户需要 3 盒,并且询问库存是否够、如果够要多少钱。
- assistant · 追加刚才的工具请求
记录调用 read_inventory,参数 item 为红笔,ID 为 call_stock_1。
- tool · 追加配对的返回结果
工具结果指向 call_stock_1,提供库存 5、单价 12。
+ assistant 的工具请求
+ tool 的返回结果
这次请求仍提供工具说明,以便模型在需要更多信息时继续选择工具。不过在当前数据下,它已有足够证据生成答案:5 ≥ 3,所以够;3 × 12 = 36,所以共 36 元。
注意,此时还没有把“36 元”放进输入。最终回答是第二次生成的输出,不是我们预先塞进 messages₂ 的答案。 工具结果里的 12、任务里的 3,共同支持这一步计算。
为什么看起来像一场连续对话?
因为程序把前面的消息组织进后一次输入,用户看到的又是同一个对话窗口。连续性来自上下文的保留,不意味着模型会自动访问程序刚刚拿到的数据。某些服务允许用会话 ID 或前一响应 ID 延续上下文,缓存也可能减少重复计算;这些封装不会取消“新观察必须进入后续推理上下文”这个条件。
第二次调用也不是训练。我们改变的是本次生成可用的信息,没有在这个实验中改模型权重。至于实际系统怎样压缩长历史、复用缓存,留到上下文单元再展开。
05 / 亲自展开两次调用,不只盯着最后一句话
先逐步走完正常情况。左侧一直保留第一次输入,右侧显示第二次输入怎样组成;下面分别显示第一次请求、工具结果和第二次回答。蓝色标出新增的 assistant 请求,绿色标出新增的 tool 结果。手机上两份输入上下排列。
同一个模型,两份不同的输入
固定规则的教学回放,不发送 API 请求。这里数的是模型生成请求;一次工具执行另计。
用户说需要 3 盒。此时只有任务,没有库存记录;工具说明告诉模型能查什么。
第一次模型输入 一直保留,方便比较
第二次模型输入 尚未组装
工具执行后,观察这里怎样多出两条消息。
两次请求共用的工具说明(tools)
说明只列接口,不包含查询结果。模型名称与生成参数从教学视图中省略。
[
  {
    "type": "function",
    "function": {
      "name": "read_inventory",
      "description": "读取指定商品的库存和单价。",
      "parameters": {
        "type": "object",
        "properties": {
          "item": {
            "type": "string"
          }
        },
        "required": [
          "item"
        ],
        "additionalProperties": false
      }
    }
  }
]
第一次模型输出 · 请求
等待第一次生成。
工具返回给程序 · 数据
还没执行工具。
第二次模型输出 · 回答
尚未发出第二次调用。
消息借用原课的 Chat Completions 风格表示。错误处理与回答是本课规则,不能代表真实模型必然这样回答;缺少工具结果由本课宿主检查拦截。
对照一:只把“需要 3 盒”改成“需要 2 盒”
工具请求仍是查红笔,工具仍返回库存 5 和单价 12。改变的是 user 消息里的数量,最终价格变成 2 × 12 = 24。这说明用户目标和环境数据分别从不同消息进入判断。不要为了适配用户需求,偷偷把库存数据也改掉。
对照二:漏掉工具结果
保留 assistant 请求,却不追加对应的 tool 消息。此时右侧的消息数组停在“我请求查询”这一步,没有“我查到了什么”。本课宿主在提交前拦截这份不完整消息,所以模型调用数停在 1;画面显示的是宿主的停止原因,不是一次新的模型回答。
很多工具调用协议要求调用与结果正确配对。真实接口可能拒绝不完整请求;即使某种接口接受了缺少观察的输入,也不代表模型已知道库存。不要把上一课“没看到结果就说明未知”的概念回放误解成“任何 API 都能直接发送一个没配对的工具请求”。
对照三:保留结果,漏掉原任务
这次请求与结果配对都在,但 user 原任务被移除了。模型能看到库存和单价,却没有用户需要几盒这个依据。本课回放会询问数量,而不是擅自用库存 5 作为购买数量。有数据,不等于有足够的任务上下文。
对照四:工具读回的是错误
返回 error 仍然是一条可回填的观察:它告诉下一次模型调用“没有读到”。程序不应该把失败改成 stock: 0,因为那会把未知伪装成确定的缺货。第二次模型可以解释失败或请求重试;本课按“说明错误后停止”的规则演示。
06 / 第二次输出以后,循环怎样停?
“两次”是这个小任务刚好走过的次数,不是 Agent 的固定规定。第一次可能直接给出答案;第二次也可能请求另一个仓库的数据。宿主检查本轮输出:如果还有工具请求,就执行、回填、再生成;如果是可交付的最终回答,就结束这轮任务。
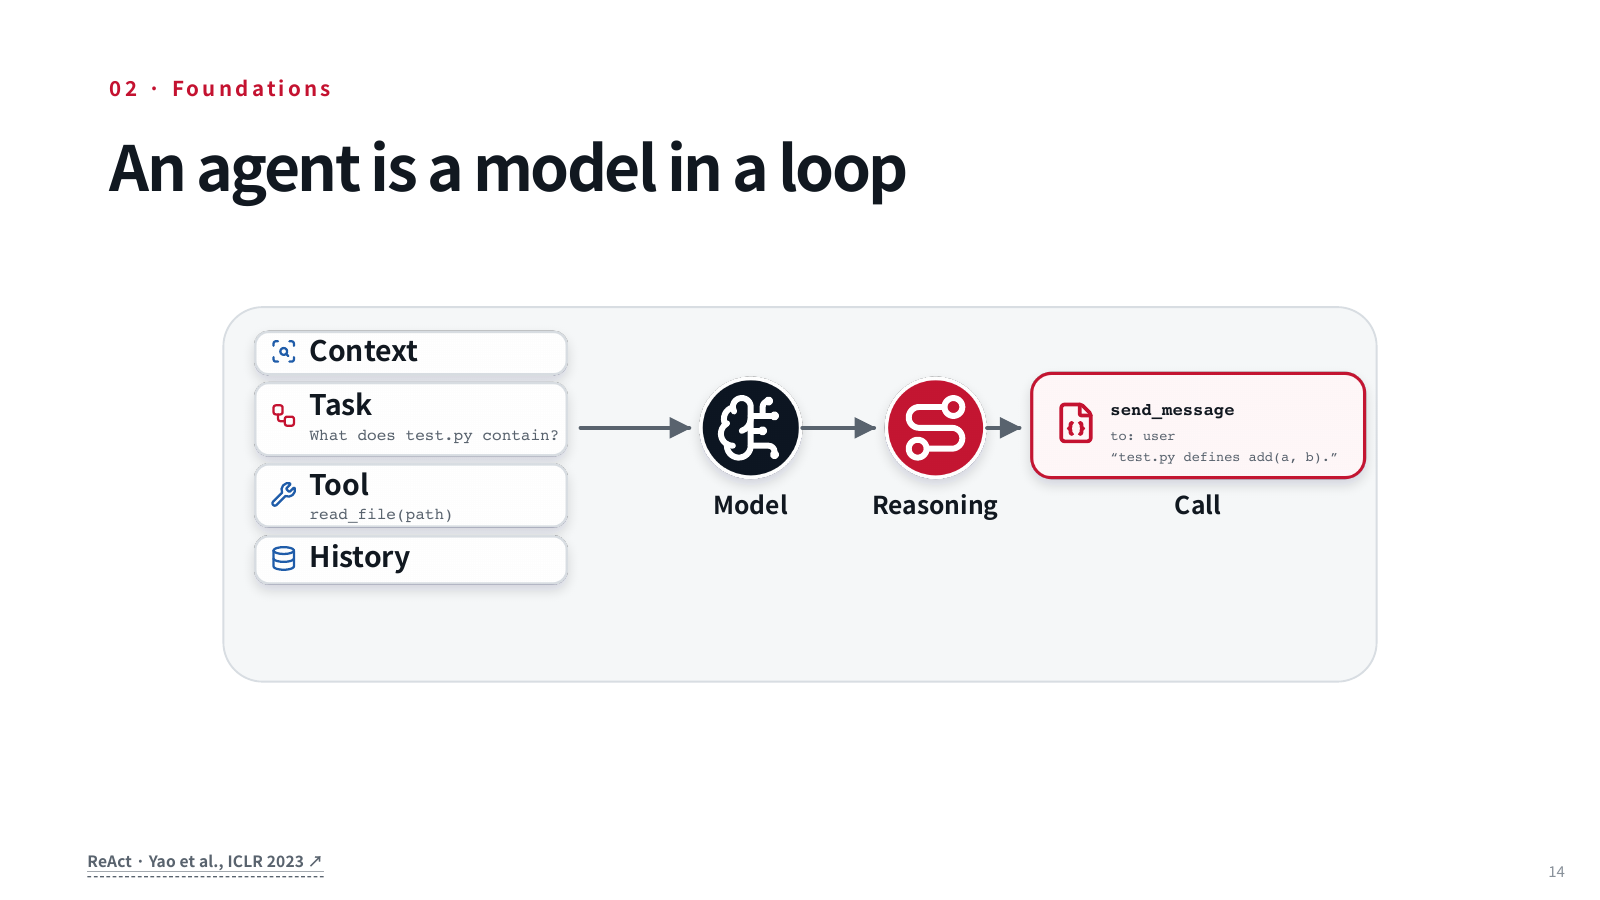
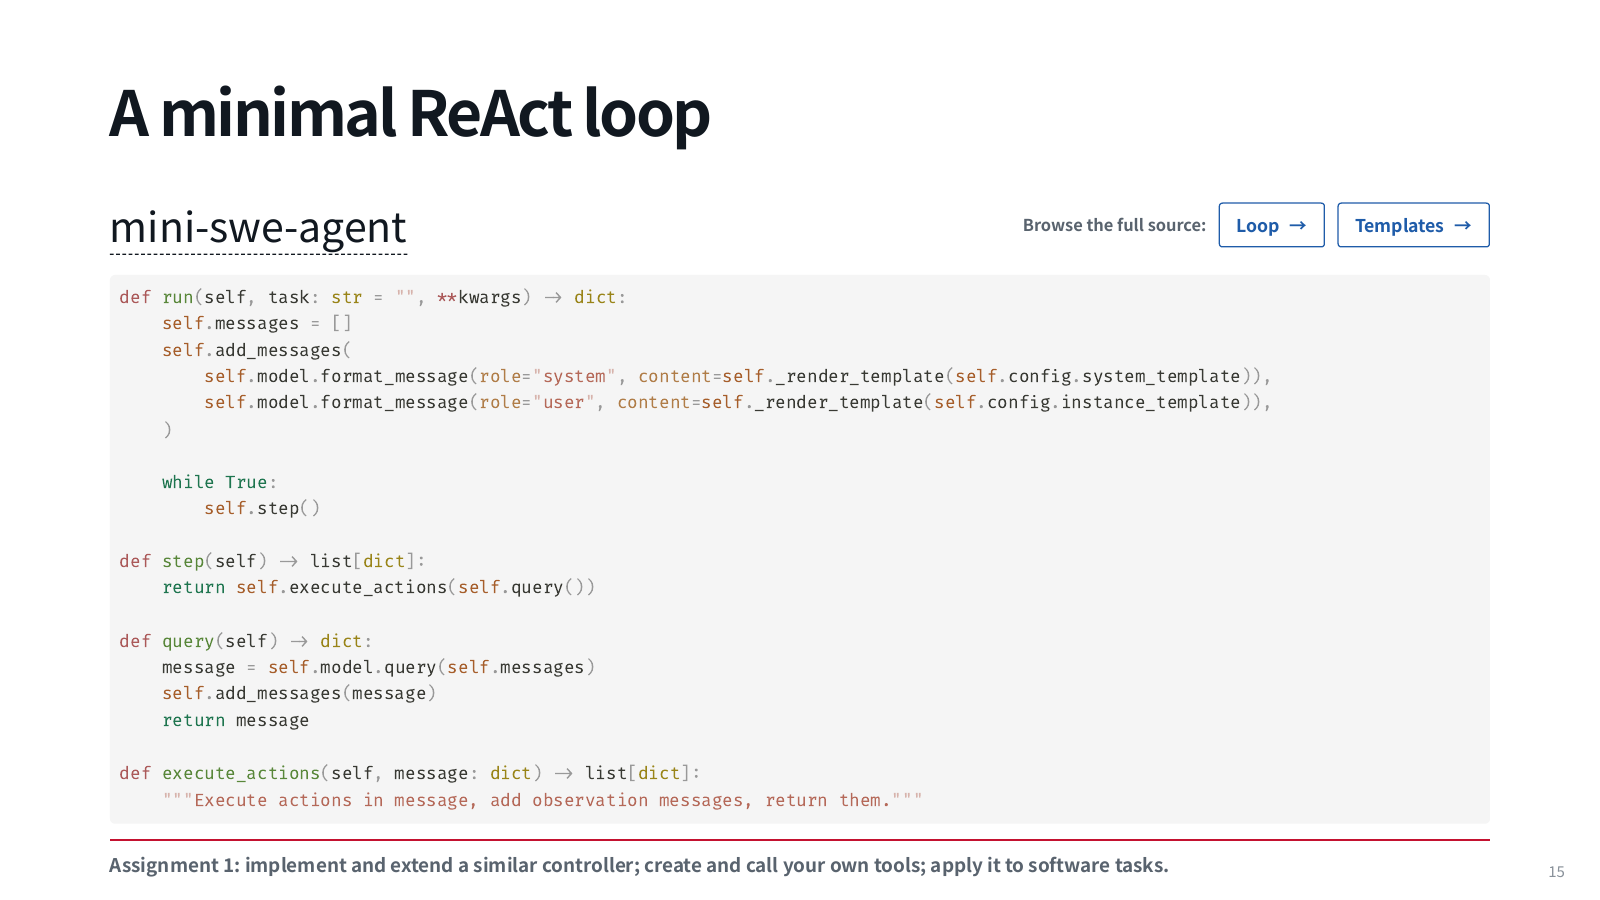
为了把这个边界讲清楚,本课的控制逻辑可以写成下面的伪代码。它是教学补充,不是原课源码的逐字复制:
初始化 messages = [规则, 用户任务]
模型调用数 = 0

只要模型调用数还没到上限:
    生成 = 请求模型(messages, 工具说明)
    模型调用数 += 1
    保存生成的 assistant 消息

    如果没有工具请求:
        展示生成的最终回答,结束

    逐个校验并执行工具请求
    为每个请求追加对应的 tool 结果或明确错误
    检查消息配对完整,再进入下一轮

如果因为上限退出:
    报告“预算已用完,任务可能未完成”
回到实验,把“模型调用上限”从 2 改成 1。第一次请求和工具执行仍然会发生,第二次消息也能被组装出来,但第二次模型调用不能提交。上限让程序停住,却不会替模型生成那句 36 元的回答。
本课选择在下一次模型调用之前检查预算;其他系统也可能在执行工具之前检查总费用、时间或动作预算。检查位置不同,已经发生的工作也不同,不能把这些边界混在一起。实际系统还需要超时、取消和异常恢复,这里只把调用次数这个停止条件看清。
07 / 合上实验,你能把四条消息放回正确位置吗?
输入里有 system、user、assistant、tool 四条消息,是否表示调用了模型四次?
核对解释
不是。它们可以共同构成第二次调用的一份输入。消息条数和模型请求次数不是同一个量。本例共两次模型生成、一次工具执行。
用户要 4 盒,工具返回库存 5、单价 12。第二次输入应该保留哪些信息,结论是什么?
核对解释
保留规则、包含“4盒”的原任务、查询请求及匹配的结果。5 ≥ 4,所以库存够;4 × 12 = 48 元。“4”来自 user,“5”和“12”来自 tool。仍然没有创建订单或扣减库存。
日志里工具读取成功,但模型调用数只有 1,页面显示预算耗尽。这是“模型算不出价格”吗?
核对解释
还不能这样判断。第二次模型生成根本没有发生,停止发生在宿主控制层。应先核对调用预算与提交记录,而不是直接归因于模型能力。
只把库存 JSON 接在用户问题后面,完全丢掉原来的工具请求,有什么信息会丢失?
核对解释
会丢失这条观察对应哪个动作的记录;在结构化工具协议里,还可能破坏请求与结果的配对。普通文本提示也能包含数据,但那不是同一份可追踪的工具调用历史。下一课将用两次查询进一步看错配的后果。
原课对照:这一节对应哪些页面?
本节对应两个官方讲次的一个知识主题,不等于把官方 Lecture 2 整讲压成一页。课件中的天气、文件与代码案例保留在原图中;库存例子、条件实验和中文说明由本项目编写。
- Lecture 2 · PDF 20–22 页:消息模板、工具定义、工具请求;对应本页第 2–3 节。
- Lecture 2 · PDF 25 页:请求与结果按调用 ID 对应;对应本页第 3–4 节。观看官方第二讲视频 ↗
- Lecture 1 · PDF 14–15 页:循环与最小实现;对应本页第 6 节。回看视频 24:25–28:09 ↗
原图从本地归档的官方 PDF 页面渲染,页面序号按 PDF 从 1 起算;点击原图可放大,并可打开官方 PDF 对应页。原图内容与中文改编分开展示。来源核对日期:2026-10-25。
两个工具都返回结果,模型怎么知道哪个结果属于哪个请求?
本课只有一次查询,call_stock_1 很容易对上。下一课同时查询红笔和蓝笔,把两个返回值交换,再看为什么不能仅靠消息到达顺序判断归属。