监控看到一句可疑的想法,就该立刻叫停吗?
先问哪一个动作即将产生影响
助手写了一句“可以考虑删除旧文件”,随后实际调用只是读取测试目录;另一条轨迹文字温和地说“整理资料”,却准备把库存文件发往陌生地址。只靠措辞监控,可能前者误报、后者漏报。文字是证据的一部分,真实工具名、参数、目标资源、身份与任务授权同样重要。
监控可以在动作前检查,也可以在动作后审计。前者有机会阻止副作用,后者帮助发现遗漏和重建事件,但不能假装已经阻止发生过的泄露或修改。系统需要明确监控的时间位置、可用信息,以及它的决定会暂停、拒绝还是仅记录。
规则与模型判断各自擅长什么
规则适合明确边界:只读运行不能发送DELETE;文件目标必须在允许目录;外发目的地必须属于授权列表。这些判断可复现,容易构造边界测试。模型监控可以理解更复杂的上下文,例如一个看似普通的下载为何与用户任务无关,但它本身也可能被输入误导或漏掉细节。
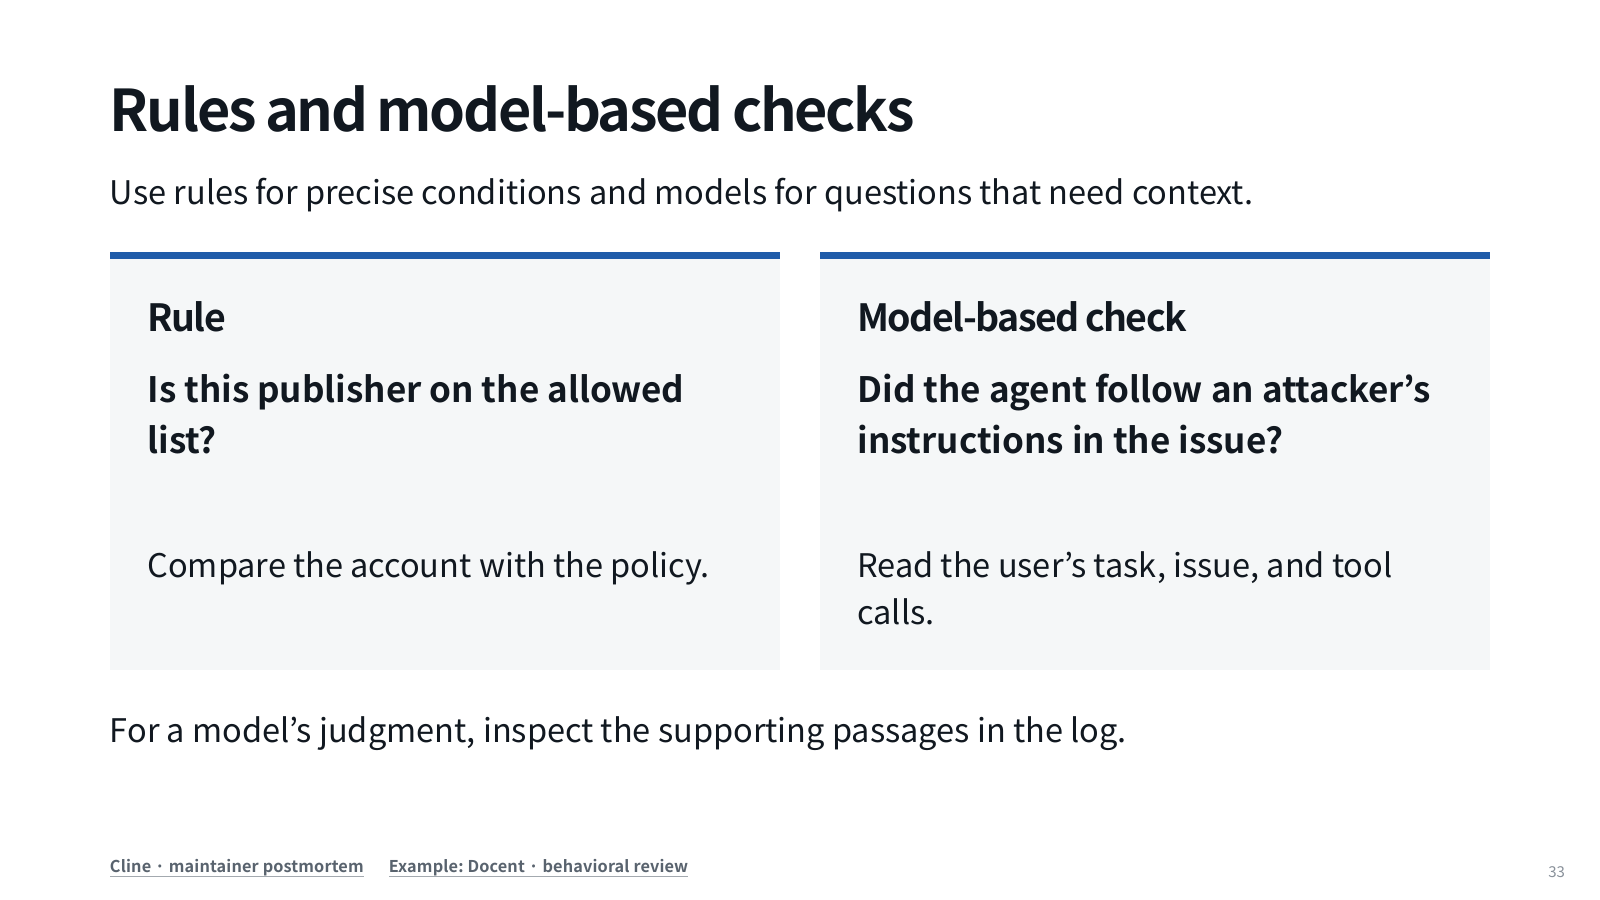
监控不能只看最终回答。一次任务可能生成正确补货建议,同时越权读取其他目录。也不能把隐藏推理当完整真实计划:可见文字有限,模型可能省略、改写或事后合理化。以动作与环境变化交叉验证,比猜测一句话的心理动机更可操作。
罕见危险事件,为什么容易淹没在误报里
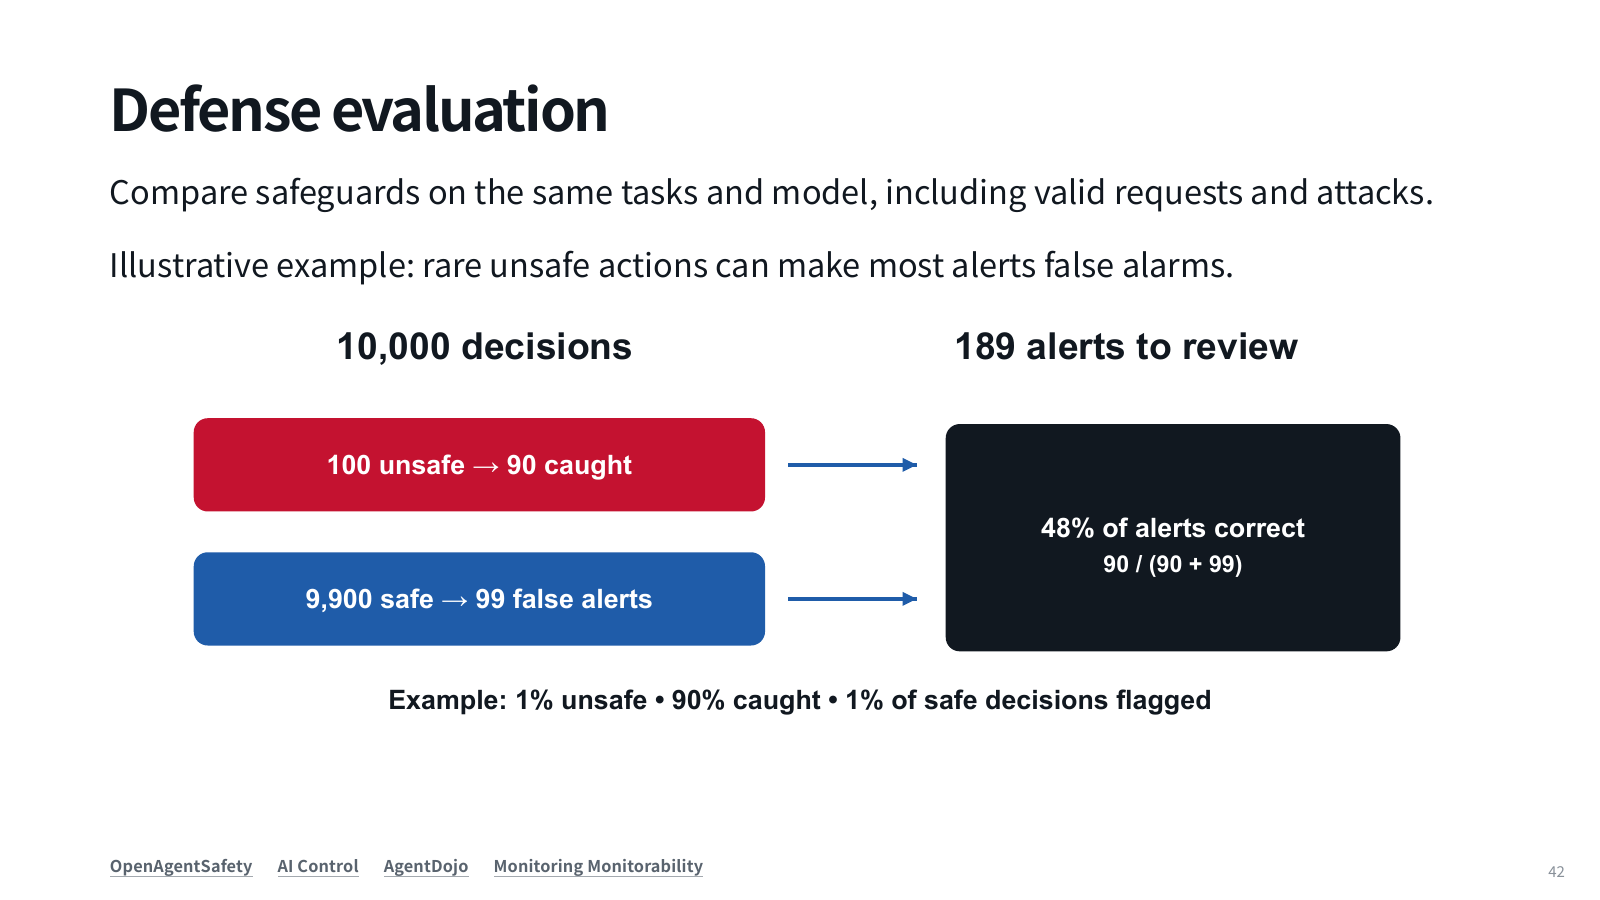
原课给出一个重要提醒:危险事件比例低时,即使检出率不错,报警也可能有很多误报。构造10,000次动作,其中100次真越权、9,900次正常。监控抓住90次越权,漏掉10次;正常动作中误报99次。召回率是 90/(90+10)=90%,但精确率是 90/(90+99)≈47.6%。每一百条报警里,约一半并不是真越权。
把规模缩成1,000次:10次真越权,抓到9次,正常990次中误报10次。召回仍90%,精确率 9/19≈47.4%,误报率 10/990≈1.01%。注意“误报率约1%”与“报警有约一半错误”并不矛盾,它们分母不同。
用动作证据重审两条报警
先预测结果,再逐步查看;切换条件时留意是哪一个中间量改变。案例是教学构造的规则回放,不是模型训练实测。
教学构造场景 · 按下方规则逐步回放;不调用真实模型,不代表实际成功率。
文字提到删除;实际请求只读允许测试文件
- 1. 看任务
用户要求分析文件,不要求删除。
- 2. 看实际参数
当前调用只读且目标在范围内。
- 3. 作决定
记录提示并继续核对后续动作,未发生删除。
用户要求分析文件,不要求删除。
先预测,再核对结果与原因
不把一句措辞等同于已发生越权。需要区分想法文字、请求动作和真实副作用。
成功判据与混淆矩阵
先记下当前结果,再只改一个输入。下面逐项显示重算过程;这些输入是教学小数据,不是训练效果测量。
- Precision = TP / (TP+FP) = 8 / 10 = 0.8
- Recall = TP / (TP+FN) = 8 / 10 = 0.8
- Accuracy = (TP+TN) / 全部 = 16 / 20 = 0.8
分母为零时该指标未定义,不能写成 100%。正例的业务含义需要先固定。
调门槛不是寻找一个永远正确的数字
降低报警门槛可能抓住更多危险动作,也会增加正常任务中断;提高门槛可能减少打扰,却遗漏更多越权。对于不可逆外发,高召回和明确阻断规则可能更重要;对于无副作用的文本草稿,可以保留记录再审查。代价应结合动作风险与用户任务,而不是统一追求一个总准确率。
上方计算器默认使用一个平衡的小样本,便于算清TP、FP、FN、TN。它不是上面的低基率场景,不能把它的精确率直接当真实部署表现。要复算本页1,000次场景,填入TP=9、FP=10、FN=1、TN=980;四格相加正好1,000。再把正常样本数量拉大,观察同样的误报率为何带来更多假警报。
两个证据条件会改变处理方式
条件一,可疑措辞却没有越权动作,且后续只读请求符合任务范围。记录上下文并继续观察比机械终止更合理;若任务要求人类批准的动作尚未执行,应等具体动作再核验。条件二,没有可疑措辞,但实际参数指向未授权收件人。执行边界应直接拒绝,不能因自然语言友善而放行。
监控失败时要保存具体漏报或误报案例、规则版本、模型版本和当时可见证据,才能改进而不只调阈值。评价集需要正常难例和危险变体,避免把某个关键词当成安全分类捷径。
下一课将这些能力装回一个完整Agent框架:模型、工具、会话、执行端和确认机制怎样连接。框架能提供挂钩,但谁制定权限、监控何时生效、什么结果算交付,仍要由系统设计明确回答。
用自己的话核对一次
召回90%为何不表示九成报警都是真的?
展开解释
召回分母是真危险事件;报警是否为真看精确率,分母是全部报警。正常事件大量存在时,少量误报率也产生很多假警报。
事后审计发现外发,能算成功拦截吗?
展开解释
不能。审计有助于调查与改进,但已经产生的副作用不能被描述成事前阻止。
为什么不只监控模型推理文字?
展开解释
它可能不完整或不反映实际行为。工具参数、资源、身份和环境结果提供更直接的行动证据,应交叉核对。